AI赋能天机学堂
目录
13StrUtil.replace(原始字符串, 要被替换的内容, 替换成什么)?
18new AssistantMessage(content) 这个调用的哪里?用没用我项目中的配置?
19基于 MySQL 和 MongoDB 两种方式,实现会话记忆,并且通过配置的方式来进行选择
23Tool执行的结果已经给了大模型,我们在Flux输出时如何获取到呢?
28如果使用es的话 那个数据是不是得从前端传来才能保存进知识库?
32@Qualifier + @RequiredArgsConstructor 的坑
33为什么向量库不在初始化ChatClient时配置,而是在使用时配置?
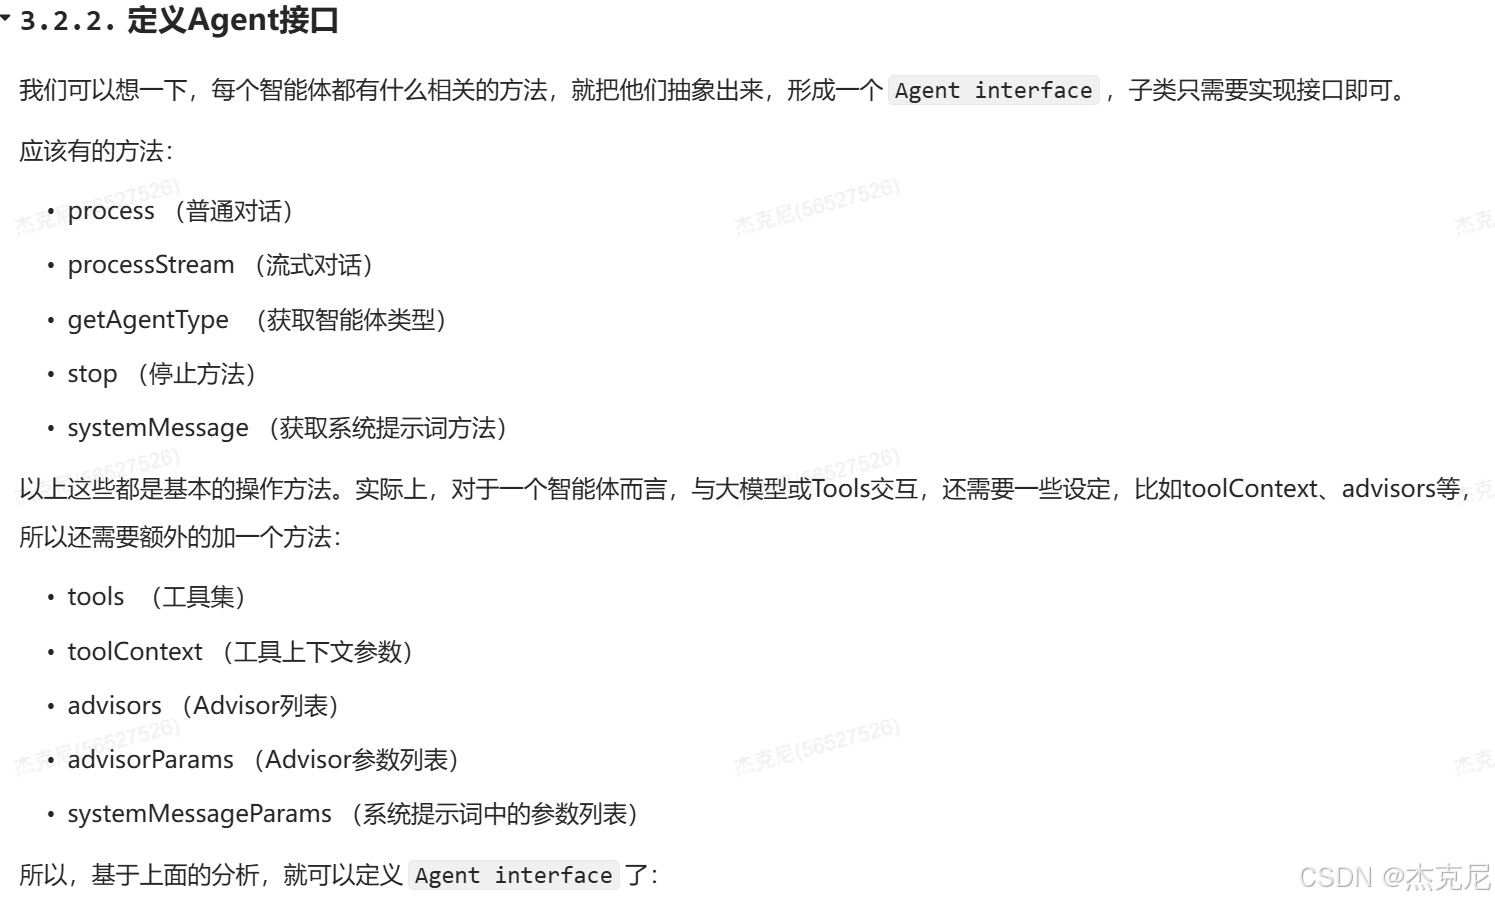
36路由工作流智能体 是怎么发挥作用的?就是那个路由智能体怎么调用其他智能体呢?
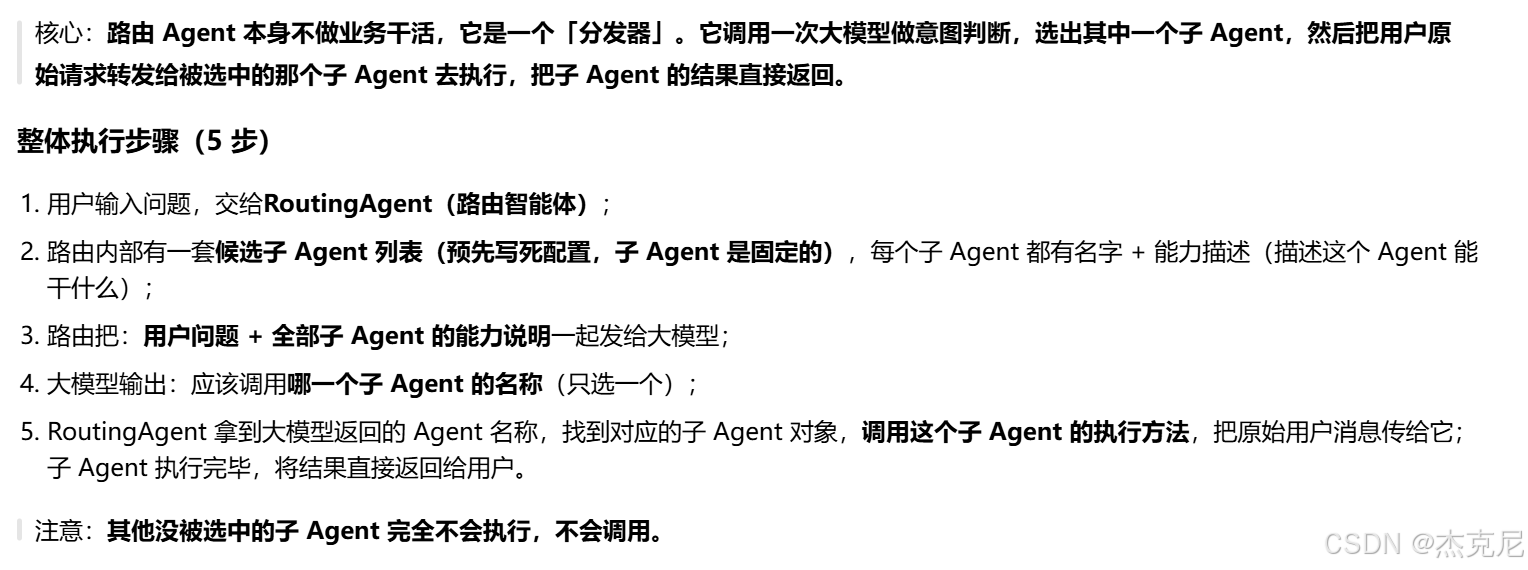
37项目中有两个类继承implements ChatService?
39问题:那要是第一轮就有"推荐个课"和"帮我下单" 它能解决吗?
41assert chatResponse != null;作用?
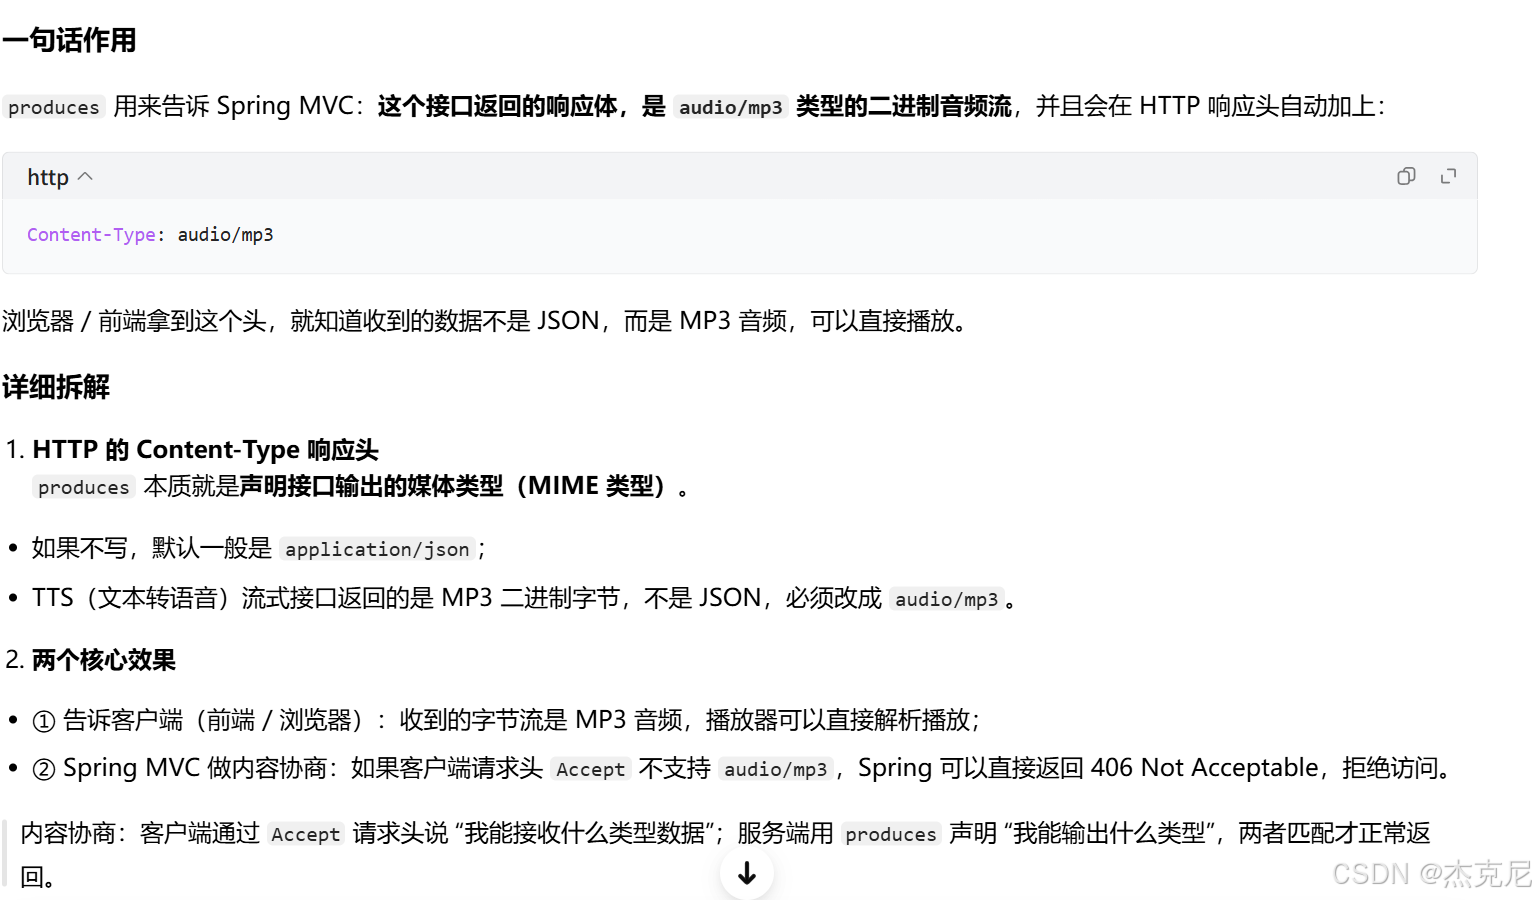
49@PostMapping (value = "tts-stream", produces = "audio/mp3") 里面的 produces 属性有什么用?
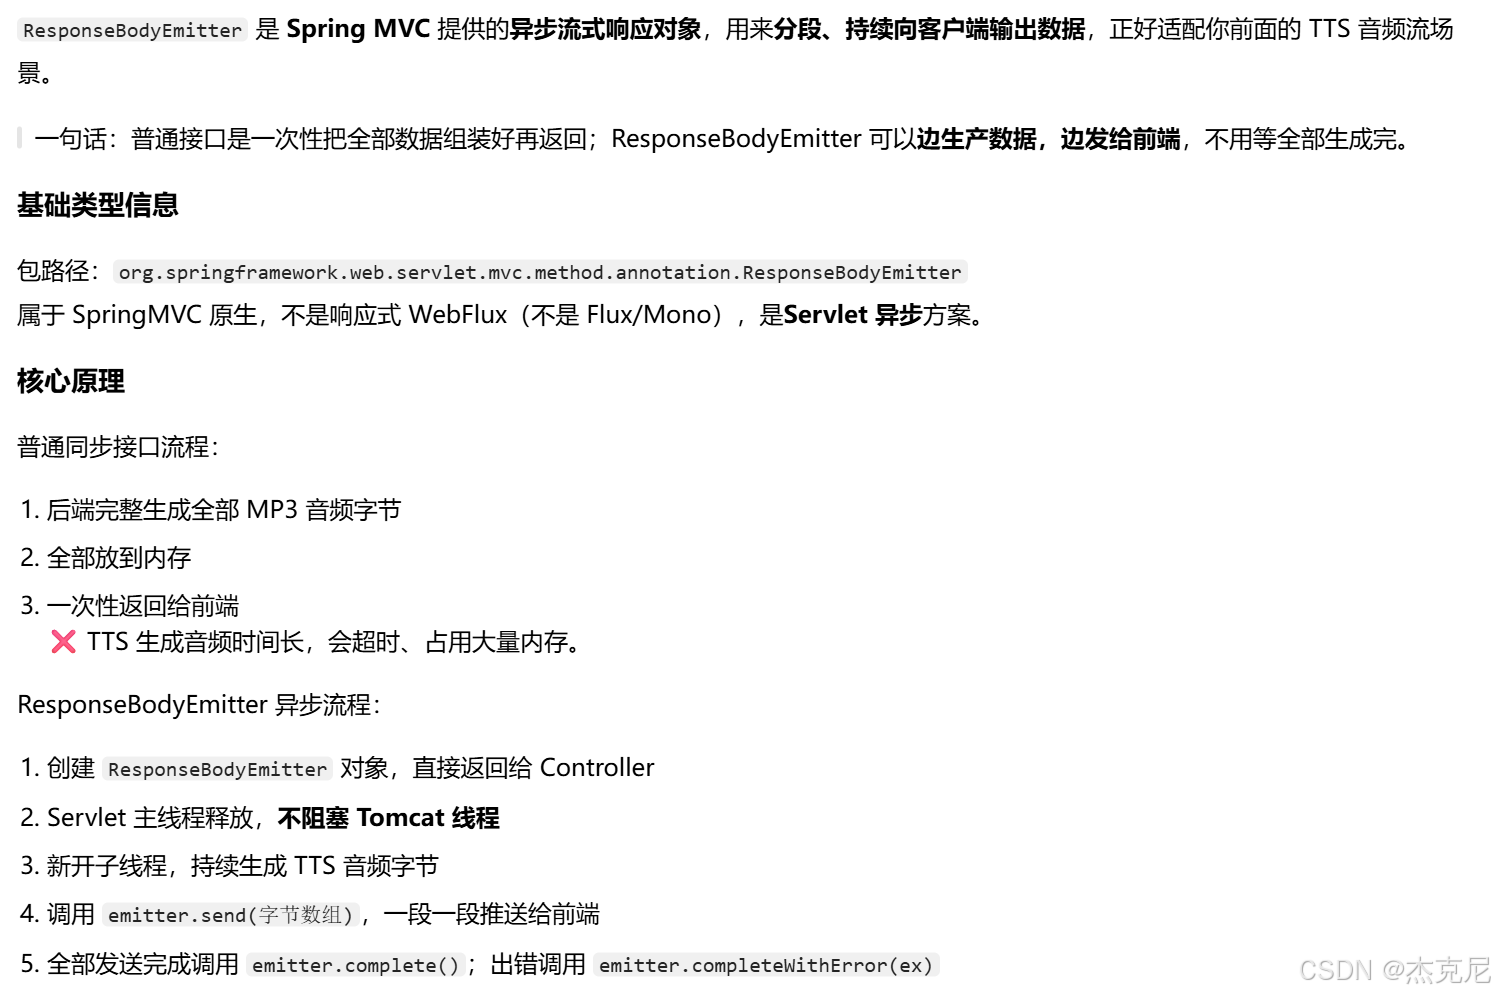
52ResponseBodyEmitter 这个是什么类型?
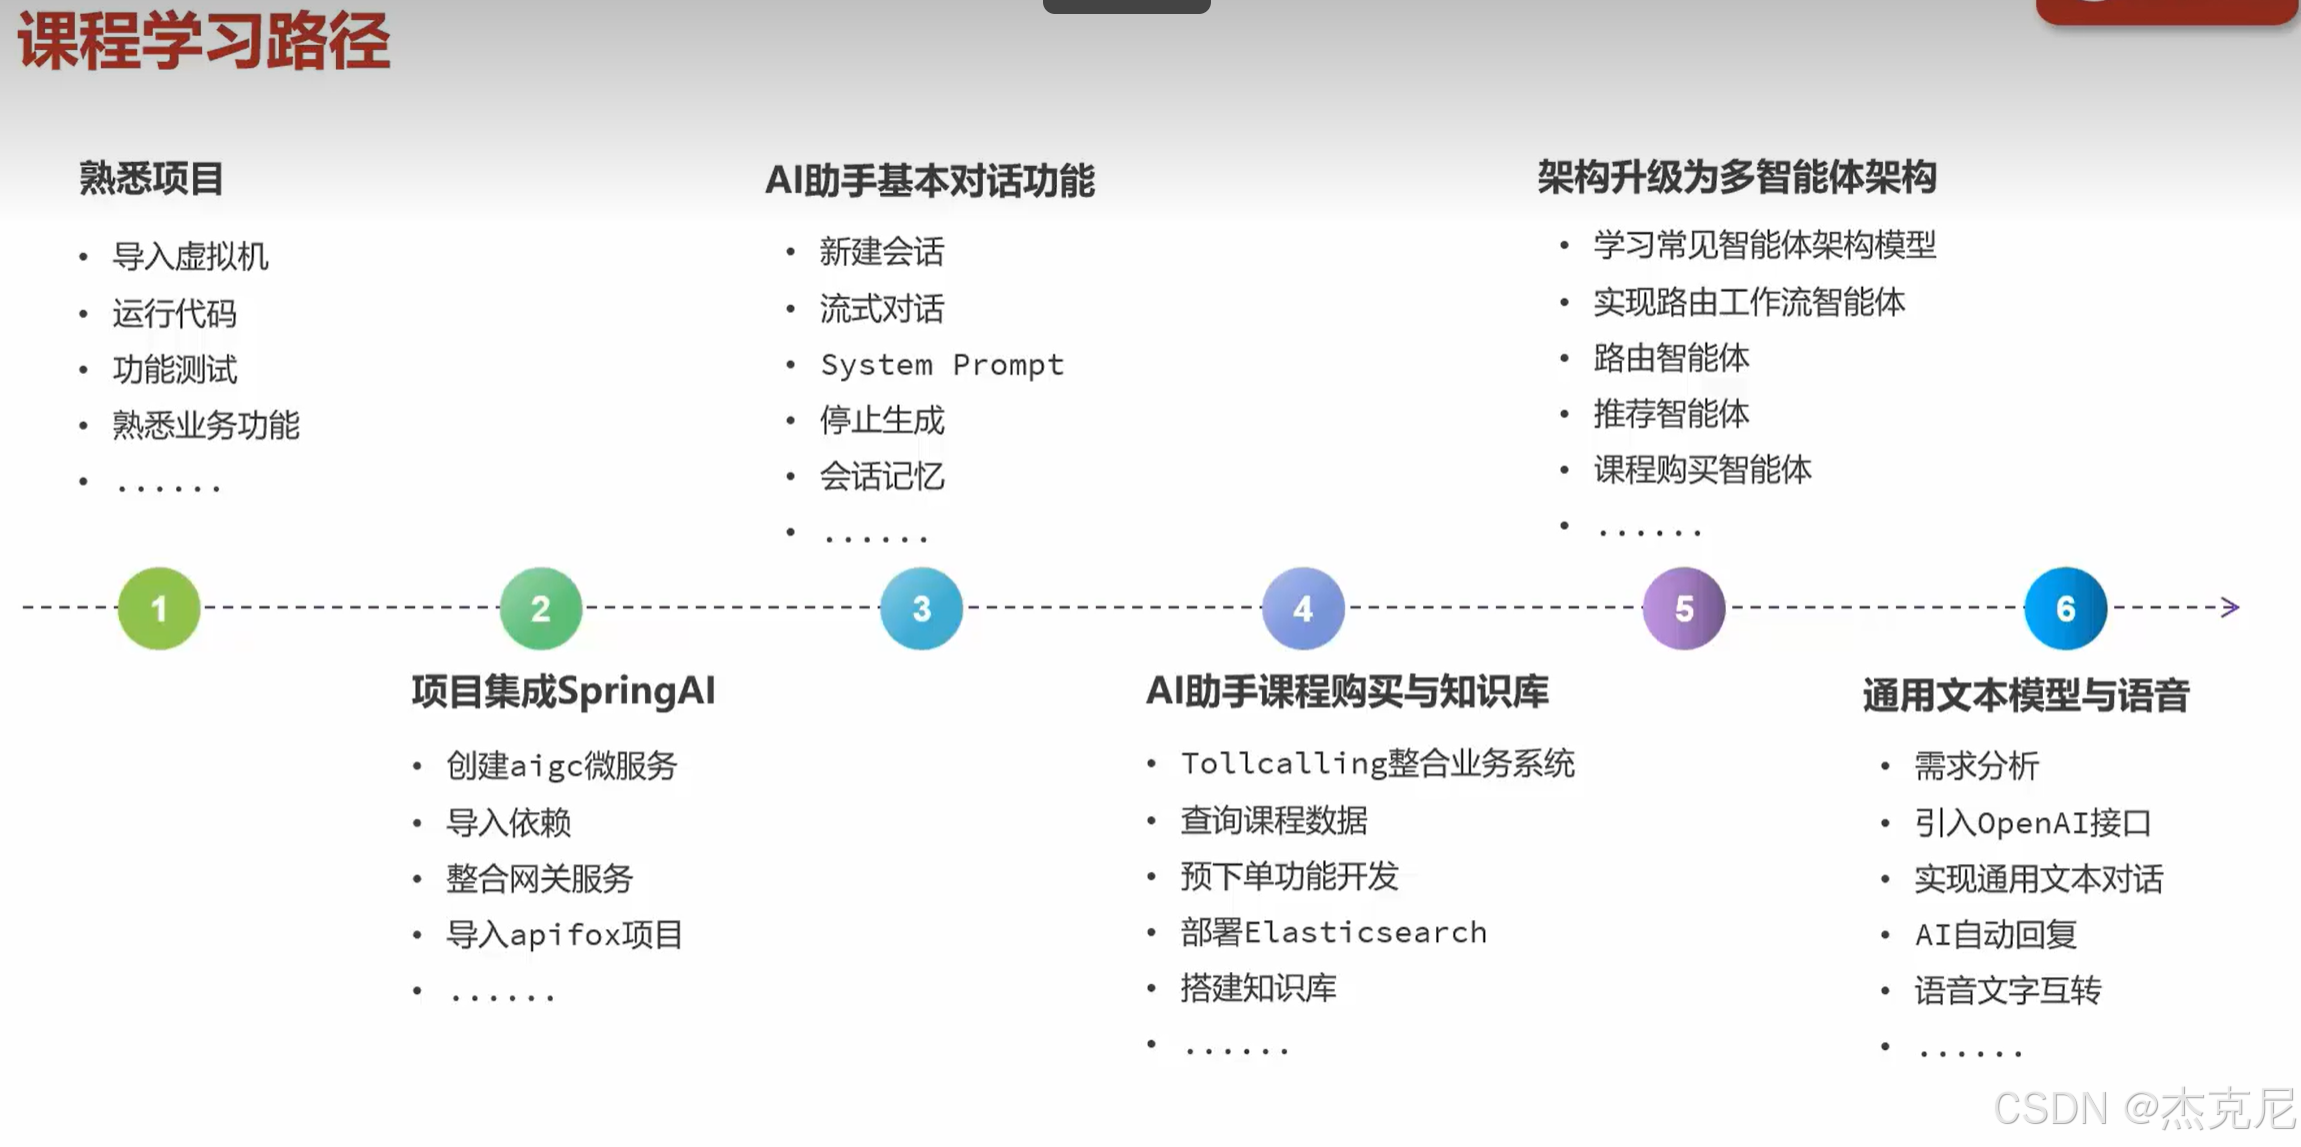
1功能展示
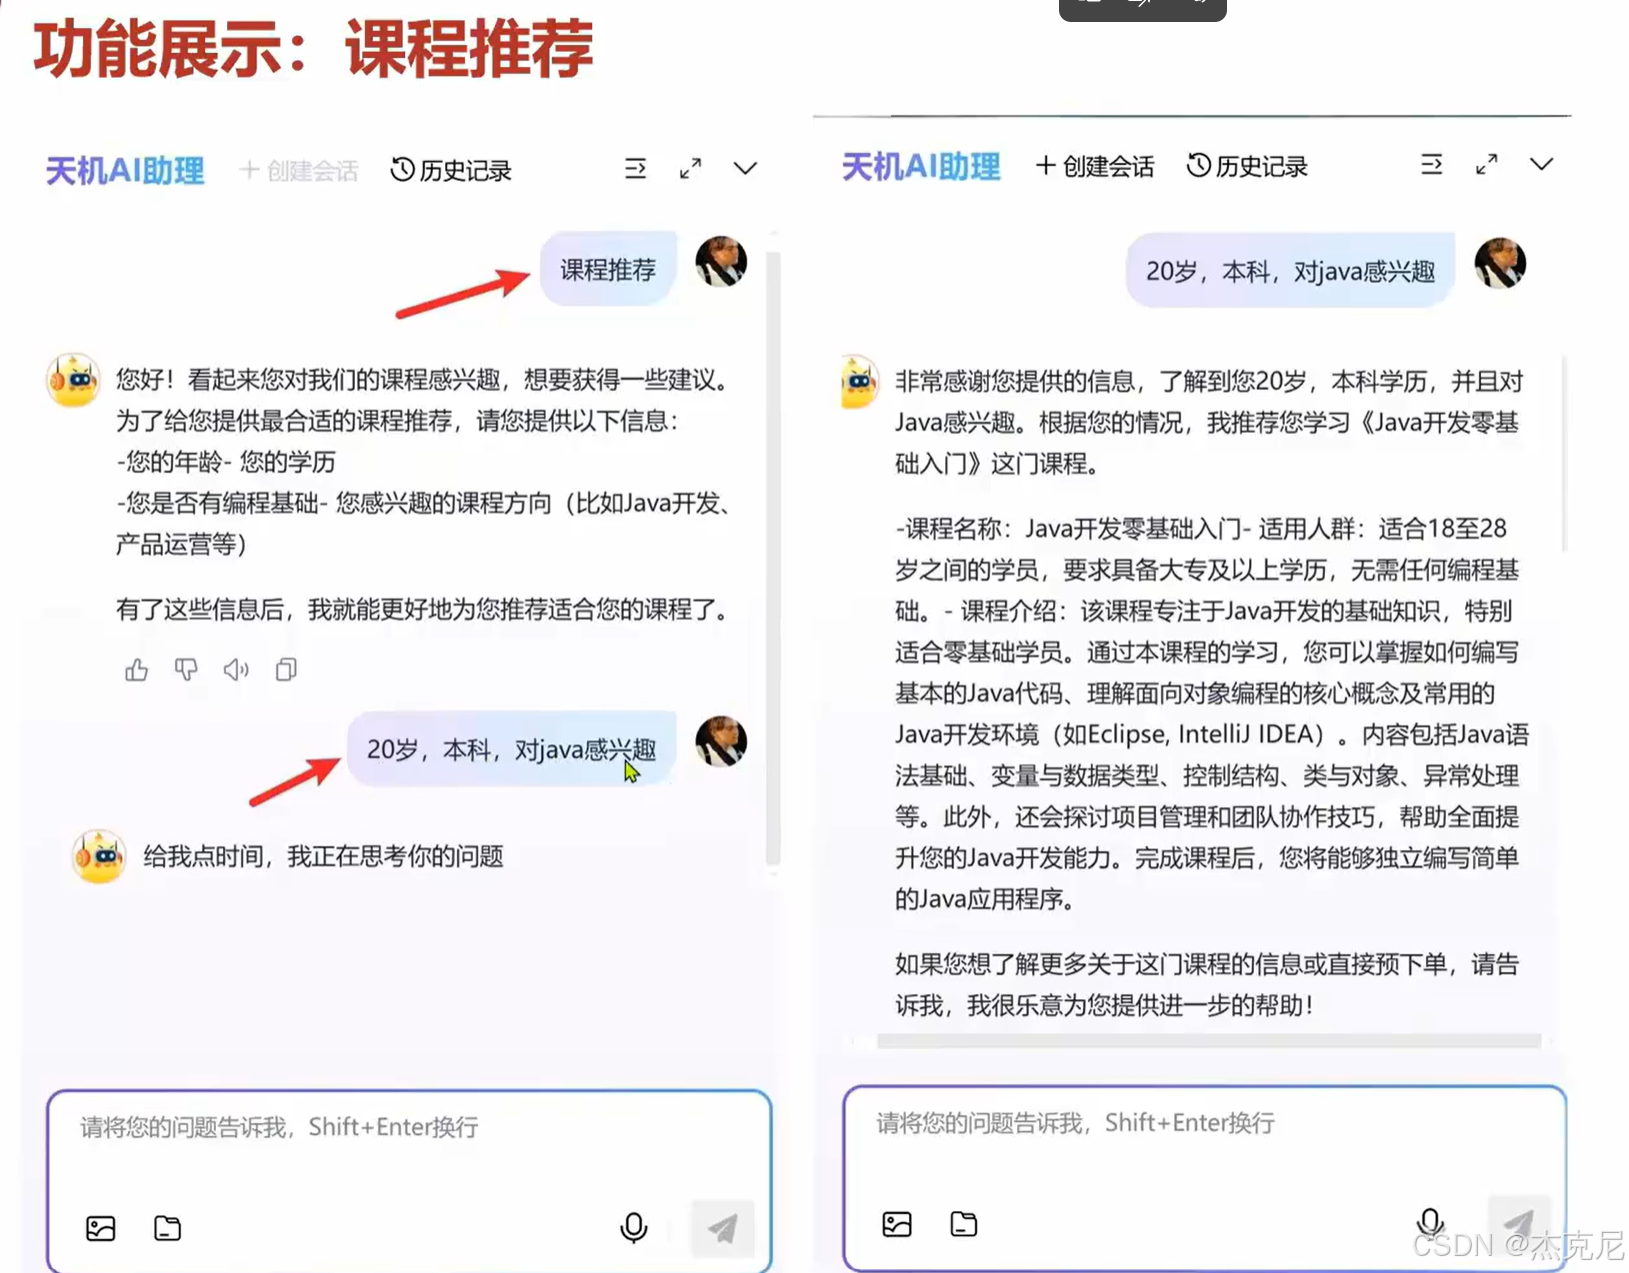
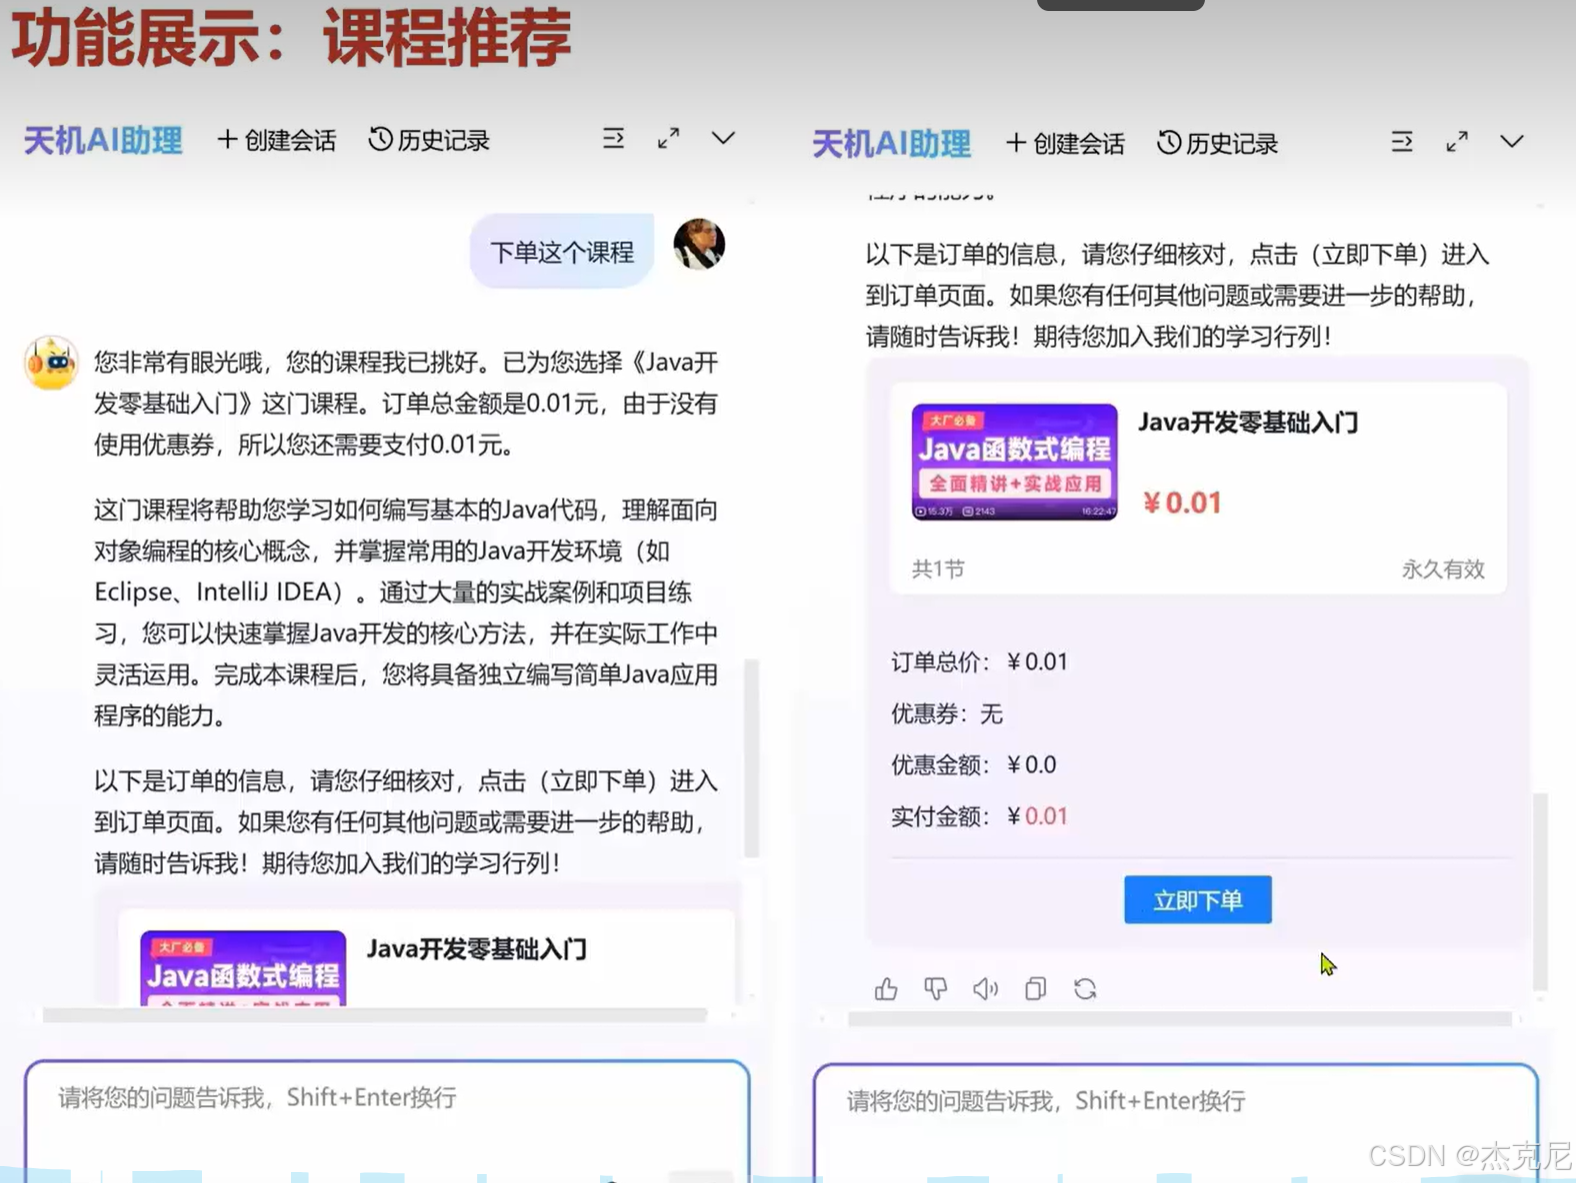
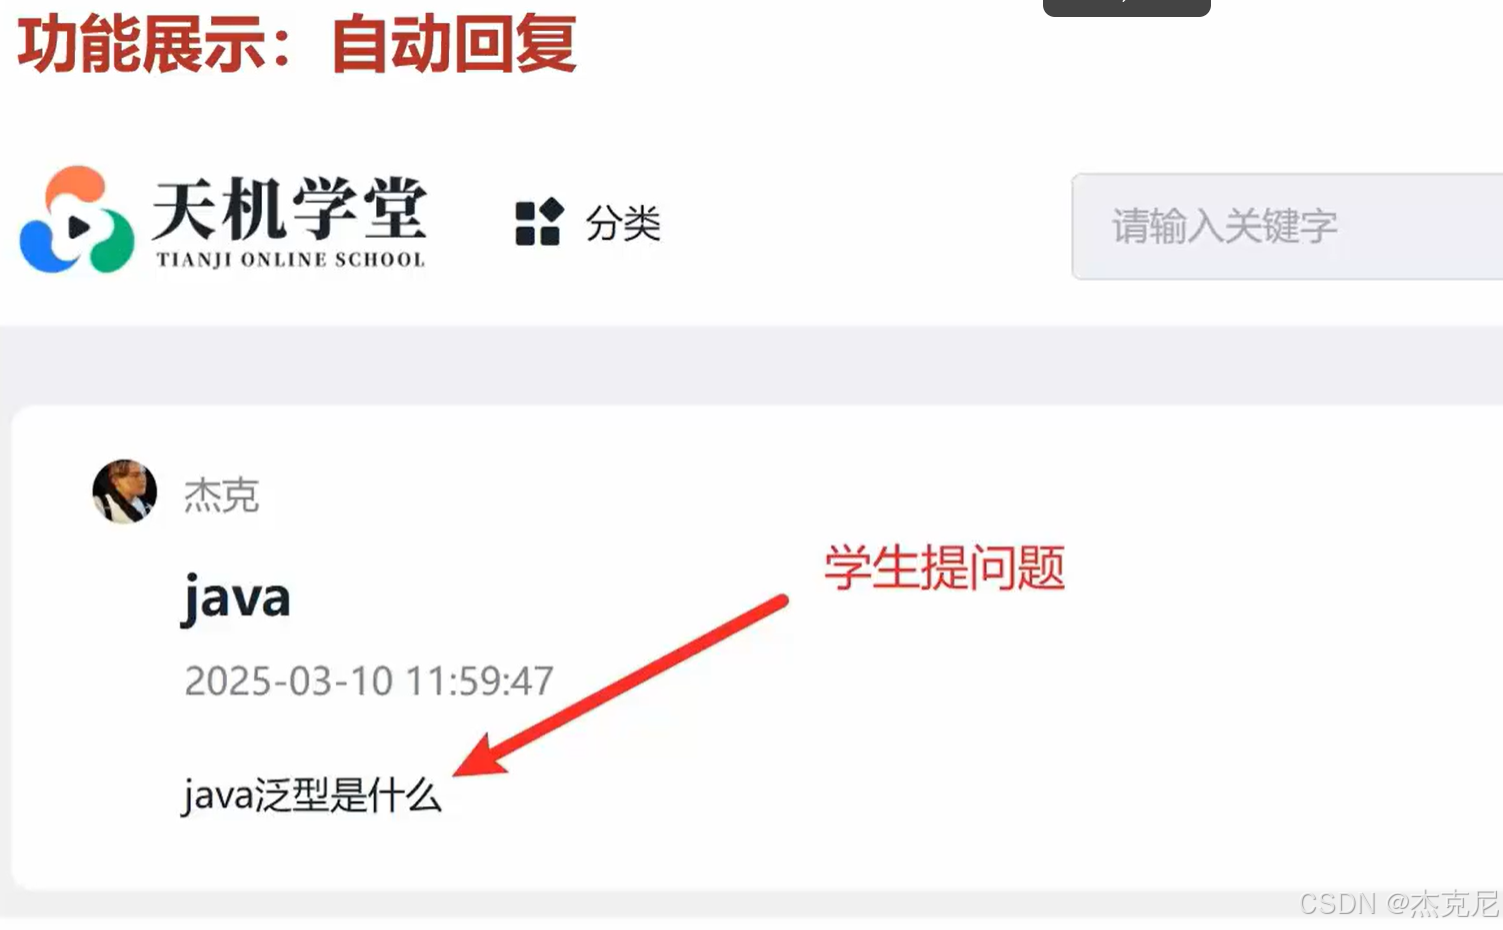
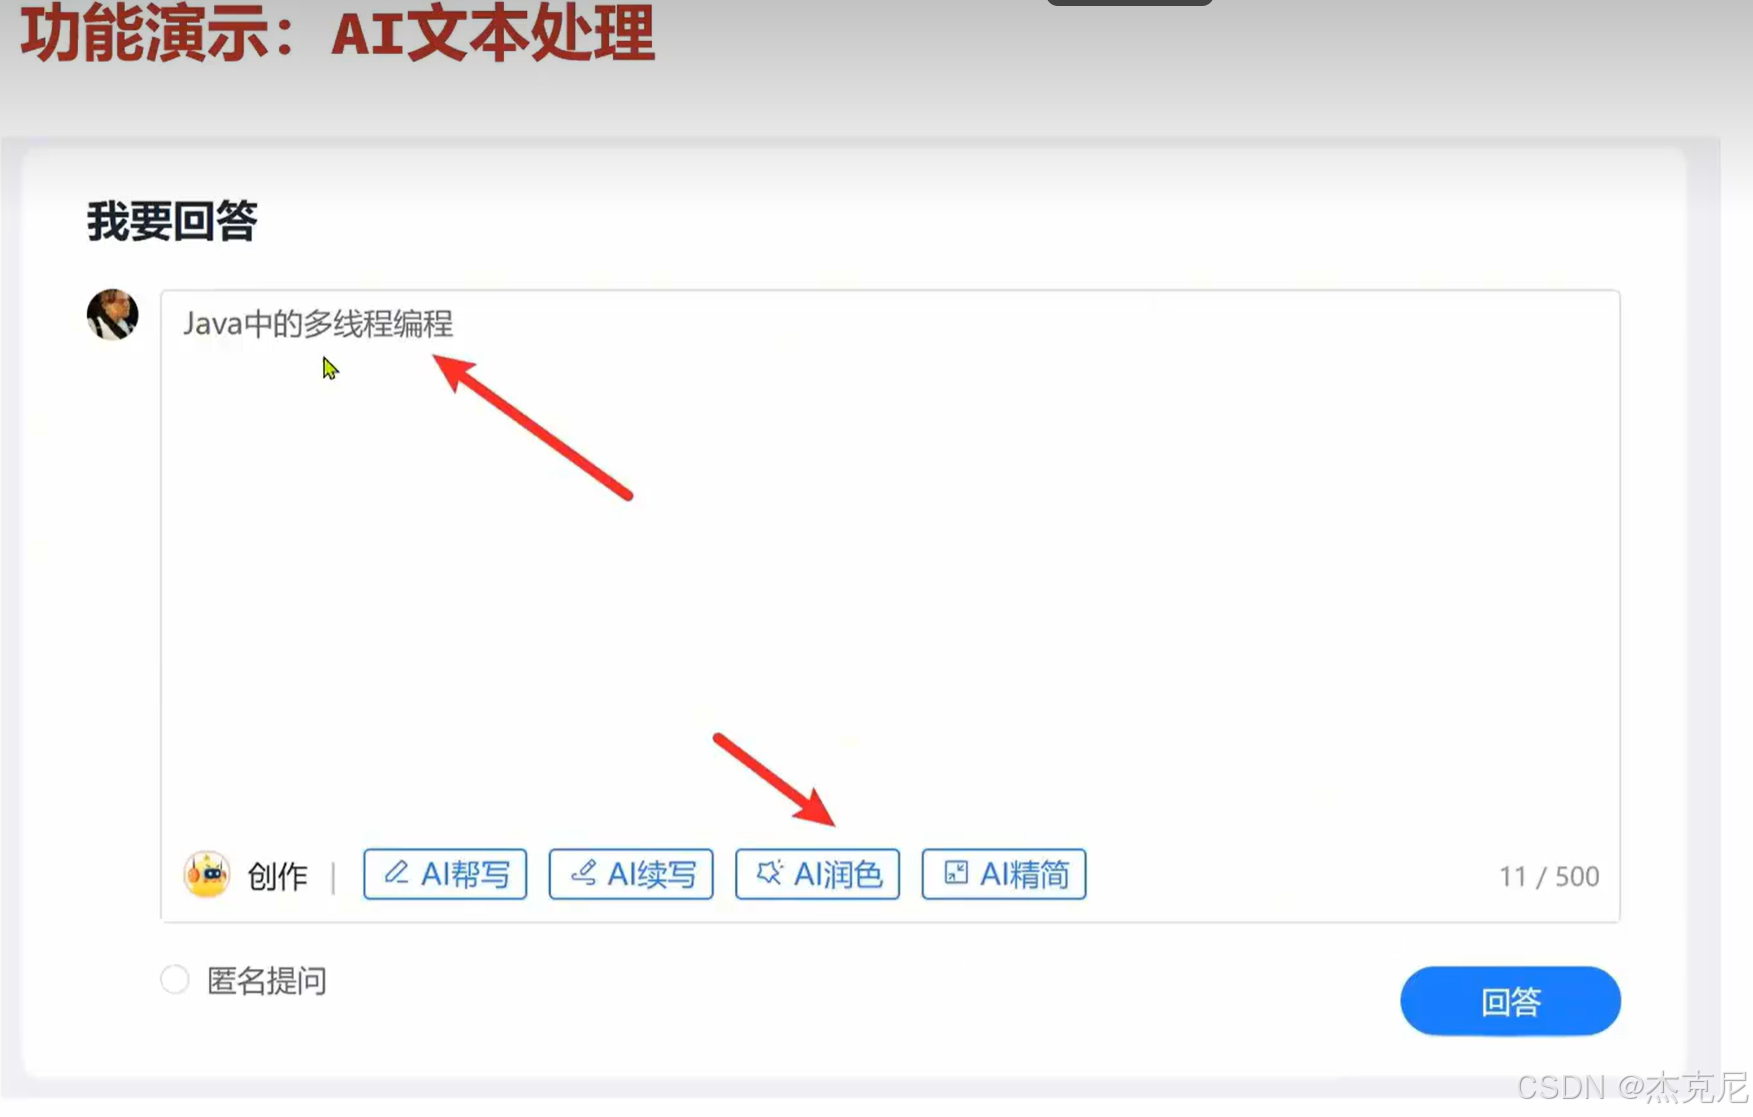
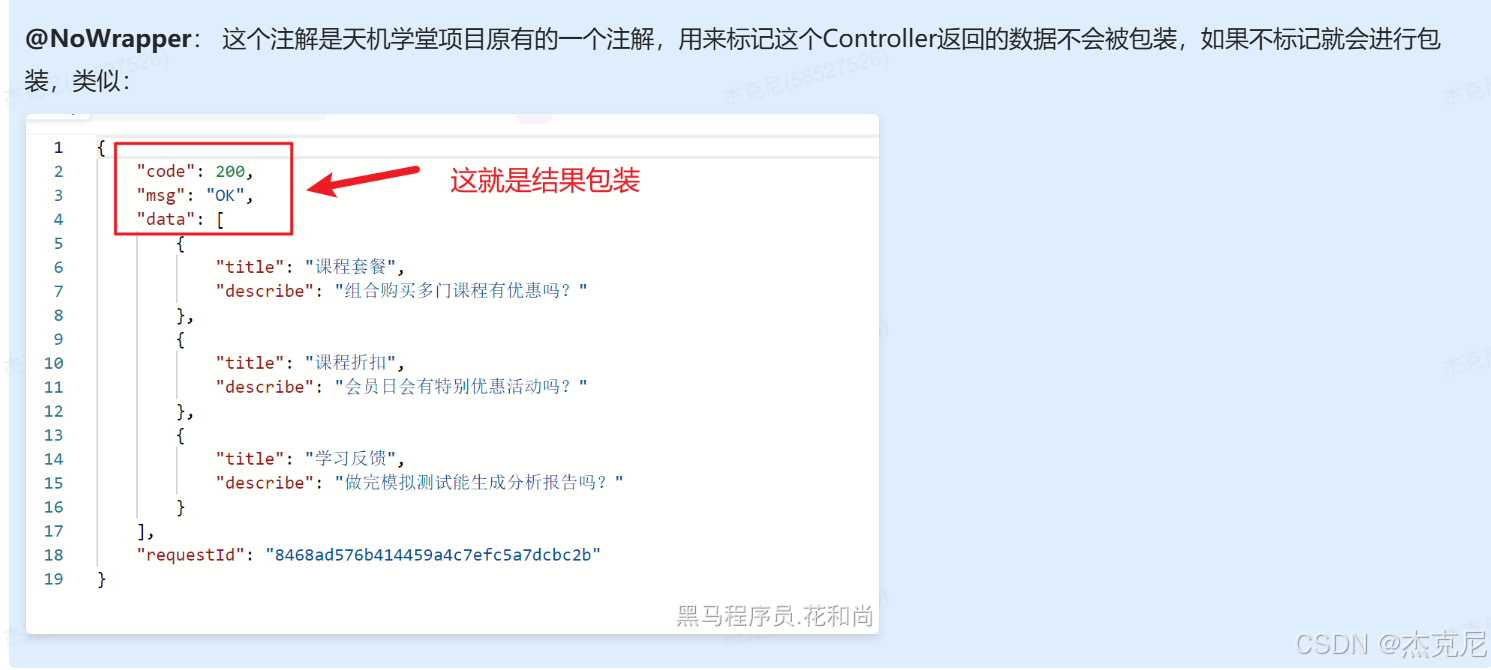
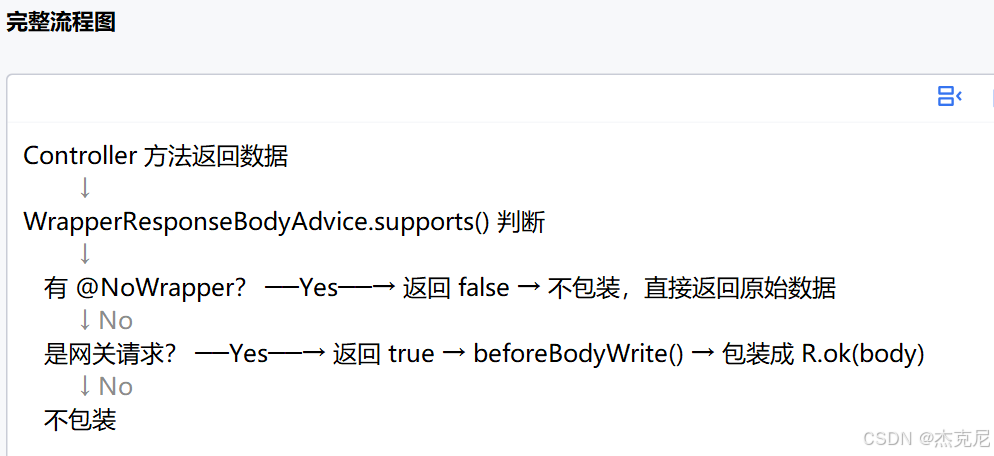
2@NoWrapper这是什么注解及怎么实现的?
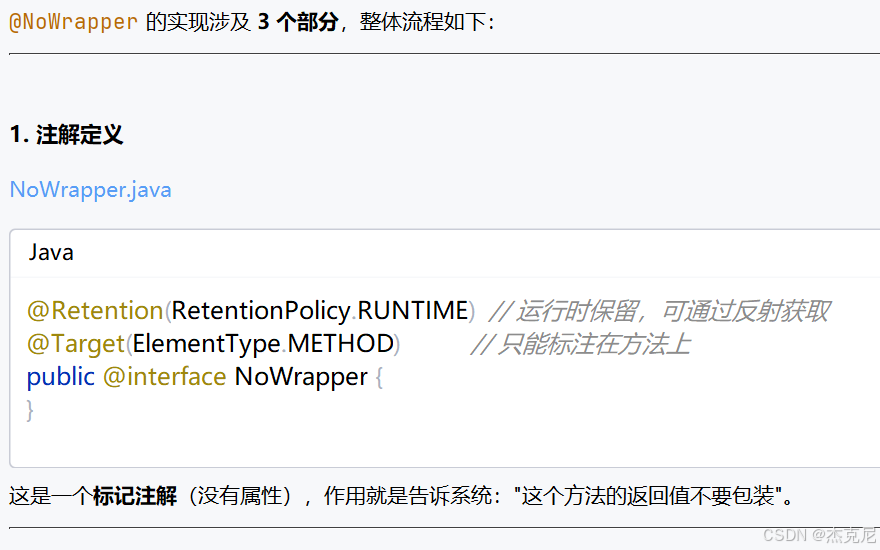
@NoWrapper // 标记结果不进行包装 //自定义注解
因为Flux流式输出只需要data里面的数据,所以不需要包装
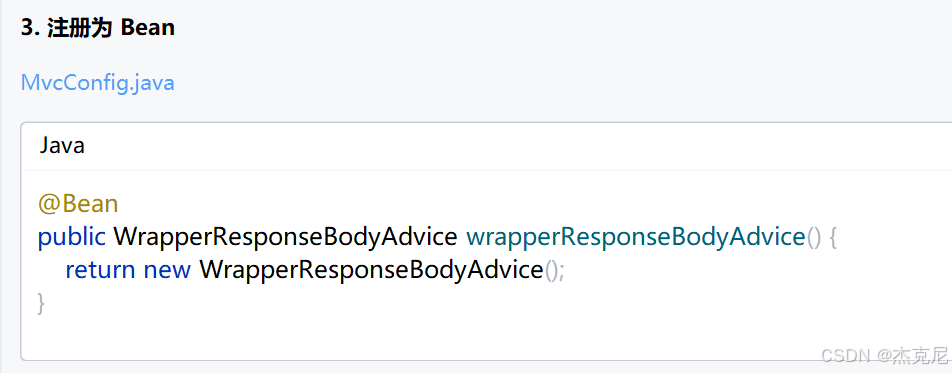
2. 核心拦截器
WrapperResponseBodyAdvice.java@RestControllerAdvice public class WrapperResponseBodyAdvice implements ResponseBodyAdvice<Object> { // 第一步:判断是否需要包装 @Override public boolean supports(MethodParameter methodParameter, ...) { // ✅ 关键:如果方法上有 @NoWrapper 注解,返回 false → 不包装 if (methodParameter.hasMethodAnnotation(NoWrapper.class)) { return false; } // 其他情况:返回值不是 R 类型 且 是网关请求 → 需要包装 return methodParameter.getParameterType() != R.class && WebUtils.isGatewayRequest(); } // 第二步:执行包装 @Override public Object beforeBodyWrite(Object body, ...) { // 把返回值包装成 R 对象 return R.ok(body).requestId(...); } }
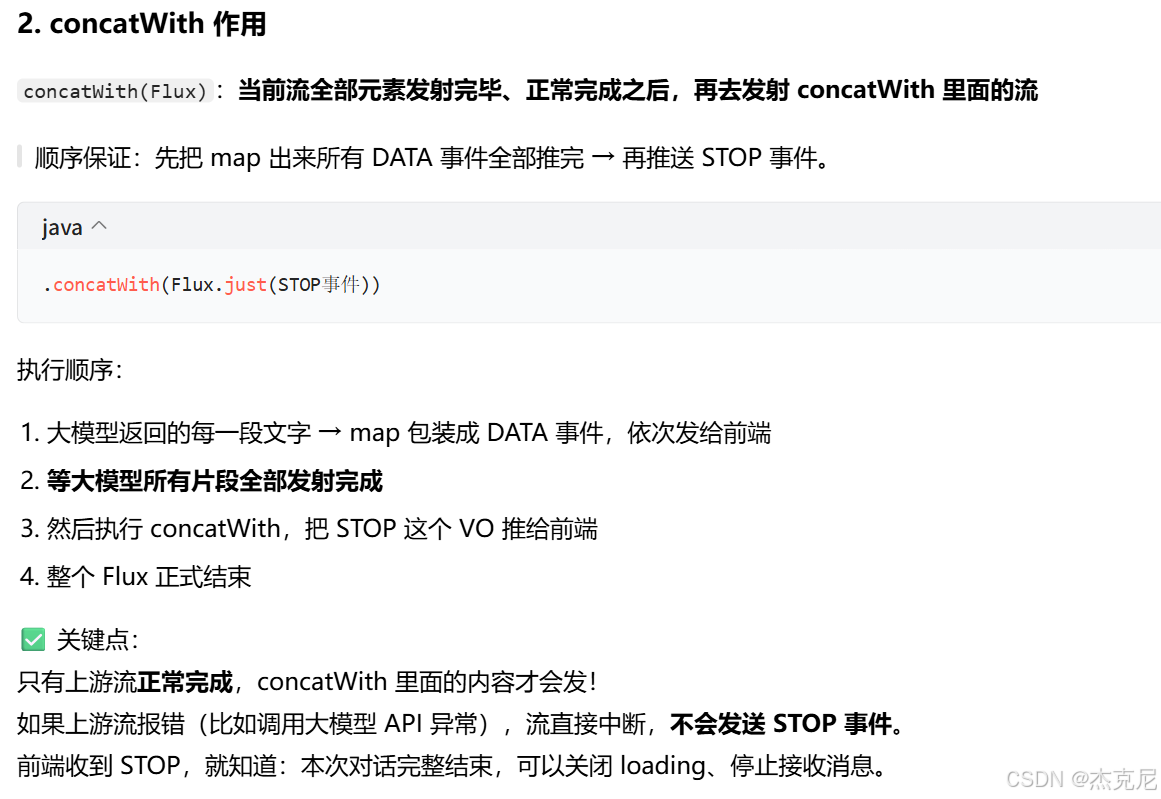
3为什么.concatWith代表输出结束?
    @Override
    public Flux<ChatEventVO> chat(String question, String sessionId) {
        return this.chatClient.prompt()
                .user(question)
                .stream()
                .chatResponse()
                .map(chatResponse -> {
                    // 获取大模型的输出的内容
                    String text = chatResponse.getResult().getOutput().getText();
                    // 封装响应对象
                    return ChatEventVO.builder()
                            .eventData(text)
                            .eventType(ChatEventTypeEnum.DATA.getValue())
                            .build();
                })
                .concatWith(Flux.just(ChatEventVO.builder()  // 标记输出结束
                        .eventType(ChatEventTypeEnum.STOP.getValue())
                        .build()));
    }
其实就是前端咱们自定义好的,如果识别到 "done"就停止
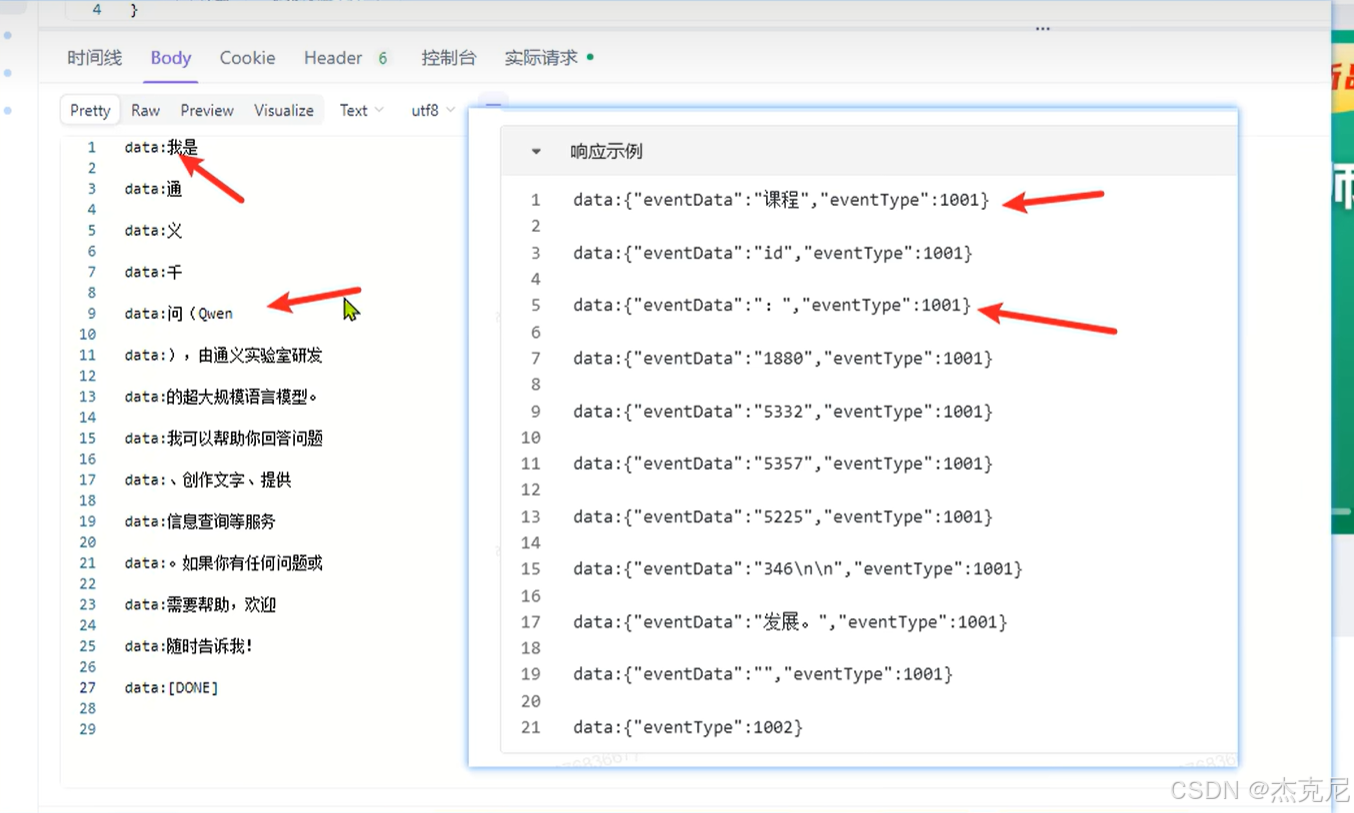
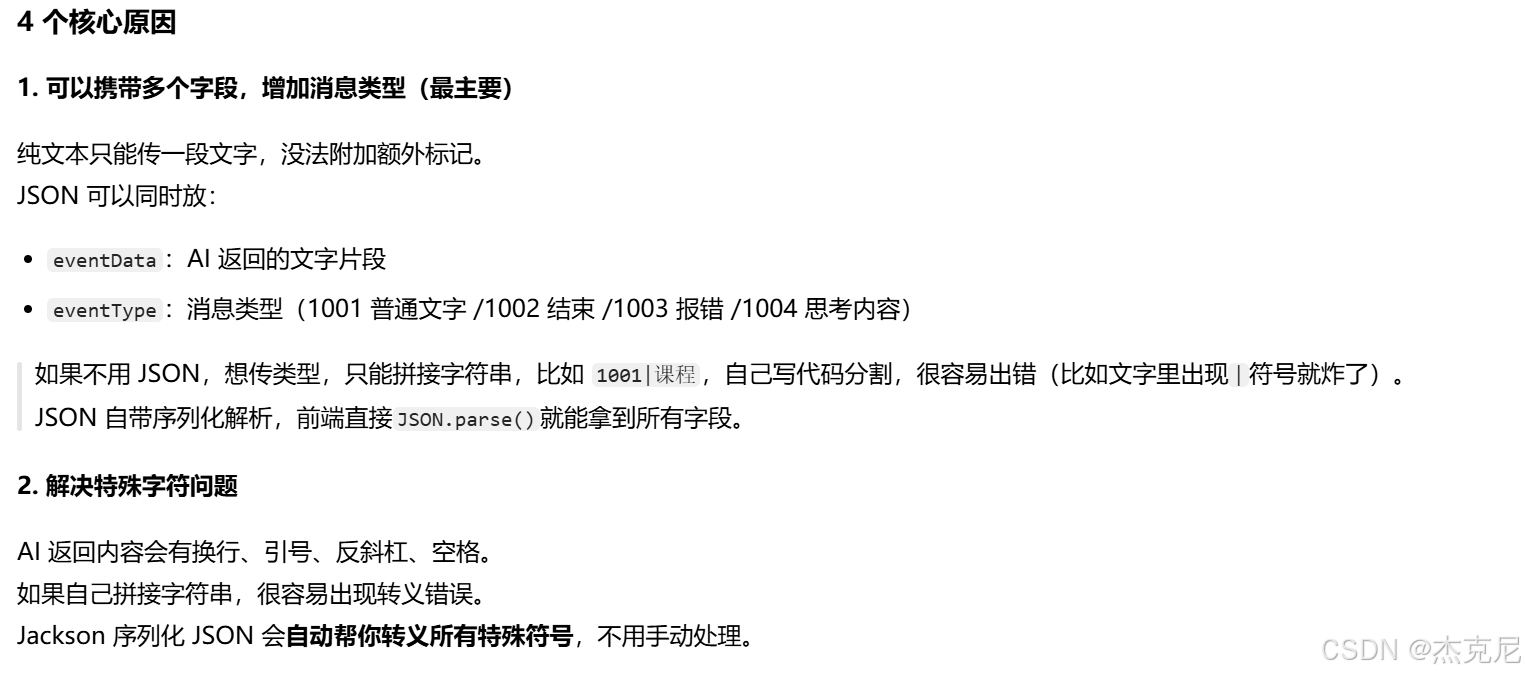
4为什么响应数据要改成json格式?
因为如果你的响应数据里面有特殊格式(如一段代码),不是json的话它不会正常显示
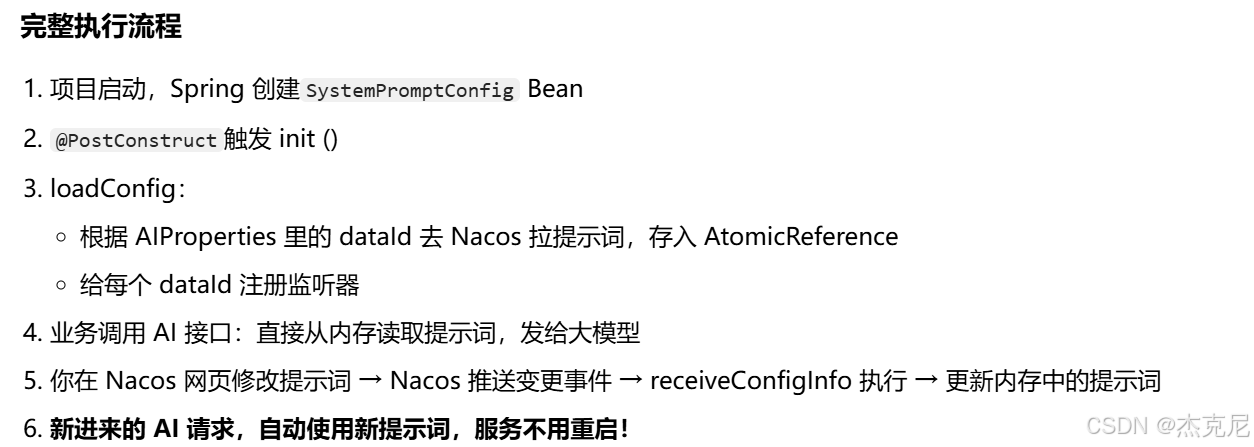
5系统提示词为什么要放在nacos?
你要是写在代码中,如果项目一旦上线,后面你再想修改提示词的时候,必须关机服务器;
如果写在nacos里,可以实现热部署(热更新)
6nacos里面的数据怎么读取?
正常的映射(写一个配置类就行)
文本格式
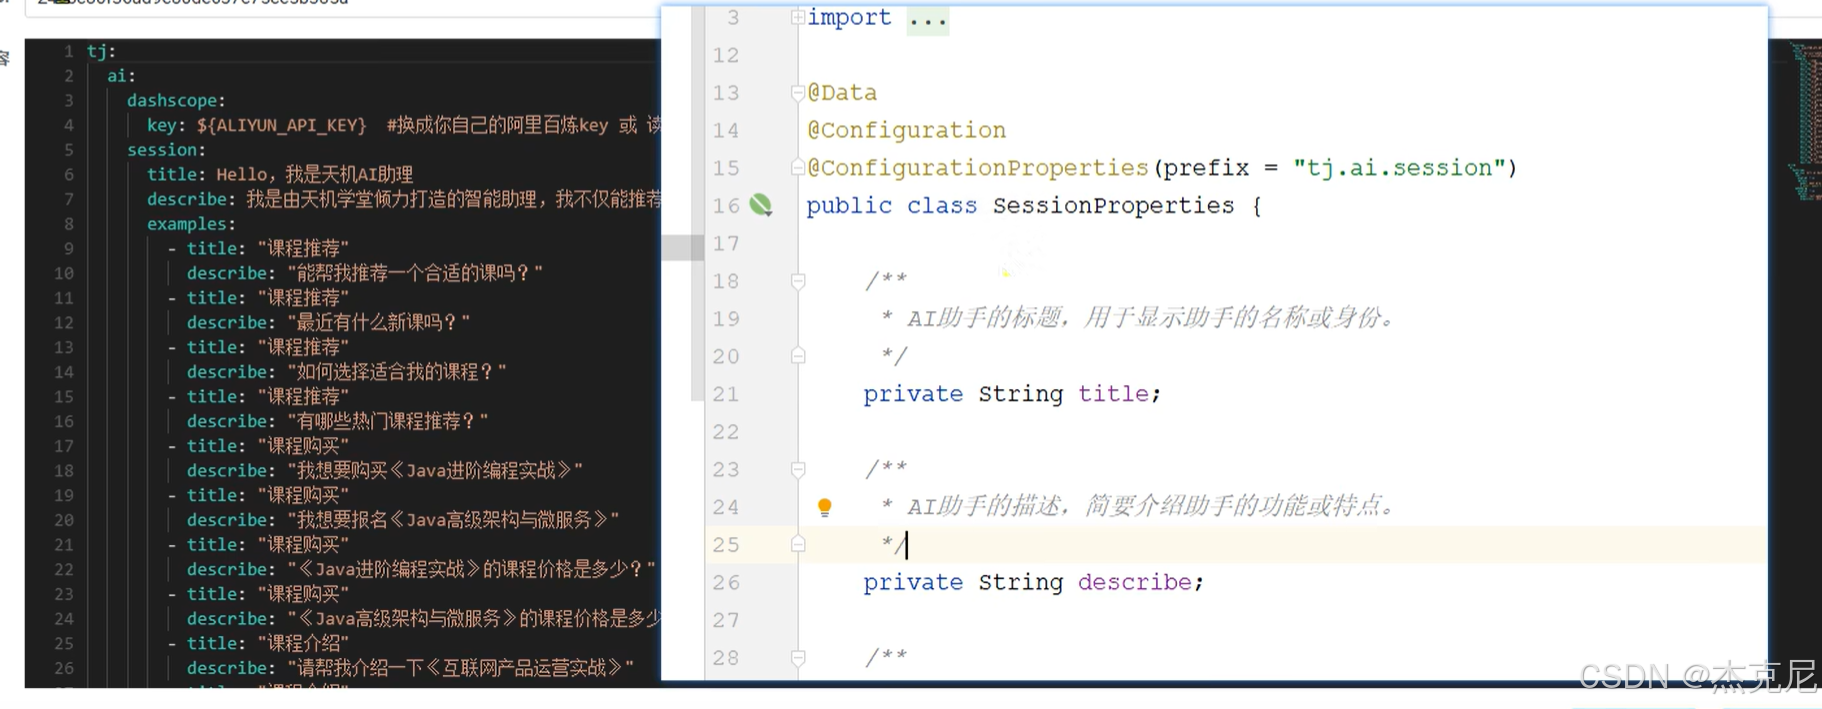
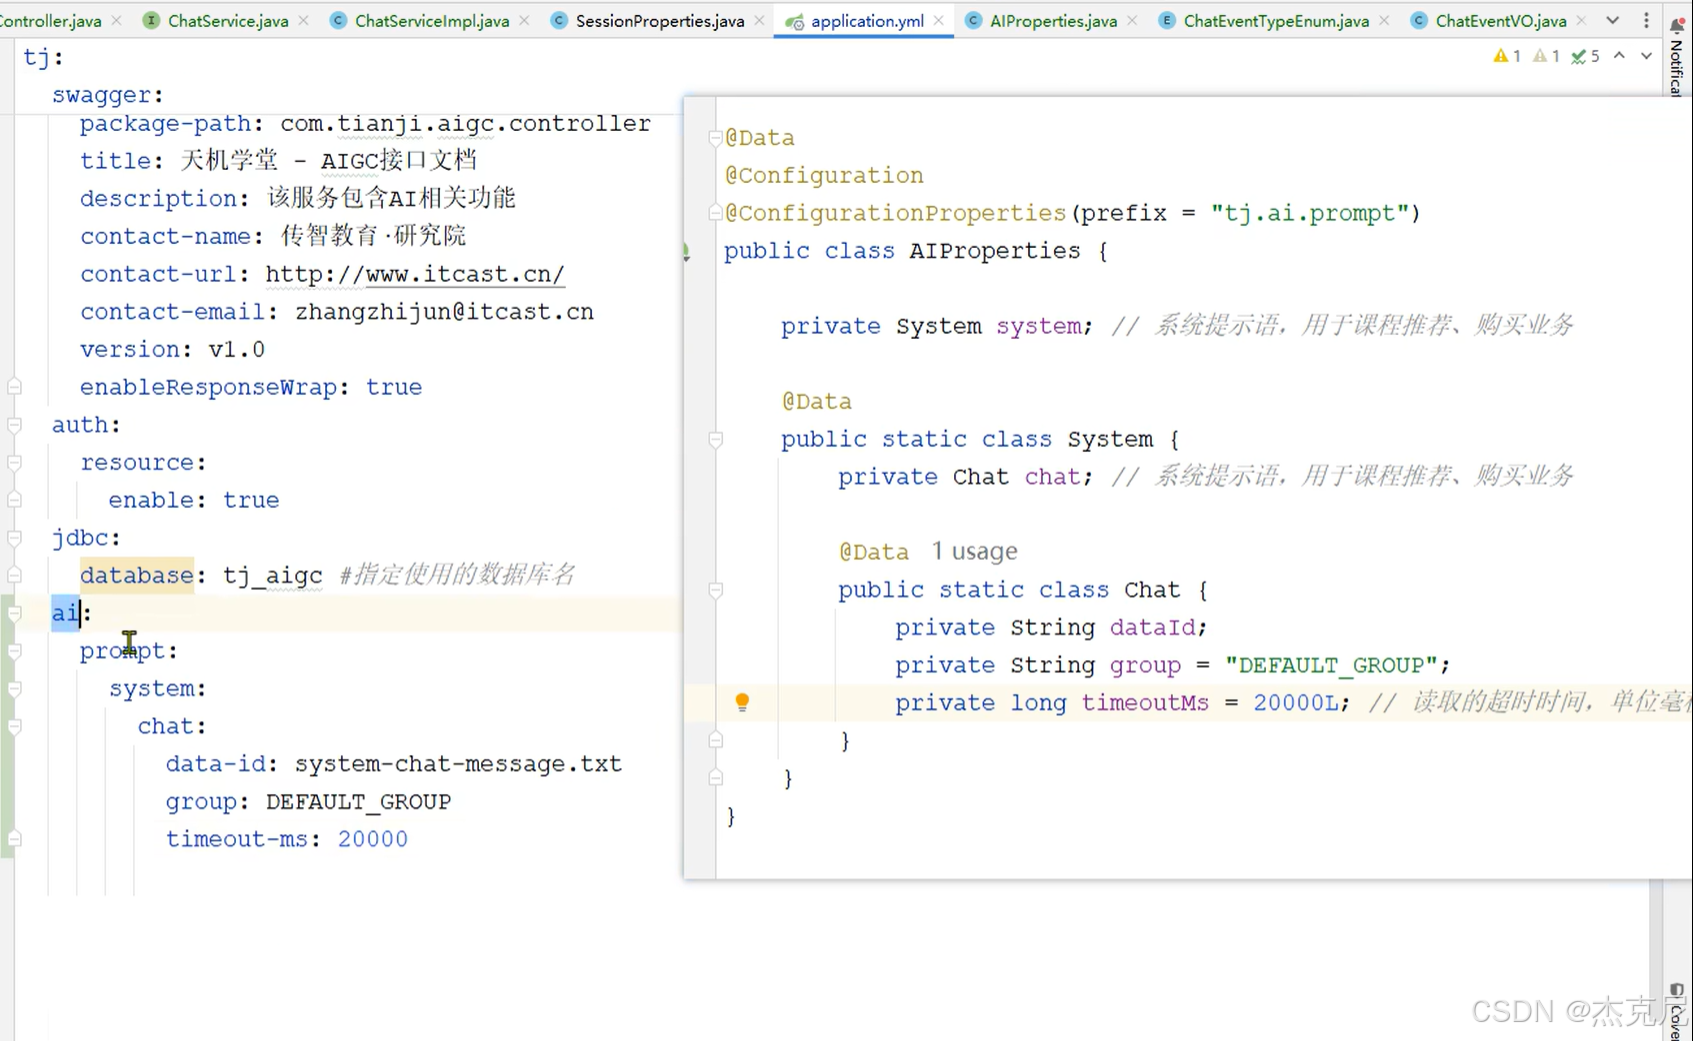
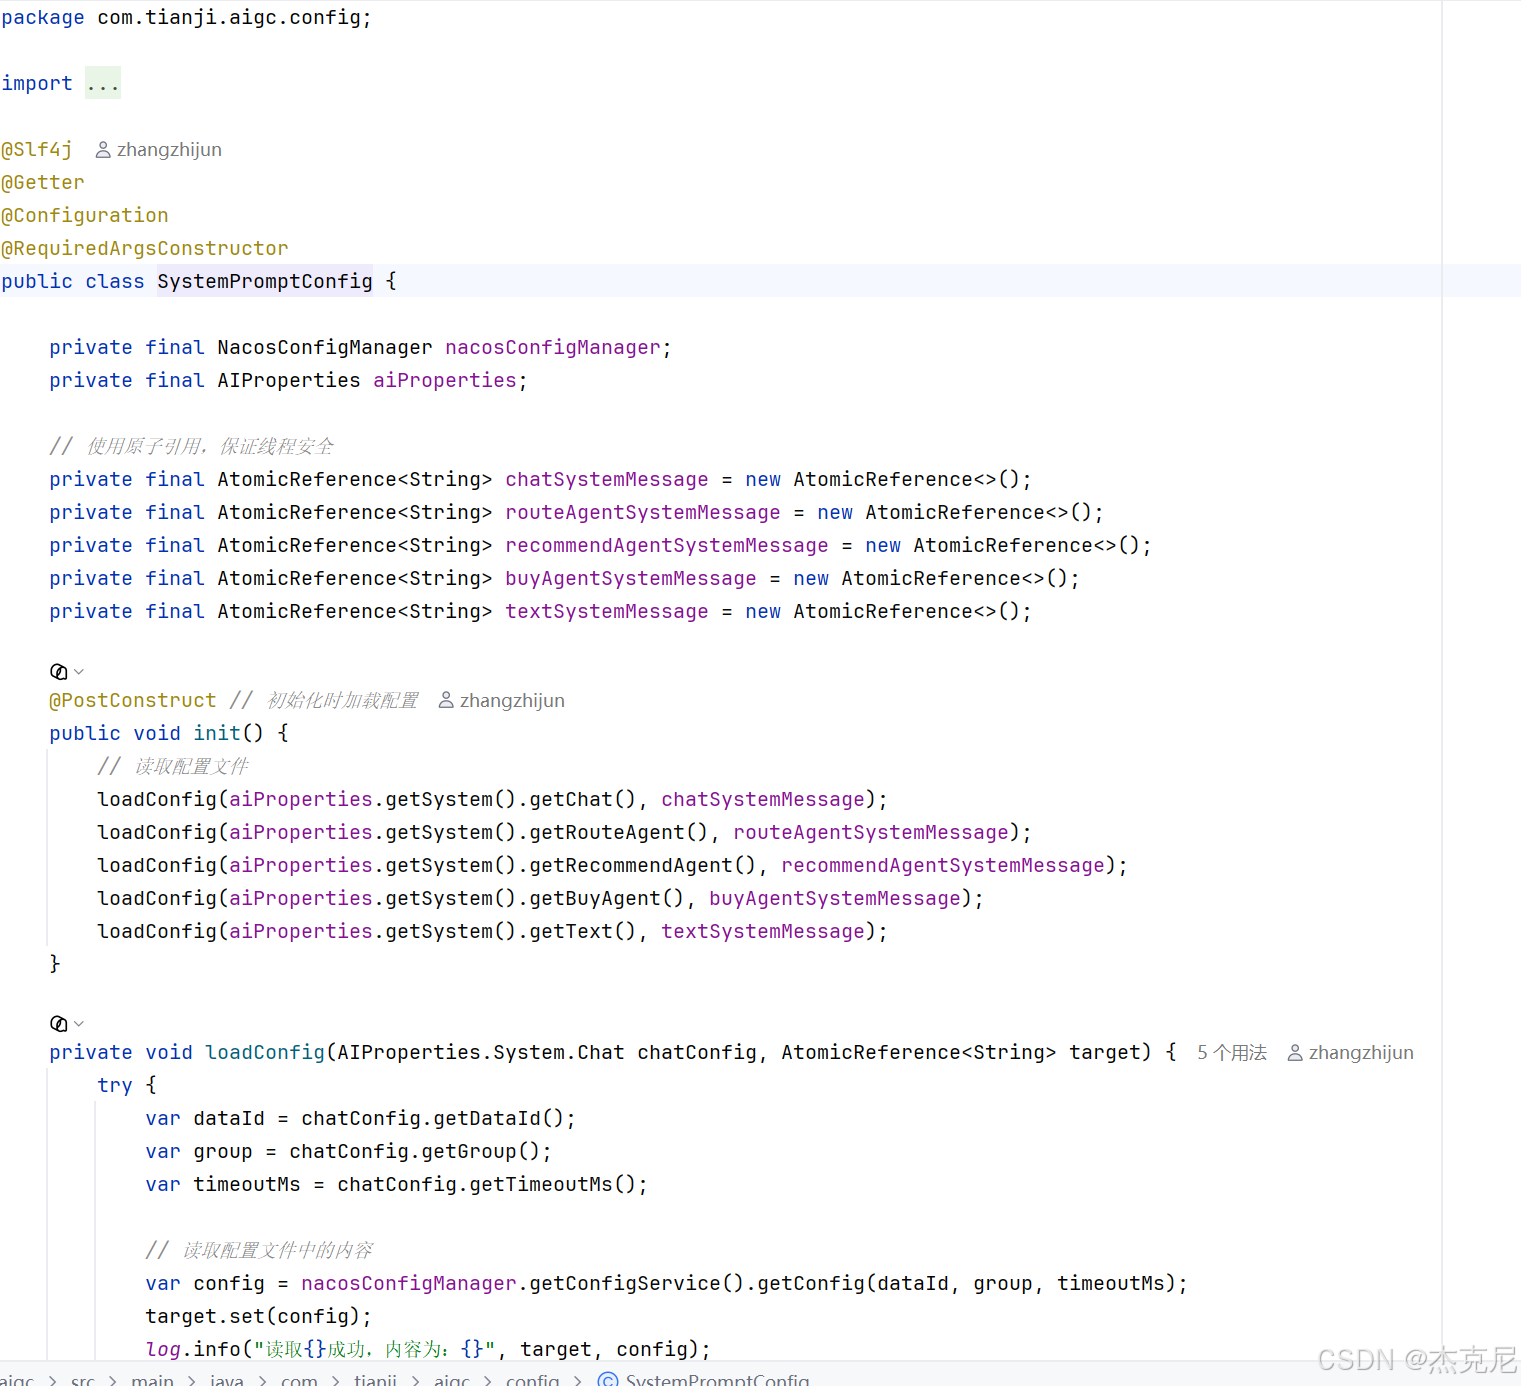
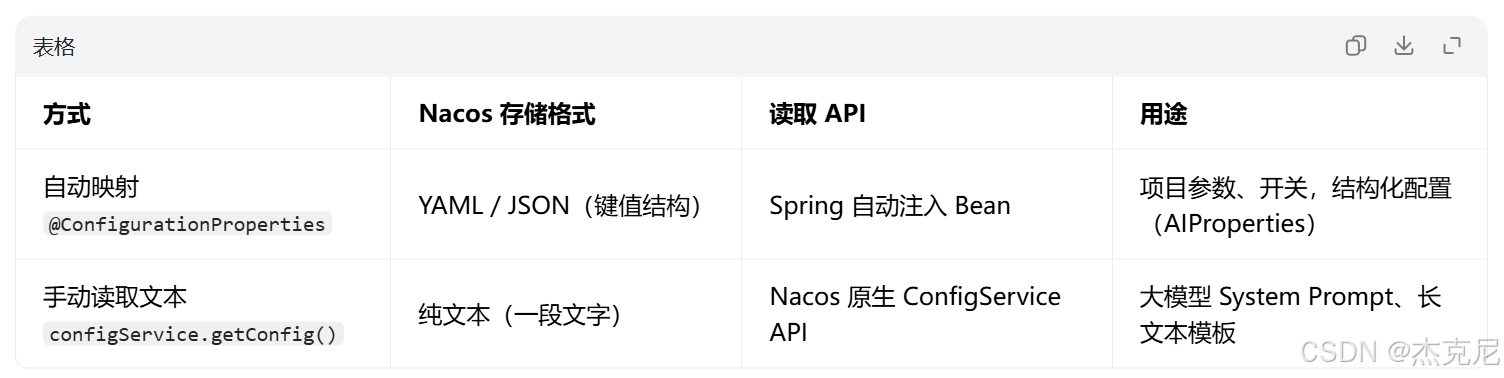
7AtomicReference<String>作用?
private final AtomicReference<String> chatSystemMessage = new AtomicReference<>();
AtomicReference<String>原子引用,线程安全的字符串容器。//保证线程安全
8系统提示词怎么在代码中使用?
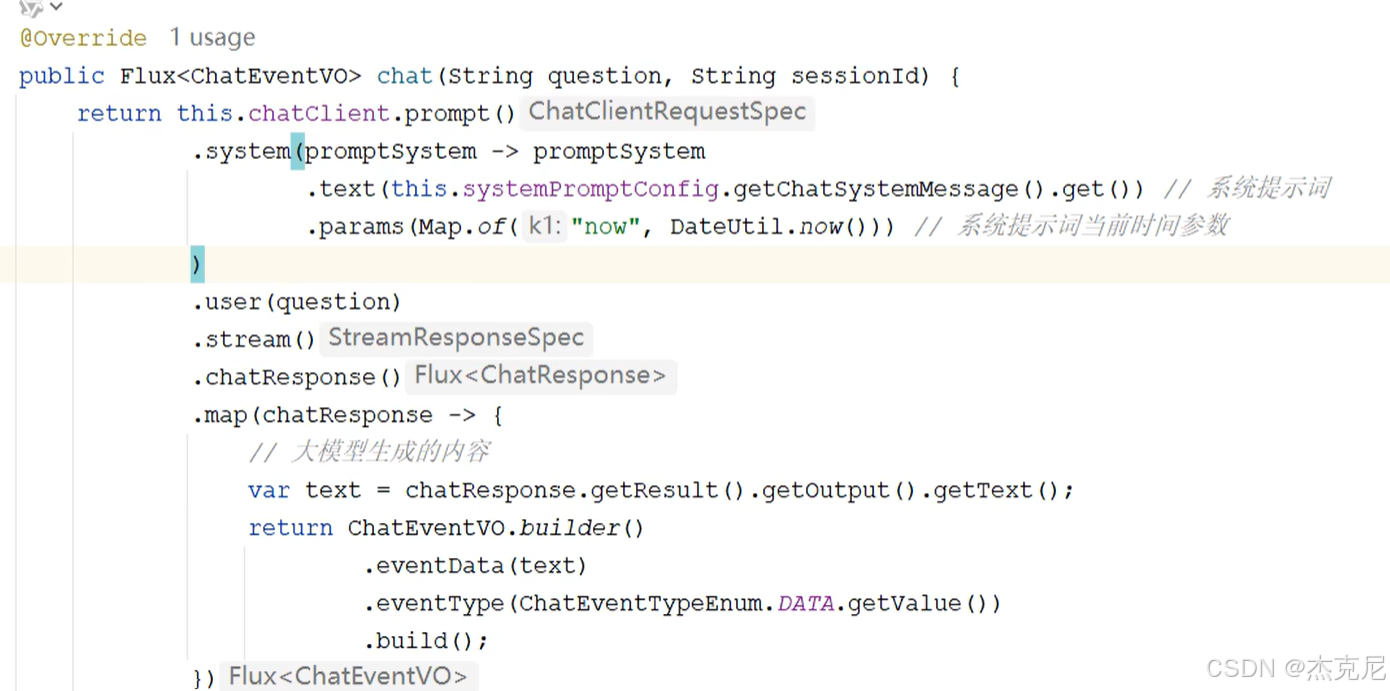
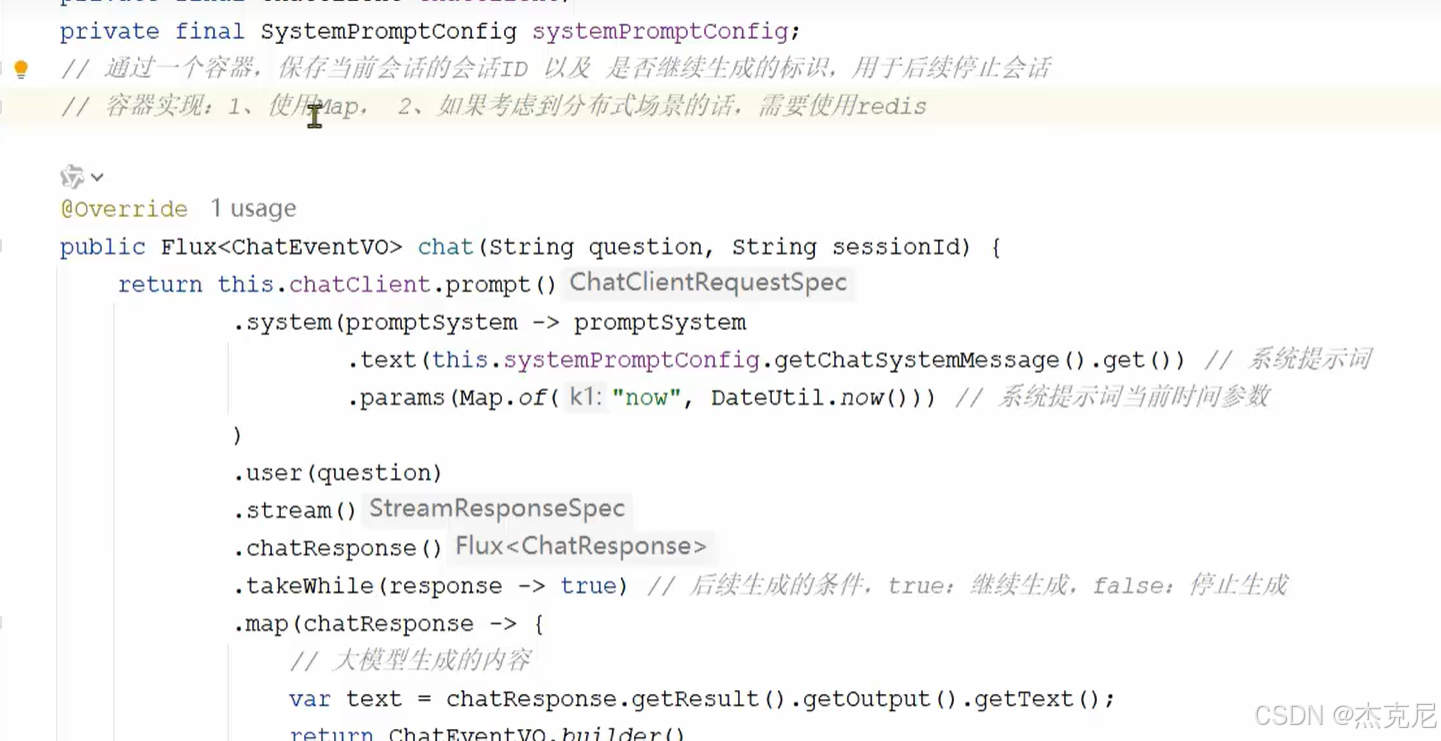
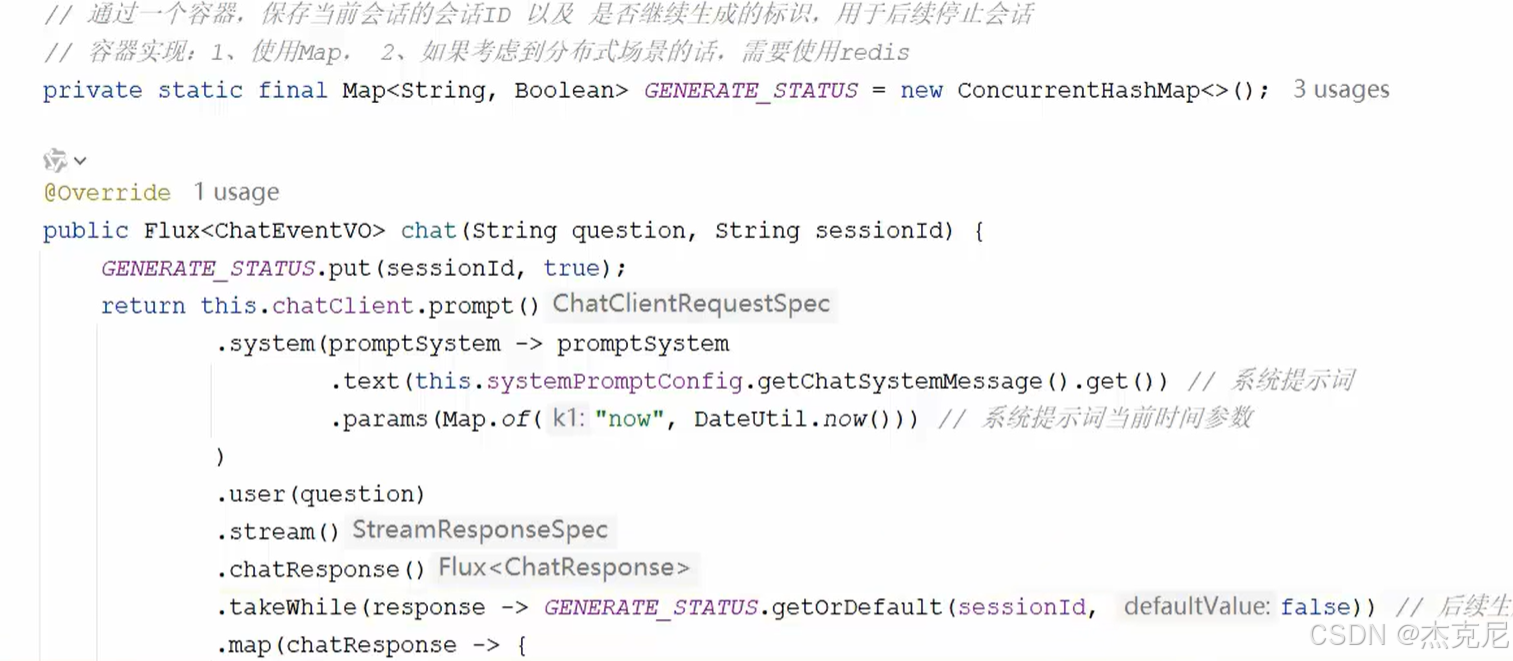
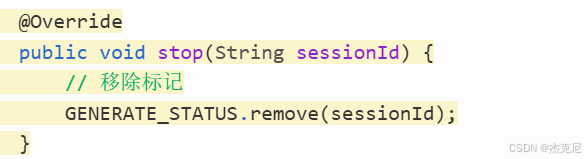
9停止生成功能怎么实现?
可以在流式输出里面使用takewhile(),这个如果后面是false就可以终止输出,上面注解解释了可以使用一个全局变量来控制true/false,当我们前端按钮点击就改变其状态;
package com.tianji.aigc.service.impl;

import cn.hutool.core.date.DateUtil;
import com.tianji.aigc.config.SystemPromptConfig;
import com.tianji.aigc.enums.ChatEventTypeEnum;
import com.tianji.aigc.service.ChatService;
import com.tianji.aigc.vo.ChatEventVO;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.stereotype.Service;
import reactor.core.publisher.Flux;

import java.util.Map;
import java.util.Optional;
import java.util.concurrent.ConcurrentHashMap;

@Slf4j
@Service
@RequiredArgsConstructor
public class ChatServiceImpl implements ChatService {

    private final ChatClient chatClient;
    private final SystemPromptConfig systemPromptConfig;
    // 存储大模型的生成状态,这里采用ConcurrentHashMap是确保线程安全
    // 目前的版本暂时用Map实现,如果考虑分布式环境的话,可以考虑用redis来实现
    private static final Map<String, Boolean> GENERATE_STATUS = new ConcurrentHashMap<>();

    @Override
    public Flux<ChatEventVO> chat(String question, String sessionId) {
        return this.chatClient.prompt()
                .system(promptSystem -> promptSystem
                        .text(this.systemPromptConfig.getChatSystemMessage().get()) // 设置系统提示语
                        .param("now", DateUtil.now()) // 设置当前时间的参数
                )
                .user(question)
                .stream()
                .chatResponse()
                .doFirst(() -> GENERATE_STATUS.put(sessionId, true)) // 第一次输出内容时执行
                .doOnError(throwable -> GENERATE_STATUS.remove(sessionId)) // 出现异常时,删除标识
                .doOnComplete(() -> GENERATE_STATUS.remove(sessionId)) // 完成时执行,删除标识
                .takeWhile(response -> { // 通过返回值来控制Flux流是否继续,true:继续,false:终止
                    return GENERATE_STATUS.getOrDefault(sessionId, false);
                })
                .map(chatResponse -> {
                    // 获取大模型的输出的内容
                    String text = chatResponse.getResult().getOutput().getText();
                    // 封装响应对象
                    return ChatEventVO.builder()
                            .eventData(text)
                            .eventType(ChatEventTypeEnum.DATA.getValue())
                            .build();
                })
                .concatWith(Flux.just(ChatEventVO.builder()  // 标记输出结束
                        .eventType(ChatEventTypeEnum.STOP.getValue())
                        .build()));
    }

    @Override
    public void stop(String sessionId) {
        // 移除标记
        GENERATE_STATUS.remove(sessionId);
    }
}
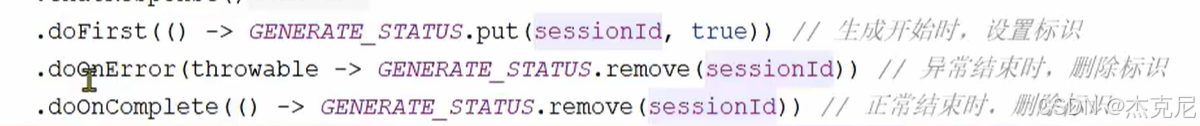
10redis实现会话记忆流程?
/**
* 先基于Redis实现的ChatMemoryRepository
*/package com.tianji.aigc.memory; import cn.hutool.core.collection.ListUtil; import cn.hutool.core.lang.Assert; import cn.hutool.json.JSONUtil; import jakarta.annotation.Resource; import org.springframework.ai.chat.memory.ChatMemoryRepository; import org.springframework.ai.chat.messages.Message; import org.springframework.data.redis.core.StringRedisTemplate; import java.util.List; /** * 基于Redis实现的ChatMemoryRepository */ public class RedisChatMemoryRepository implements ChatMemoryRepository { // 默认redis中key的前缀 public static final String DEFAULT_PREFIX = "CHAT:"; private final String prefix; // 注入spring redis模板,进行redis的操作 @Resource private StringRedisTemplate stringRedisTemplate; public RedisChatMemoryRepository() { this.prefix = DEFAULT_PREFIX; } public RedisChatMemoryRepository(String prefix) { this.prefix = prefix; } @Override public List<String> findConversationIds() { Set<String> keys = this.stringRedisTemplate.keys(this.prefix + "*"); if (null == keys) { return List.of(); } return StreamUtil.of(keys) .map(key -> StrUtil.replace(key, this.prefix, "")) .toList(); } @Override public List<Message> findByConversationId(String conversationId) { // 先不实现 return List.of(); } @Override public void saveAll(String conversationId, List<Message> messages) { Assert.notEmpty(messages, "消息列表不能为空"); var redisKey = this.getKey(conversationId); var listOps = this.stringRedisTemplate.boundListOps(redisKey); // 保存数据时,会传入全部的消息数据,包括之前的数据,所以需要先删除之前的数据,再添加新的数据 this.deleteByConversationId(conversationId); // 将消息序列化并添加到Redis列表的右侧 messages.forEach(message -> listOps.rightPush(JSONUtil.toJsonStr(message))); } @Override public void deleteByConversationId(String conversationId) { var redisKey = this.getKey(conversationId); this.stringRedisTemplate.delete(redisKey); } private String getKey(String conversationId) { return prefix + conversationId; } }在
SpringAIConfig中加入会议记忆功能:package com.tianji.aigc.config; import com.tianji.aigc.memory.RedisChatMemoryRepository; import org.springframework.ai.chat.client.ChatClient; import org.springframework.ai.chat.client.advisor.MessageChatMemoryAdvisor; import org.springframework.ai.chat.client.advisor.SimpleLoggerAdvisor; import org.springframework.ai.chat.client.advisor.api.Advisor; import org.springframework.ai.chat.memory.ChatMemory; import org.springframework.ai.chat.memory.ChatMemoryRepository; import org.springframework.ai.chat.memory.MessageWindowChatMemory; import org.springframework.beans.factory.annotation.Value; import org.springframework.context.annotation.Bean; import org.springframework.context.annotation.Configuration; @Configuration public class SpringAIConfig { @Value("${tj.ai.memory.max:100}") private Integer maxMessages; /** * 配置 ChatClient */ @Bean public ChatClient chatClient(ChatClient.Builder chatClientBuilder, Advisor loggerAdvisor, // 日志记录器 Advisor messageChatMemoryAdvisor ) { return chatClientBuilder .defaultAdvisors(loggerAdvisor, messageChatMemoryAdvisor) //添加 Advisor 功能增强 .build(); } /** * 日志记录器 */ @Bean public Advisor loggerAdvisor() { return new SimpleLoggerAdvisor(); } @Bean public ChatMemoryRepository redisChatMemoryRepository() { return new RedisChatMemoryRepository(); } @Bean public ChatMemory chatMemory(ChatMemoryRepository chatMemoryRepository) { // 基于 chatMemoryRepository 对象构建 chatMemory 对象 return MessageWindowChatMemory.builder() .chatMemoryRepository(chatMemoryRepository) .maxMessages(this.maxMessages) // 最多保存 100 条对话, 如果超出的话,会自动删除最旧的对话 .build(); } /** * 基于Redis的会话记忆,聊天记忆整合到message列表中实现多轮对话 */ @Bean public Advisor messageChatMemoryAdvisor(ChatMemory chatMemory) { // 创建基于 chatMemory 的 Advisor 对象 return MessageChatMemoryAdvisor.builder(chatMemory).build(); } }
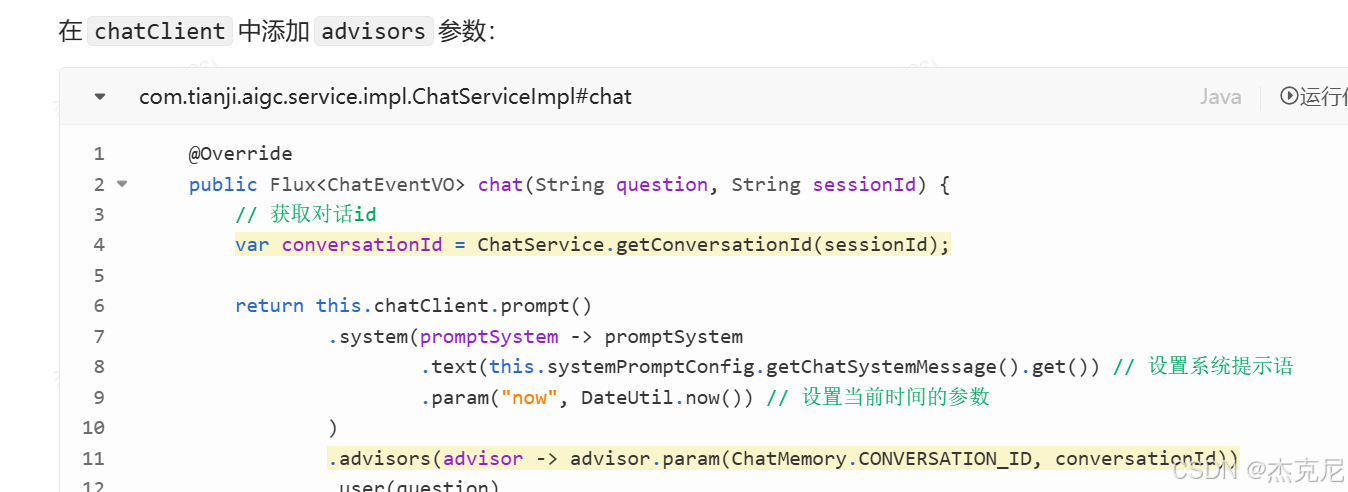
11对话id和会话id?
对话id是springAI的,会话id是java项目里面我们自定义的
一般来说对话id=用户id_会话id
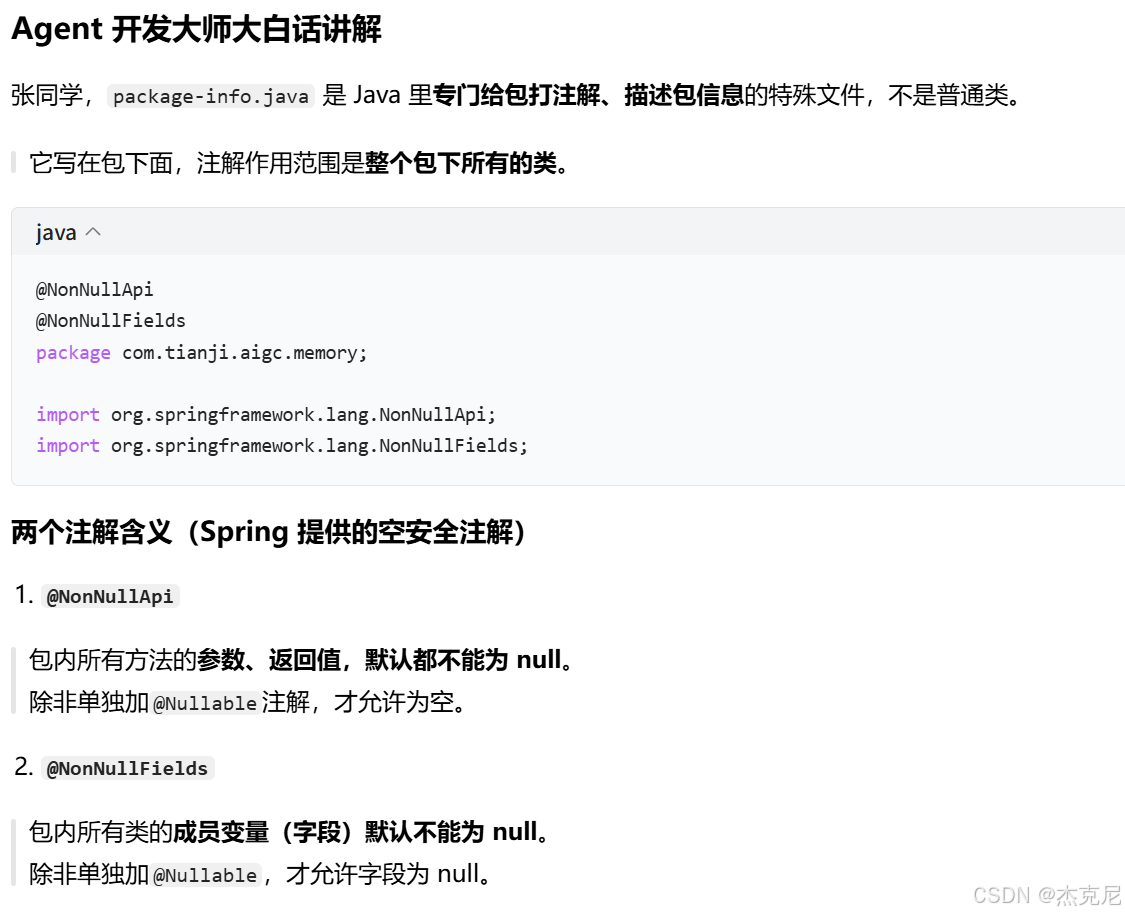
12包下package-info.java这个有什么用?
@NonNullApi
@NonNullFields
package com.tianji.aigc.memory;

import org.springframework.lang.NonNullApi;
import org.springframework.lang.NonNullFields;
比如说之前类中每个参数都要加@NotNull,现在不用加了
13StrUtil.replace(原始字符串, 要被替换的内容, 替换成什么)?
这个一般用于从redis中取值,因为redis中有前缀,取值出来之后要去掉 这个前缀
 return StreamUtil.of(keys)
                .map(key -> StrUtil.replace(key, this.prefix, ""))
                .toList();
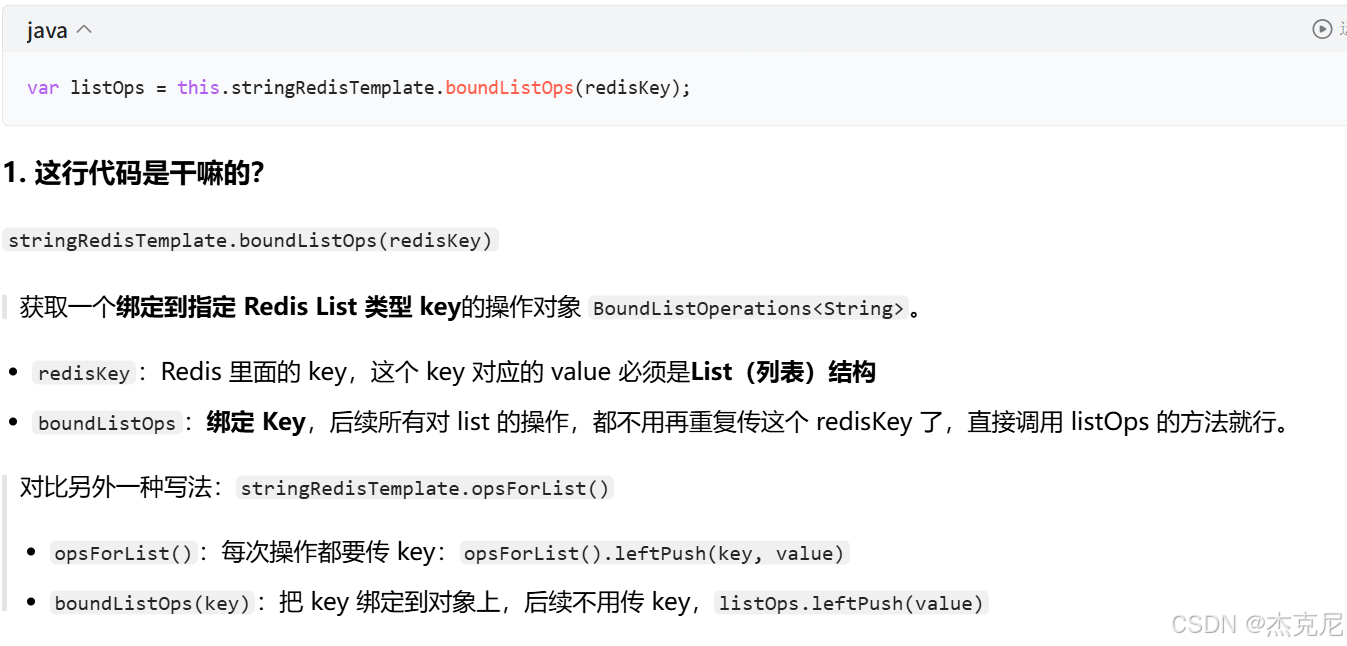
14下面代码作用?
var listOps = this.stringRedisTemplate.boundListOps(redisKey);
15怎么基于redis实现终止功能?
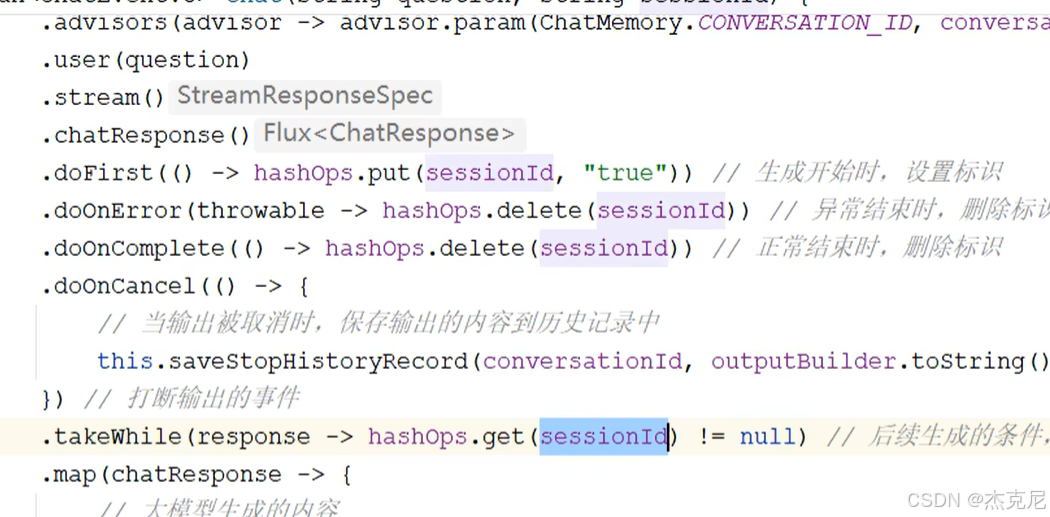
先配置好redis,(与agent的memory进行一系列配置(10里面有讲解))
private final StringRedisTemplate stringRedisTemplate;然后在chatclient里面使用ops即可
16开发中遇到的两个问题:
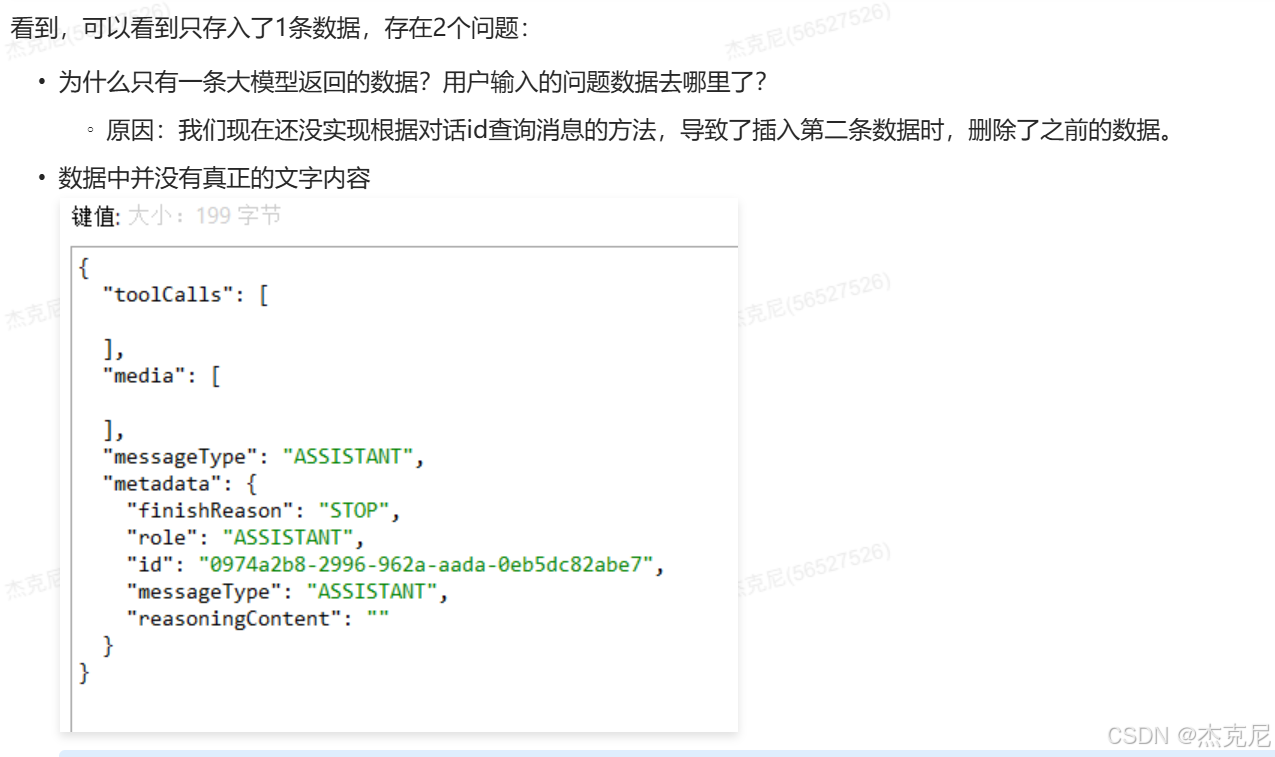
📚 没有文本内容写入,这是什么原因呢?
那是因为,
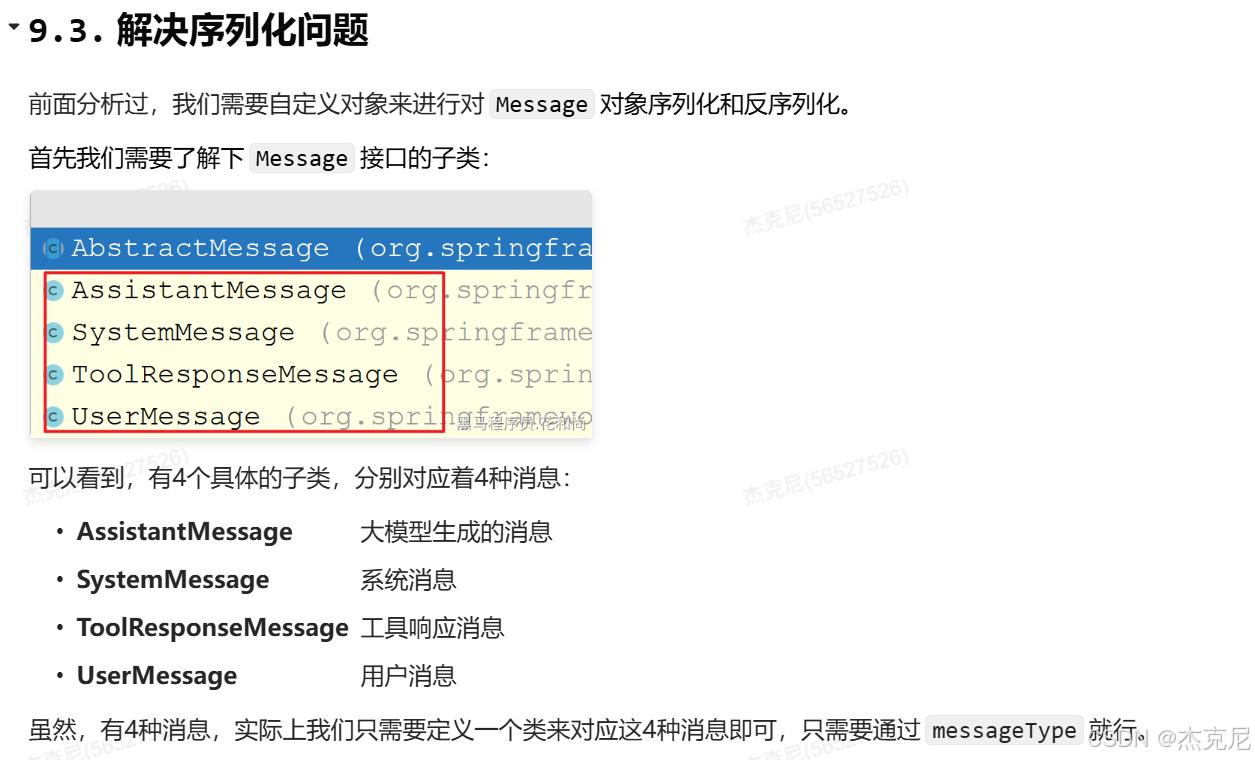
org.springframework.ai.chat.messages.Message接口的实现类org.springframework.ai.chat.messages.AbstractMessage中的textContent属性没有提供get方法,只提供了getText()方法,导致无法获取值。当然了,不使用
cn.hutool.json.JSONUtil,而是采用com.fasterxml.jackson.databind.ObjectMapper进行序列化,也是可以获取到值的,但是,在后面反序列化时也是会有问题的。所以,我们不直接对
org.springframework.ai.chat.messages.Message对象序列化,而是我们自定义一个对象,把值拷贝过来,进行做序列化,这样做的好处就是比较灵活,这个在后面也会有体现。
17bug重现
前面我们已经实现了【停止生成】和【会话记忆】的功能,这两个功能单独测试起来没问题,但是结合起来测试就会有问题。
点击停止生成它不会进行保存
📚 原因是这样的,停止是通过中断Flux流程完成的,Flux中断了,SpringAI就不会触发
ChatMemory的add方法,也就不会调用ChatMemoryRepository#saveAll方法了,所以就保存数据了。(这个不确定SpringAI是故意这么设计,还是这个版本的问题,目前1.0.0是最新版)。知道原因,就好解决问题了,既然
SpringAI不会记录,我们自己记录即可,但是,又有一个新的问题了,我们怎么知道Flux中断了呢?其实,
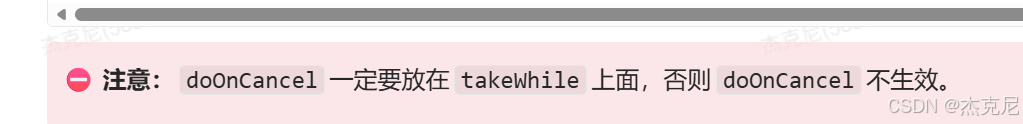
Flux是doOnCancel方法的,当流中断就会触发这个方法执行,所以,就需要在doOnCancel方法中实现自己存储的逻辑了。
    private final ChatMemory chatMemory;

    @Override
    public Flux<ChatEventVO> chat(String question, String sessionId) {
        // 获取对话id
        var conversationId = ChatService.getConversationId(sessionId);
        // 大模型输出内容的缓存器,用于在输出中断后的数据存储
        var outputBuilder = new StringBuilder();

        return this.chatClient.prompt()
                .system(promptSystem -> promptSystem
                        .text(this.systemPromptConfig.getChatSystemMessage().get()) // 设置系统提示语
                        .param("now", DateUtil.now()) // 设置当前时间的参数
                )
                .advisors(advisor -> advisor.param(AbstractChatMemoryAdvisor.CHAT_MEMORY_CONVERSATION_ID_KEY, conversationId))
                .user(question)
                .stream()
                .chatResponse()
                .doFirst(() -> { //输出开始,标记正在输出
                    GENERATE_STATUS.put(sessionId, true);
                })
                .doOnComplete(() -> { //输出结束,清除标记
                    GENERATE_STATUS.remove(sessionId);
                })
                .doOnError(throwable -> GENERATE_STATUS.remove(sessionId)) // 错误时清除标记
                .doOnCancel(() -> {
                    // 当输出被取消时,保存输出的内容到历史记录中
                    this.saveStopHistoryRecord(conversationId, outputBuilder.toString());
                })
                // 输出过程中,判断是否正在输出,如果正在输出,则继续输出,否则结束输出
                .takeWhile(s -> Optional.ofNullable(GENERATE_STATUS.get(sessionId)).orElse(false))
                .map(chatResponse -> {
                    // 获取大模型的输出的内容
                    String text = chatResponse.getResult().getOutput().getText();
                    // 追加到输出内容中
                    outputBuilder.append(text);
                    // 封装响应对象
                    return ChatEventVO.builder()
                            .eventData(text)
                            .eventType(ChatEventTypeEnum.DATA.getValue())
                            .build();
                })
                .concatWith(Flux.just(ChatEventVO.builder()  // 标记输出结束
                        .eventType(ChatEventTypeEnum.STOP.getValue())
                        .build()));
    }

    /**
     * 保存停止输出的记录
     *
     * @param conversationId 会话id
     * @param content        大模型输出的内容
     */
    private void saveStopHistoryRecord(String conversationId, String content) {
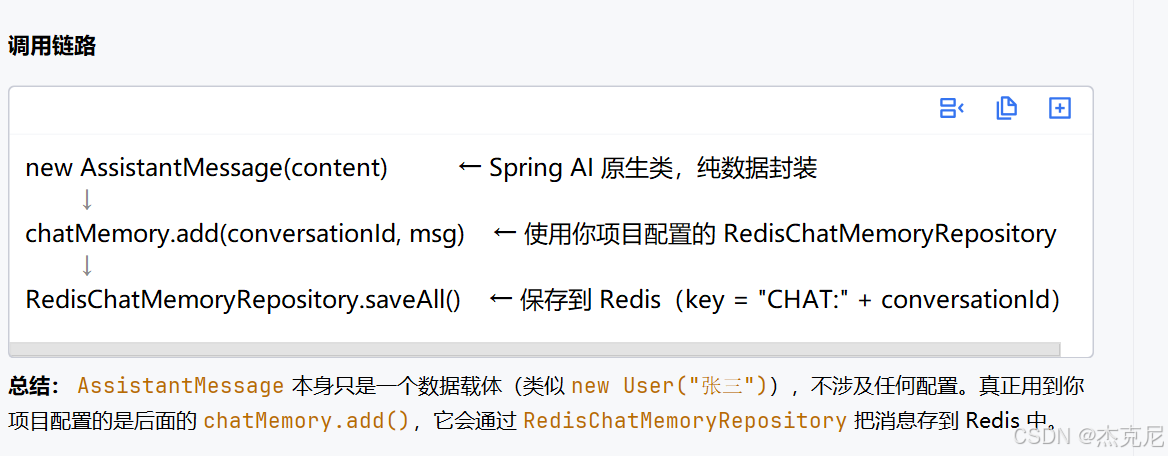
        this.chatMemory.add(conversationId, new AssistantMessage(content));
    }
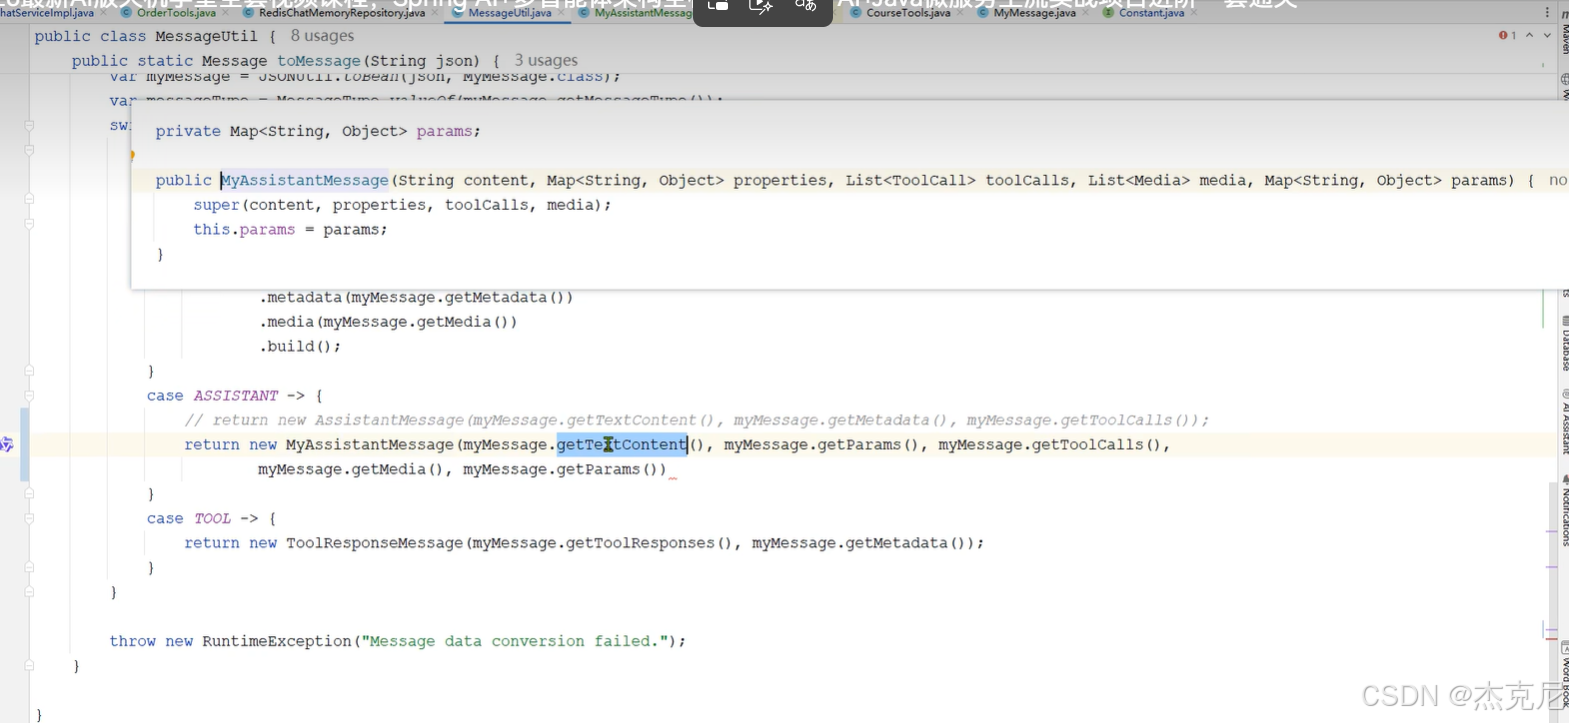
18new AssistantMessage(content) 这个调用的哪里?用没用我项目中的配置?
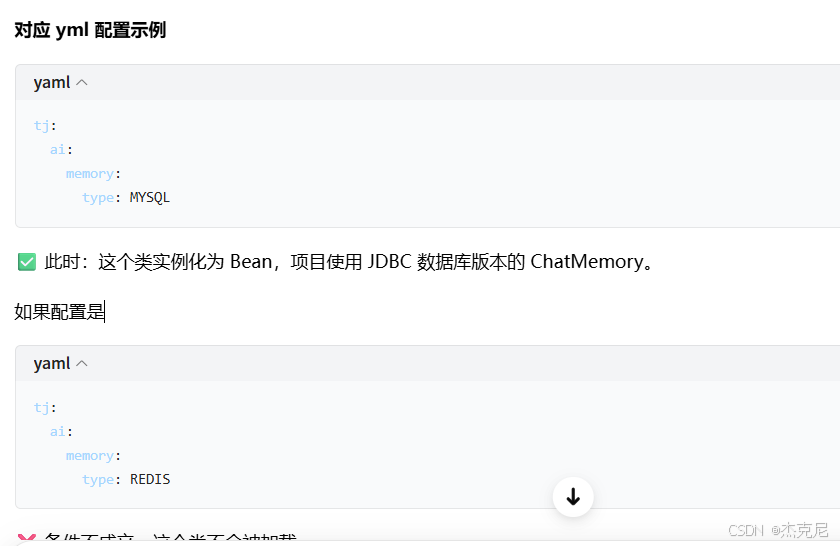
19基于 MySQL 和 MongoDB 两种方式,实现会话记忆,并且通过配置的方式来进行选择
20下面注解有什么用?
@ConditionalOnProperty (prefix = "tj.ai.memory", value = "type", havingValue = "MYSQL")
这样就可以实现切换三种实现会话记忆方式
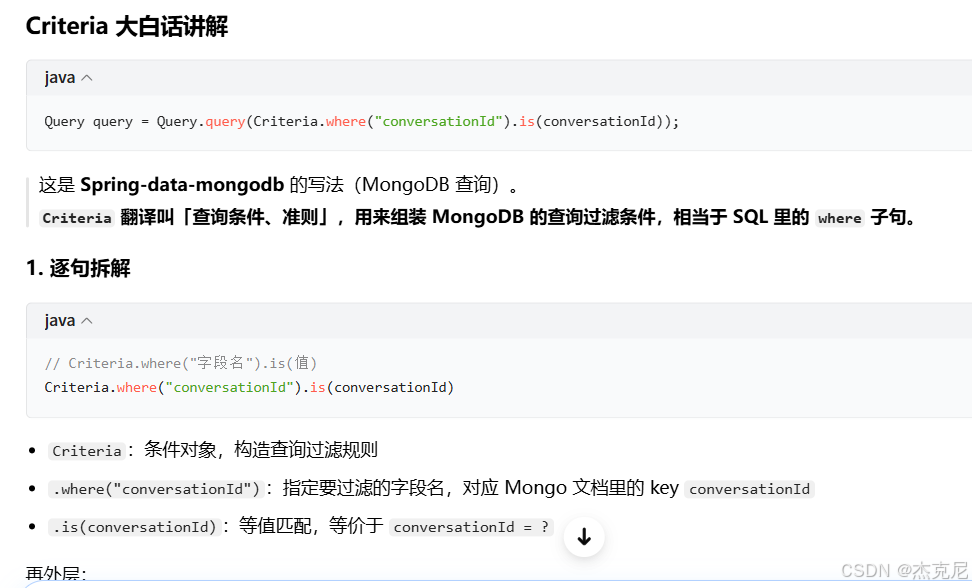
21什么是 Criteria
Query query = Query.query(Criteria.where("conversationId").is(conversationId));
22常量的新写法(层级分明)
package com.tianji.aigc.constants;

public interface Constant {

    String REQUEST_ID = "requestId";
    String USER_ID = "userId";
    String ID = "id";
    String STOP = "STOP";

    interface Tools {
        String QUERY_COURSE_BY_ID = "根据课程id查询课程详细信息";
        String PRE_PLACE_ORDER = "购买课程预下单操作";
    }

    interface ToolParams {
        String COURSE_ID = "课程id";
        String COURSE_IDS = "课程id列表";
    }

}
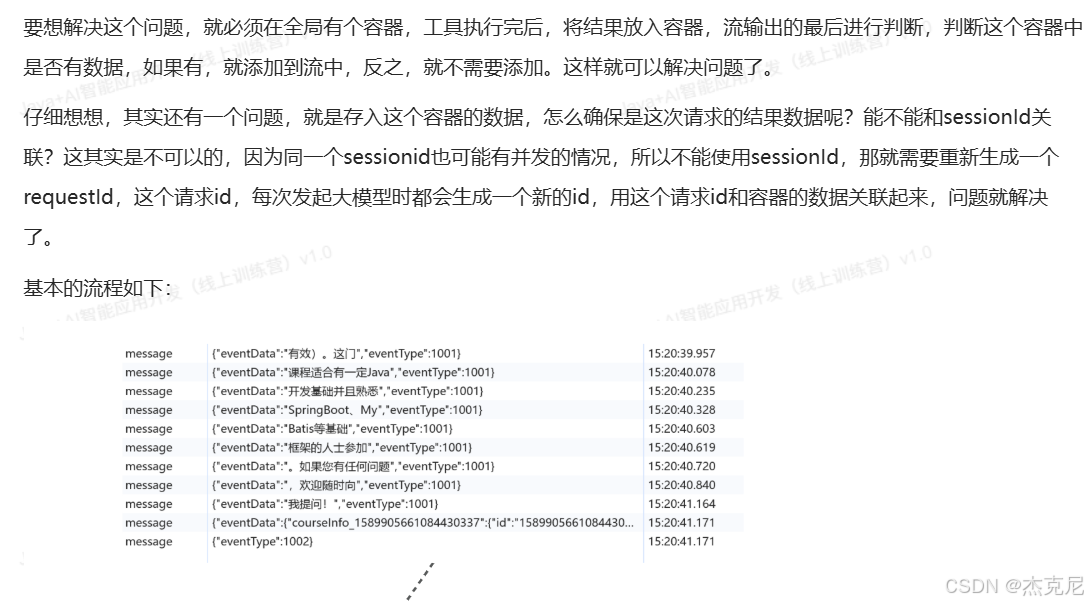
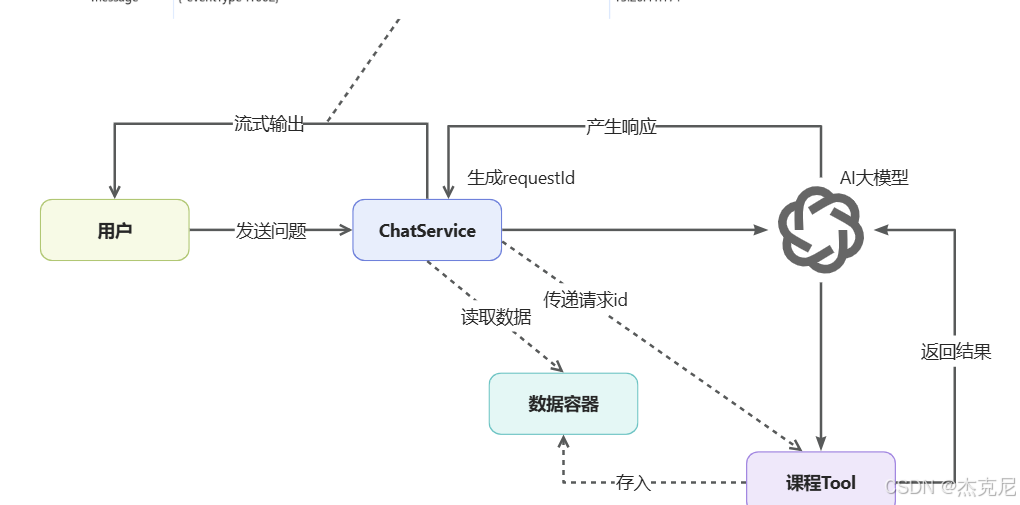
23Tool执行的结果已经给了大模型,我们在Flux输出时如何获取到呢?
思路:说白了就是使用一个请求id传递给工具(使用toolContext),工具将请求id和数据存入本地内存,然后使用Flux.defer()最后获取数据
(
concatWith(另一个Flux):当前上游数据流全部跑完、全部发射完毕之后,才会执行、拼接后面这一段流。).concatWith(Flux.defer(() -> { var result = ToolResultHolder.get(requestId); if (ObjectUtil.isNotEmpty(result)) { ToolResultHolder.remove(requestId); // 工具被调用了,需要向前端传递参数 return Flux.just(ChatEventVO.builder() .eventType(ChatEventTypeEnum.PARAM.getValue()) .eventData(result) .build(), STOP_EVENT); } return Flux.just(STOP_EVENT); // 结束标识 }));
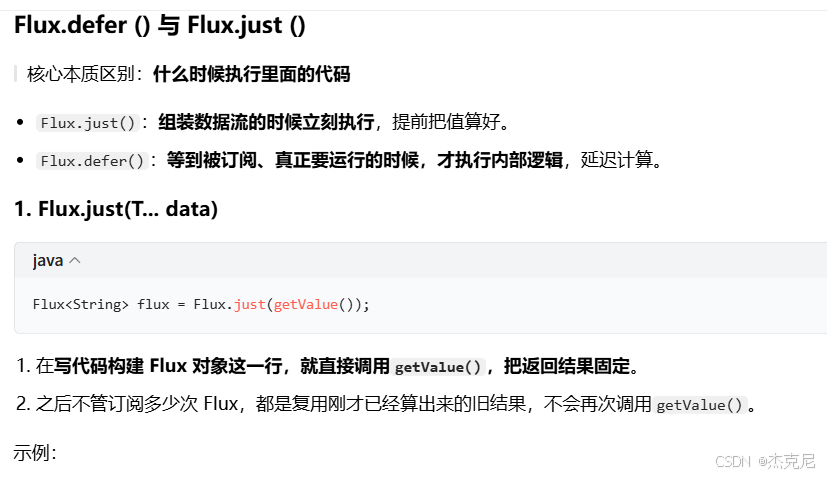
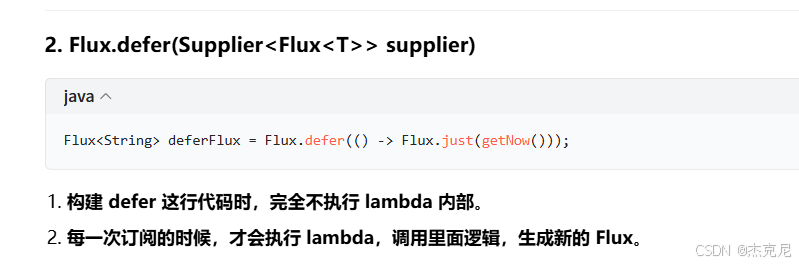
24Flux.defer 和 Flux.just?
25bug重现?
课程查询和预下单功能,给前端返回的数据中,包含了
eventType为1003的数据,这个叫作额外数据,给前端提供,前端是不会显示到页面的,正常对话是没问题的,但是,数据存储到Redis是没有保存进去的
其实就是将请求id与会话id通过RoolResultHolder进行关联
序列化时使用将请求id与会话id通过RoolResultHolder进行关联
反序列化时将重写AssisstanceMessage
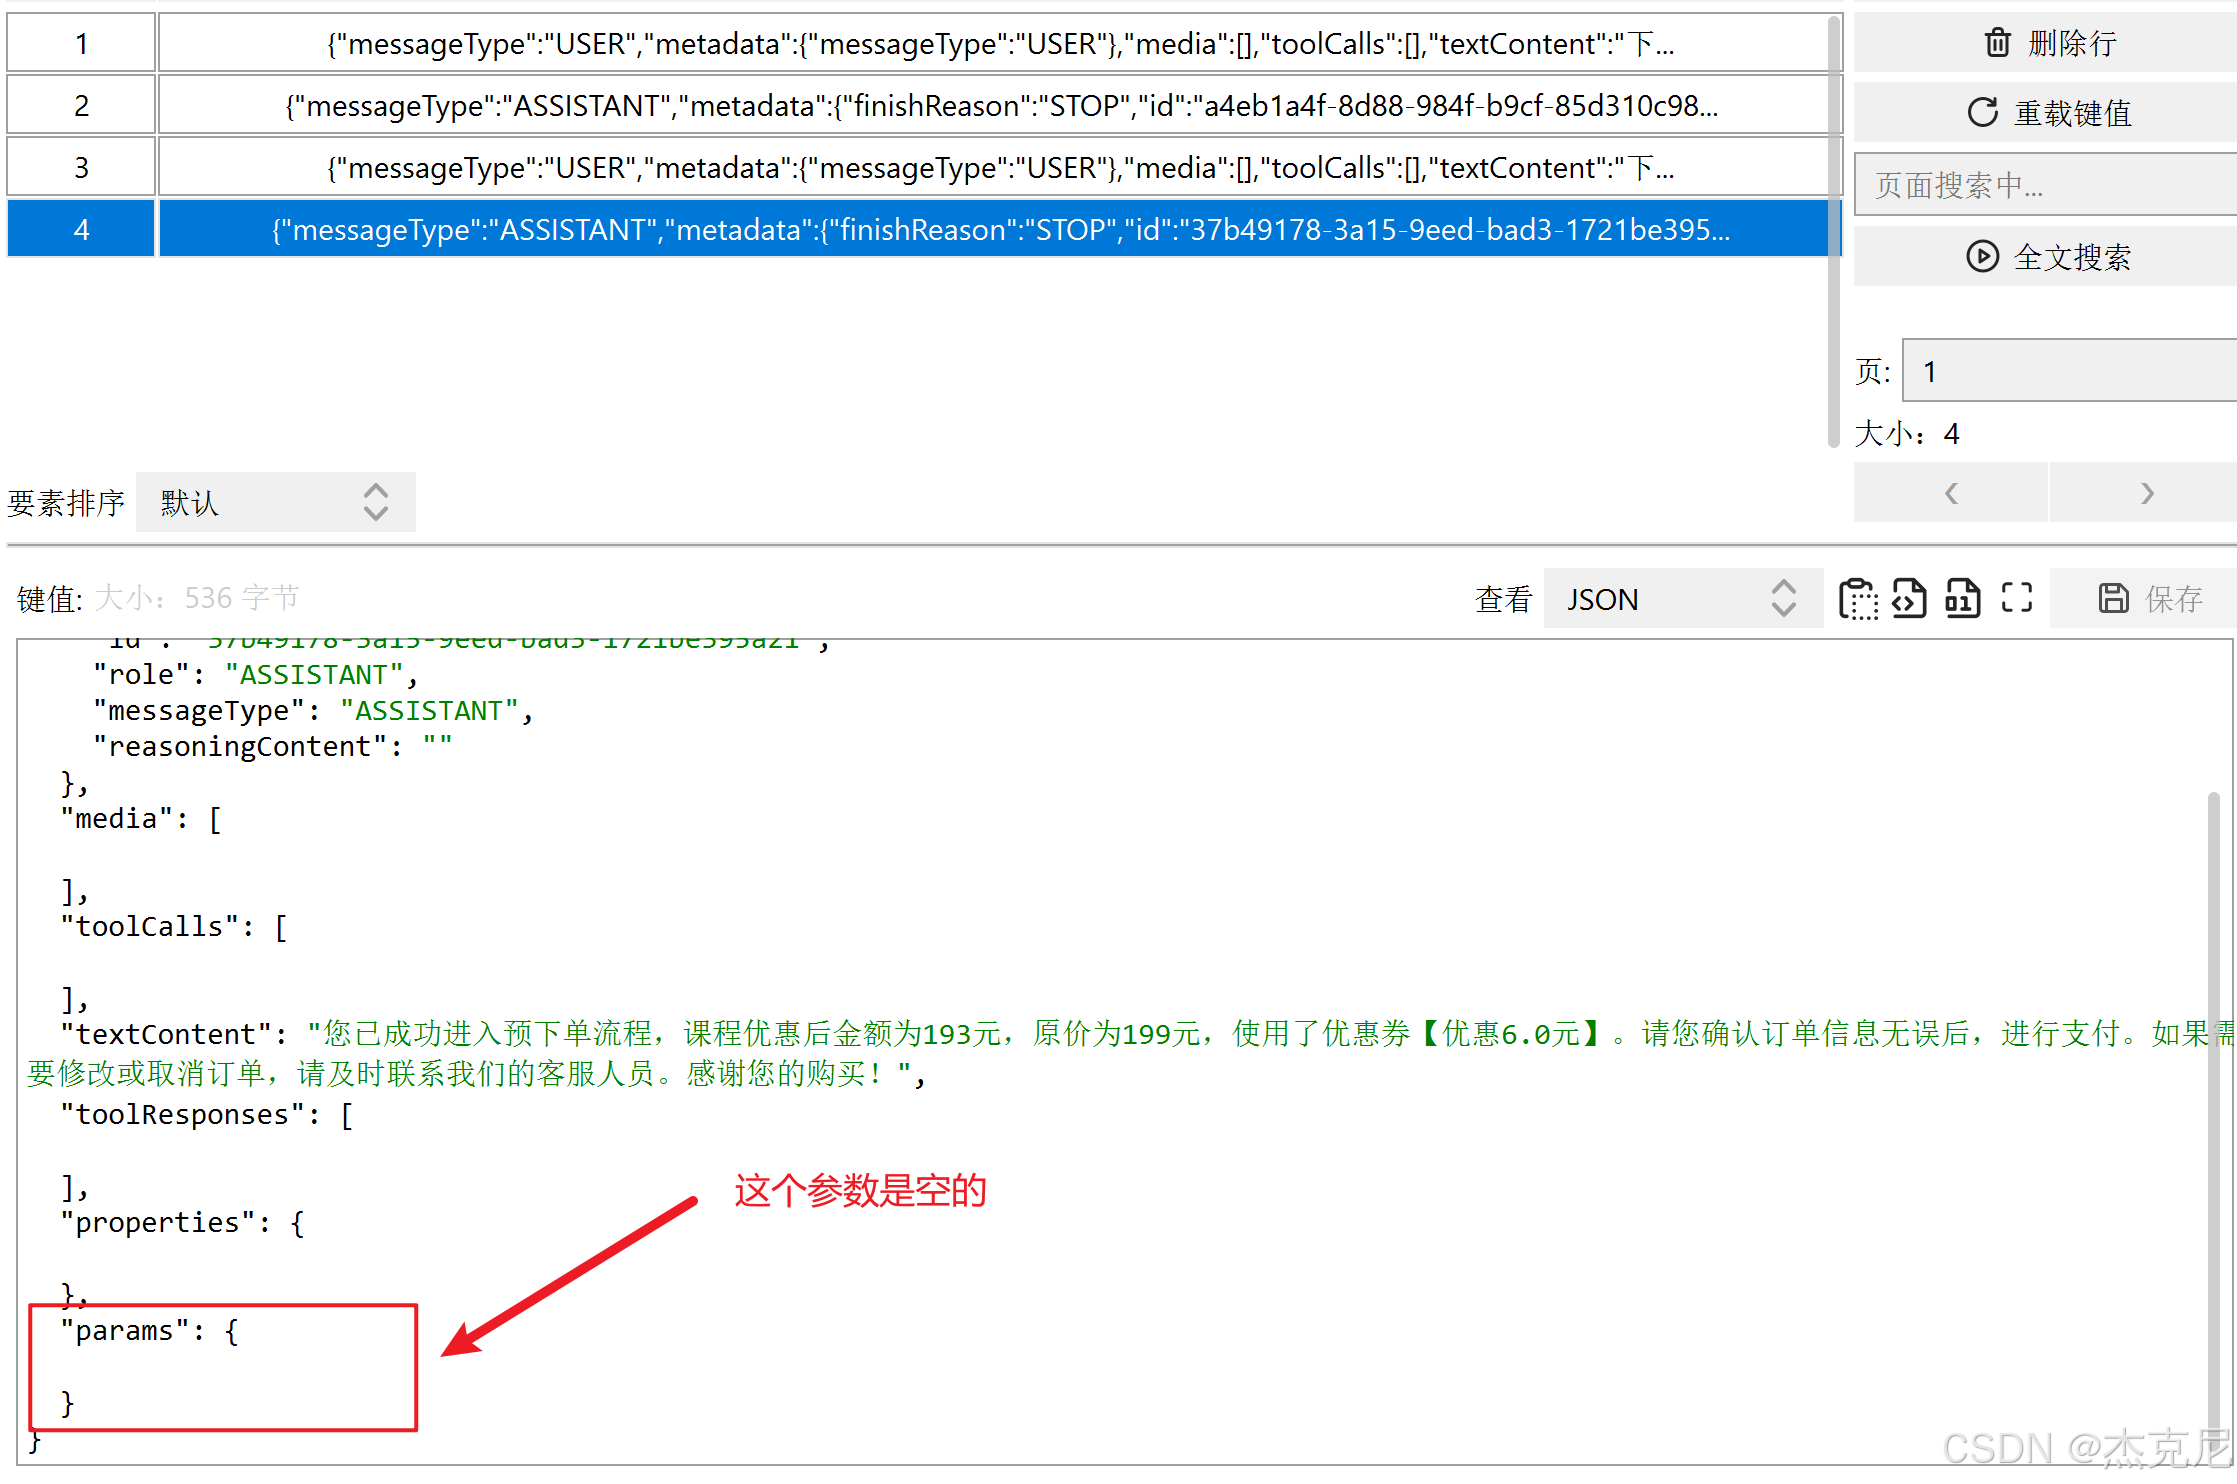
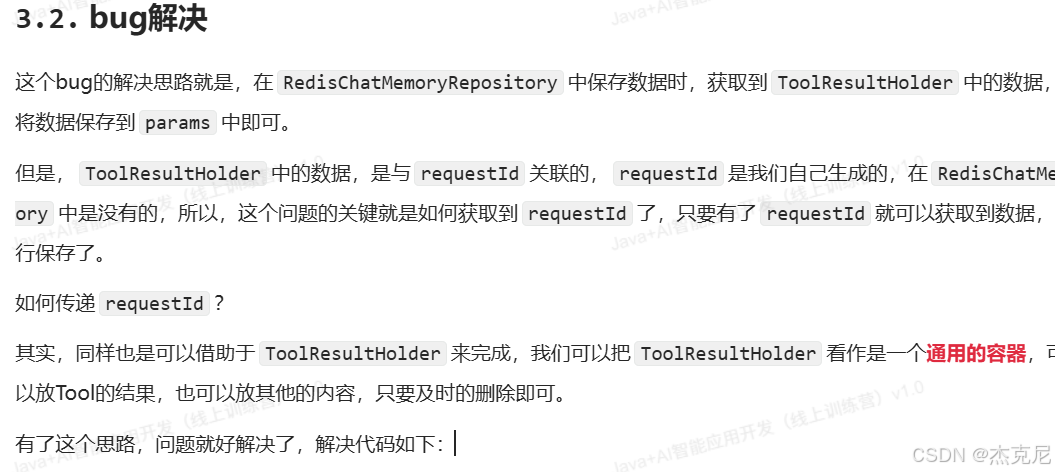
26为什么redis不会保存额外数据?
课程查询和预下单功能,给前端返回的数据中,包含了 eventType 为 1003 的数据,这个叫作额外数据,给前端提供,前端是不会显示到页面的,正常对话是没问题的,但是,数据存储到 Redis 是没有保存进去的, 为什么不会保存额外数据?
eventType=1003 的 PARAM 额外数据,是预下单 / 课程查询工具返回的业务对象,专门给前端业务使用,不是大模型对话文本。 当前 ChatMemory(Advisor)只会保存用户消息、大模型回答、原生 ToolMessage 这类 LLM 对话消息,用于大模型后续推理。 我们这套代码里,这个业务 VO 只存在内存 ToolResultHolder,在 SSE 结束后单独推送给前端,没有编写把这个业务对象写入 Redis 的逻辑,所以不会保存进 Redis。 原生 ToolMessage 会保存工具返回的文本摘要进 Redis,但完整业务 VO 是我们自定义的前端附属数据,不属于对话消息,不会自动持久化。
说白了就是咱自定义的扩展参数不能往AssistanceMessage这些里面丢
但是我们可以自定义类继承AssistanceMessage,然后使用它进行反序列化
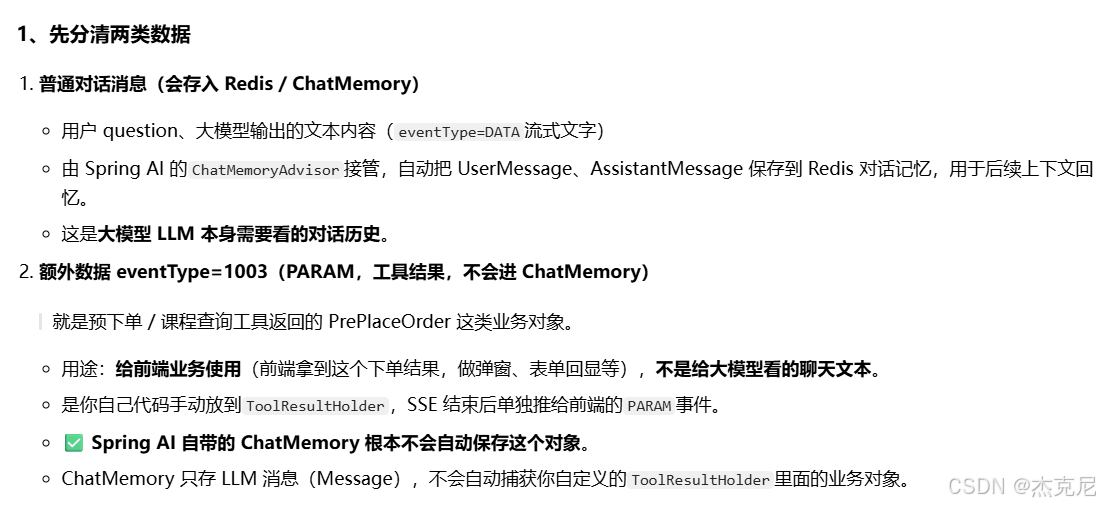
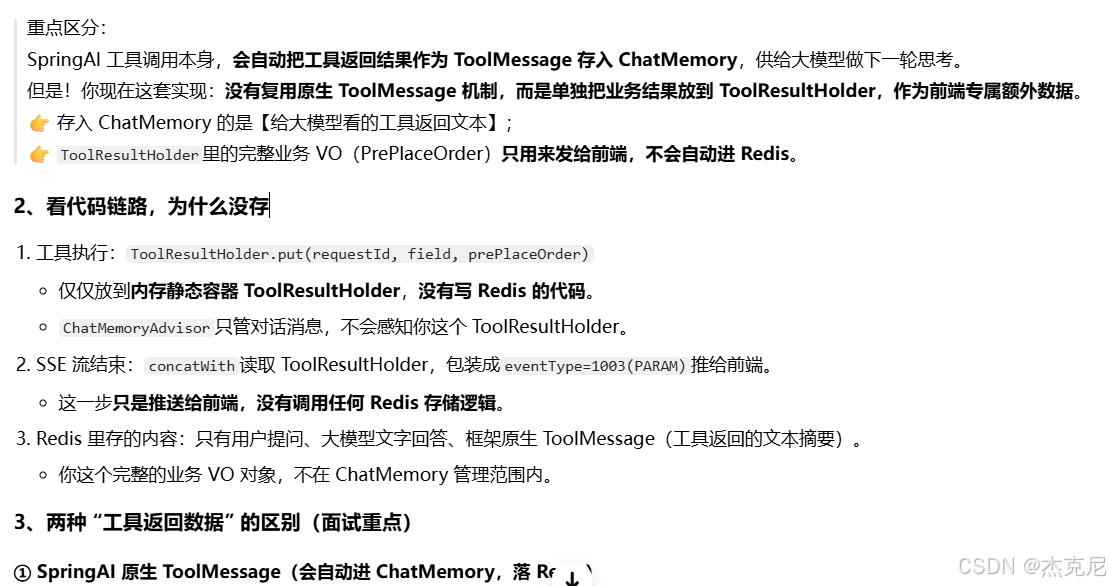
27 为什么要用知识库
之所以要使用知识库,是因为我们在做课程推荐时,需要先从知识库匹配到课程,再通过课程id查询课程信息进行推荐,如果没有知识库,就无法根据学生的需求进行推荐,所以必须要用到知识库了。
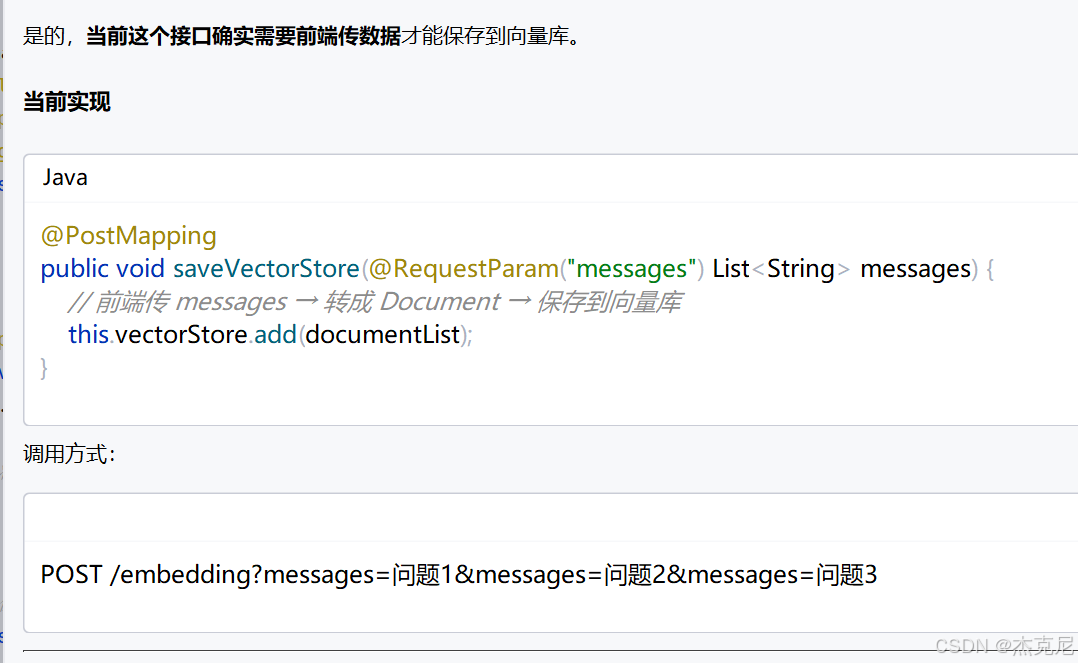
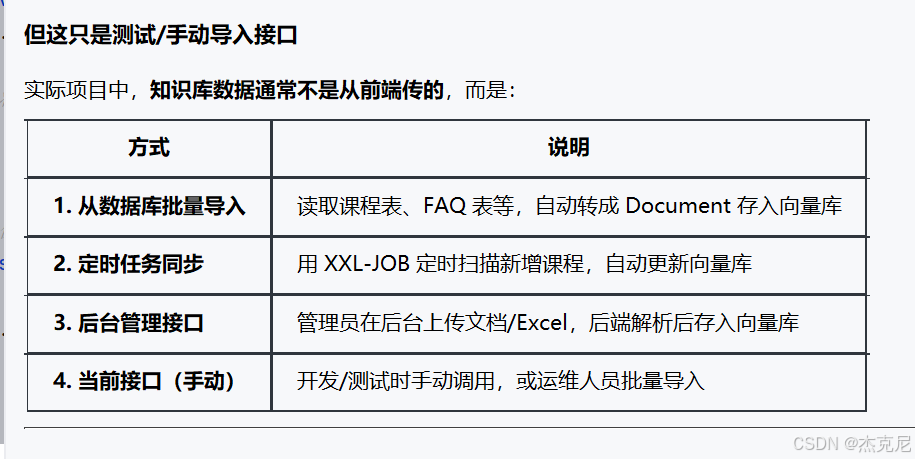
28如果使用es的话 那个数据是不是得从前端传来才能保存进知识库?
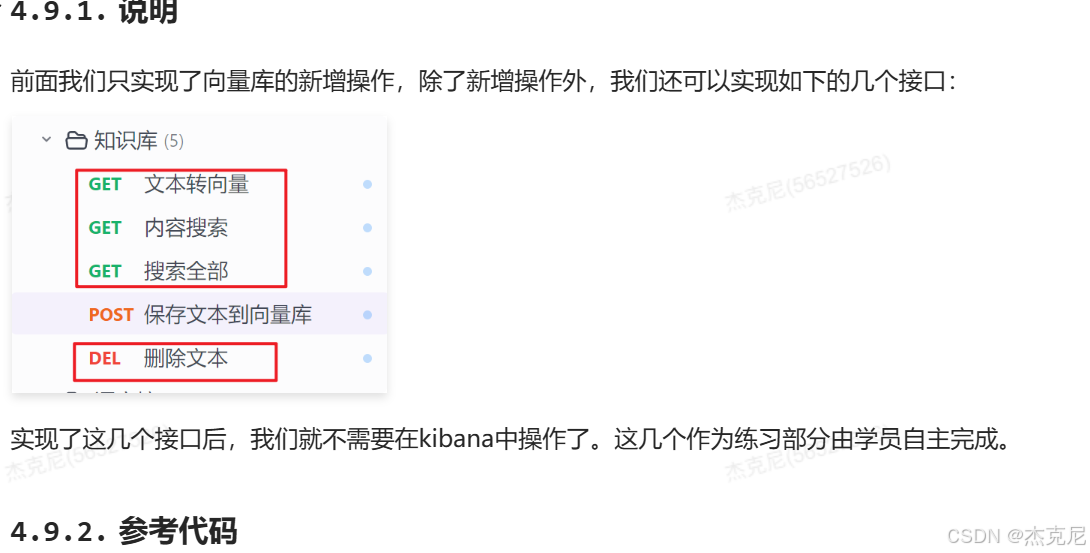
29俩作业:
package com.tianji.aigc.controller;

import cn.hutool.core.collection.CollStreamUtil;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.ai.document.Document;
import org.springframework.ai.embedding.EmbeddingModel;
import org.springframework.ai.embedding.EmbeddingResponse;
import org.springframework.ai.vectorstore.SearchRequest;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.web.bind.annotation.*;

import java.util.List;

@Slf4j
@RestController
@RequestMapping("/embedding")
@RequiredArgsConstructor
public class EmbeddingController {

    private final VectorStore vectorStore;
    private final EmbeddingModel embeddingModel;

    @PostMapping
    public void saveVectorStore(@RequestParam("messages") List<String> messages) {
        log.info("保存到向量数据库中,消息数据:{}", messages);
        //构建文档
        List<Document> documents = CollStreamUtil.toList(messages, message -> Document.builder()
                .text(message)
                .build());
        //存储到向量数据库中
        this.vectorStore.add(documents);
        log.info("保存到向量数据库成功, 数量:{}", messages.size());
    }


    @GetMapping
    public EmbeddingResponse embed(@RequestParam("message") String message) {
        return this.embeddingModel.embedForResponse(List.of(message));
    }

    @DeleteMapping
    public void deleteVectorStore(@RequestParam("ids") List<String> ids) {
        // 删除向量数据库中的数据
        this.vectorStore.delete(ids);
    }

    @GetMapping("/search")
    public List<Document> search(@RequestParam("message") String message) {
        return this.vectorStore.similaritySearch(SearchRequest.builder().query(message).topK(5).build());
    }

    @GetMapping("/search/all")
    public List<Document> searchAll() {
        // 搜索全部数据
        return this.vectorStore.similaritySearch(SearchRequest.builder().query("").topK(999).build());
    }

}
30怎么按照日期将数据进行分组?
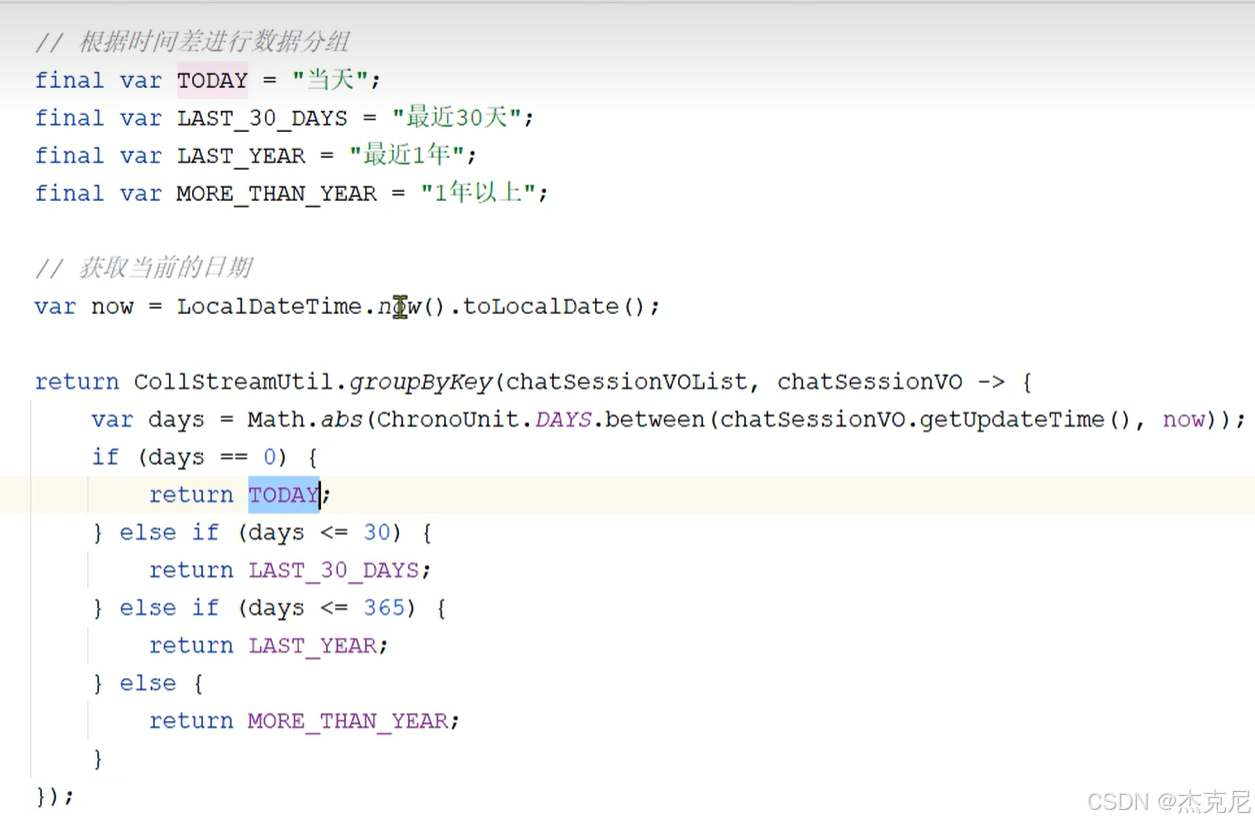
31作业
1更新历史会话标题
2基于大模型实现根据对话内容总结出对话标题
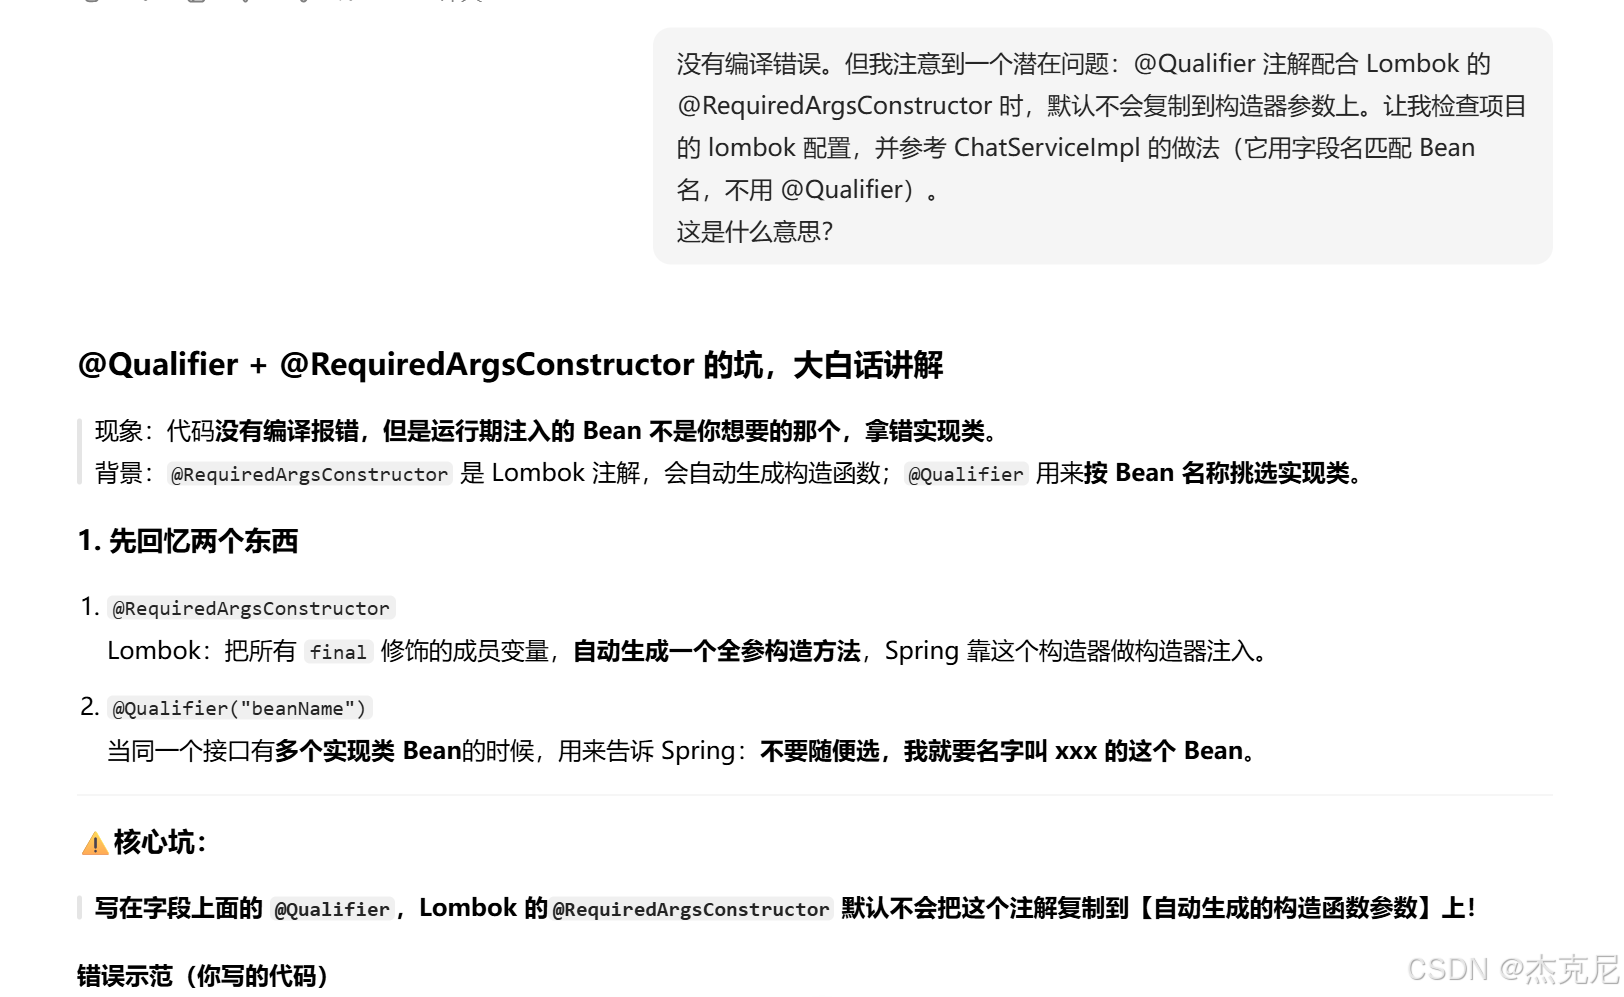
32@Qualifier + @RequiredArgsConstructor 的坑
33为什么向量库不在初始化ChatClient时配置,而是在使用时配置?
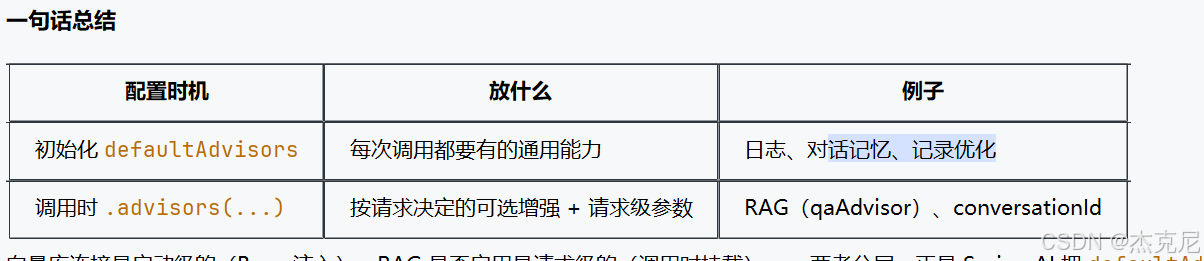
先澄清一个概念:向量库本身其实是在启动时就初始化好的——RedisVectorStore 由 starter 自动配置成 Bean,在 ChatServiceImpl 第47行 就注入了。"使用时才配置"的只是RAG 增强开关(QuestionAnswerAdvisor),即"这次请求要不要去查向量库"。
34智能体架构模型有哪6种?
前面我们已经完成了天机AI助手智能体功能的开发,实际上我们实现的方式只是最为基础的一种模式,一般应用系统中的智能体架构有6种,分别是:
- 增强型智能体
- 链式工作流智能体
- 路由工作流智能体
- 并行工作流智能体
- 协调器工作流智能体
- 评估优化工作流智能体
下面,我们一起来了解下这6种架构模式,重点要关注:路由工作流智能体。
模式选型建议,根据业务需求选择:
- 简单任务 → 增强型智能体 / 链式工作流智能体
- 多分支处理 → 路由模式
- 高实时性 → 并行化(需任务可拆分)
- 超复杂任务 → 协调器工作流智能体
- 超高可靠性 → 评估优化工作流智能体
模式名称
控制方式
延迟水平
可靠性
典型应用场景
开发复杂度
增强型智能体
直接输出
最低
低
简单问答、内容润色
简单
链式工作流智能体
线性顺序执行
中等
中高
分阶段任务(如大纲→内容→格式优化)
中等
路由工作流智能体
条件分支选择
低-中等
中
多领域处理(如客服分流转人工)
中等
并行工作流智能体
多模型并发执行
中等
高
可靠性敏感任务(如医疗诊断辅助)
较高
协调器工作流智能体
动态任务分解+调度
高
最高
复杂业务(如商业智能分析系统)
极高
评估优化工作流智能体
迭代优化+反馈修正
最高
极高
质量敏感场景(如法律文件生成)
高
35Agent抽象类怎么写?
package com.tianji.aigc.agent;

import cn.hutool.core.util.IdUtil;
import cn.hutool.core.util.ObjectUtil;
import cn.hutool.core.util.StrUtil;
import com.tianji.aigc.config.ToolResultHolder;
import com.tianji.aigc.constants.Constant;
import com.tianji.aigc.enums.ChatEventTypeEnum;
import com.tianji.aigc.service.ChatService;
import com.tianji.aigc.service.ChatSessionService;
import com.tianji.aigc.vo.ChatEventVO;
import com.tianji.common.utils.UserContext;
import jakarta.annotation.Resource;
import lombok.extern.slf4j.Slf4j;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.memory.ChatMemory;
import org.springframework.ai.chat.messages.AssistantMessage;
import org.springframework.data.redis.core.StringRedisTemplate;
import reactor.core.publisher.Flux;

import java.util.Map;

@Slf4j
public abstract class AbstractAgent implements Agent {

    public static final ChatEventVO STOP_EVENT = ChatEventVO.builder().eventType(ChatEventTypeEnum.STOP.getValue()).build();

    @Resource
    private ChatClient chatClient;
    @Resource
    private StringRedisTemplate stringRedisTemplate;
    @Resource
    private ChatMemory chatMemory;
    @Resource
    private ChatSessionService chatSessionService;

    private static final String GENERATE_STATUS_KEY = "GENERATE_STATUS";

    @Override
    public Flux<ChatEventVO> processStream(String question, String sessionId) {
        // 生成请求id
        var requestId = this.generateRequestId();
        var hashOps = this.stringRedisTemplate.boundHashOps(GENERATE_STATUS_KEY);
        // 将会话id转化为对话id
        var conversationId = ChatService.getConversationId(sessionId);
        // 大模型输出内容的缓存器,用于在输出中断后的数据存储
        var outputBuilder = new StringBuilder();
        // 获取到当前登录的用户id
        var userId = UserContext.getUser();
        //更新会话时间
        this.chatSessionService.update(sessionId, question, userId);

        return this.getChatClientRequest(question, sessionId, requestId)
                .stream()
                .chatResponse()
                .doFirst(() -> hashOps.put(sessionId, "true")) // 生成开始时,设置标识
                .doOnError(throwable -> hashOps.delete(sessionId)) // 异常结束时,删除标识
                .doOnComplete(() -> hashOps.delete(sessionId)) // 正常结束时,删除标识
                .doOnCancel(() -> {
                    // 当输出被取消时,保存输出的内容到历史记录中
                    this.saveStopHistoryRecord(conversationId, outputBuilder.toString());
                }) // 打断输出的事件
                .takeWhile(response -> hashOps.get(sessionId) != null) // 后续生成的条件,true:继续生成,false:停止生成
                .map(chatResponse -> {
                    // 大模型生成的内容
                    var text = chatResponse.getResult().getOutput().getText();
                    // 追加到输出内容中
                    outputBuilder.append(text);

                    // 获取到消息的结束原因
                    var finishReason = chatResponse.getResult().getMetadata().getFinishReason();
                    if (StrUtil.equals(finishReason, Constant.STOP)) {
                        // 获取到消息id
                        var messageId = chatResponse.getMetadata().getId();
                        // 将消息id与请求id进行关联
                        ToolResultHolder.put(messageId, Constant.REQUEST_ID, requestId);
                    }

                    return ChatEventVO.builder()
                            .eventData(text)
                            .eventType(ChatEventTypeEnum.DATA.getValue())
                            .build();
                })
                .concatWith(Flux.defer(() -> {
                    var result = ToolResultHolder.get(requestId);
                    if (ObjectUtil.isNotEmpty(result)) {
                        ToolResultHolder.remove(requestId);
                        // 工具被调用了,需要向前端传递参数
                        return Flux.just(ChatEventVO.builder()
                                .eventType(ChatEventTypeEnum.PARAM.getValue())
                                .eventData(result)
                                .build(), STOP_EVENT);
                    }
                    return Flux.just(STOP_EVENT); // 结束标识
                }));
    }

    @Override
    public String process(String question, String sessionId) {
        // 生成请求id
        var requestId = this.generateRequestId();
        // 获取到当前登录的用户id
        var userId = UserContext.getUser();
        //更新会话时间
        this.chatSessionService.update(sessionId, question, userId);

        return this.getChatClientRequest(question, sessionId, requestId)
                .call()
                .content();
    }

    private ChatClient.ChatClientRequestSpec getChatClientRequest(String question, String sessionId, String requestId) {
        //通用的请求参数,system和advisors里面并不写具体参数
        return this.chatClient.prompt()
                .system(promptSystemSpec -> promptSystemSpec.text(this.systemMessage()).params(this.systemMessageParams()))
                .advisors(advisorSpec -> advisorSpec.advisors(this.advisors()).params(this.advisorParams(sessionId, requestId)))
                .tools(this.tools())
                .toolContext(this.toolContext(sessionId, requestId))
                .user(question);
    }

    /**
     * 保存停止输出的记录
     *
     * @param conversationId 会话id
     * @param content        大模型输出的内容
     */
    private void saveStopHistoryRecord(String conversationId, String content) {
        this.chatMemory.add(conversationId, new AssistantMessage(content));
    }

    private String generateRequestId() {
        return IdUtil.fastSimpleUUID();
    }

    @Override
    public void stop(String sessionId) {
        var hashOps = this.stringRedisTemplate.boundHashOps(GENERATE_STATUS_KEY);
        hashOps.delete(sessionId);
    }

    @Override
    public Map<String, Object> advisorParams(String sessionId, String requestId) {
        // 将会话id转化为对话id
        var conversationId = ChatService.getConversationId(sessionId);
        return Map.of(ChatMemory.CONVERSATION_ID, conversationId);
    }
}
36路由工作流智能体 是怎么发挥作用的?就是那个路由智能体怎么调用其他智能体呢?
37项目中有两个类继承implements ChatService?
@ConditionalOnProperty(prefix = "tj.ai", name = "chat-type", havingValue = "ROUTE")项目中有两个类继承implements ChatService?(一个增强型智能体/一个路由型工作流智能体),那该怎么选择,就看这个配置了,.yml配置成谁就用谁
38bug重现
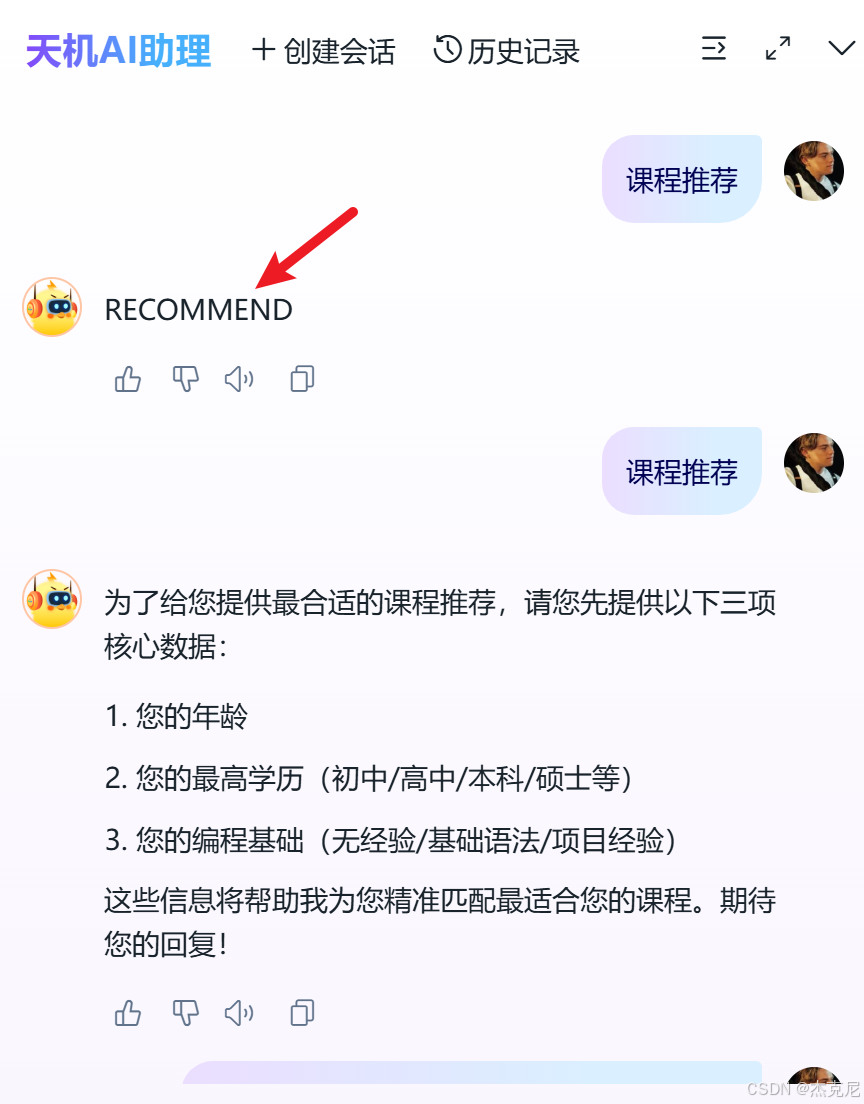
打字课程推荐,它把recoomand显示出来了
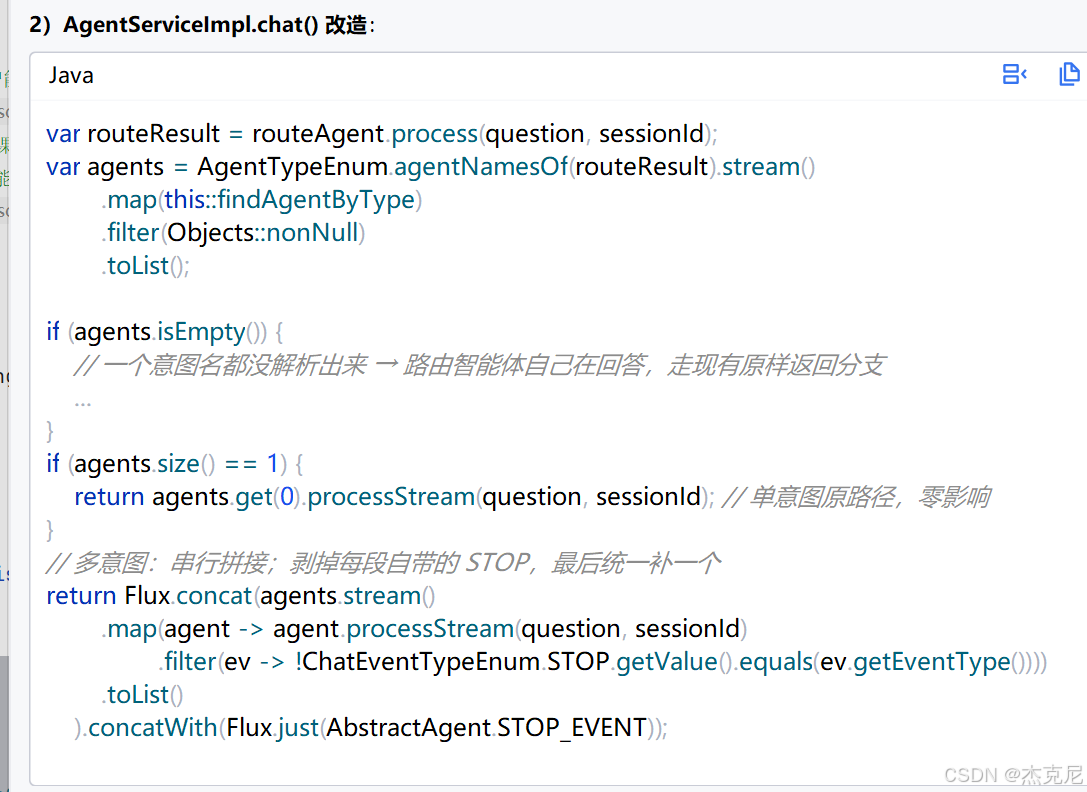
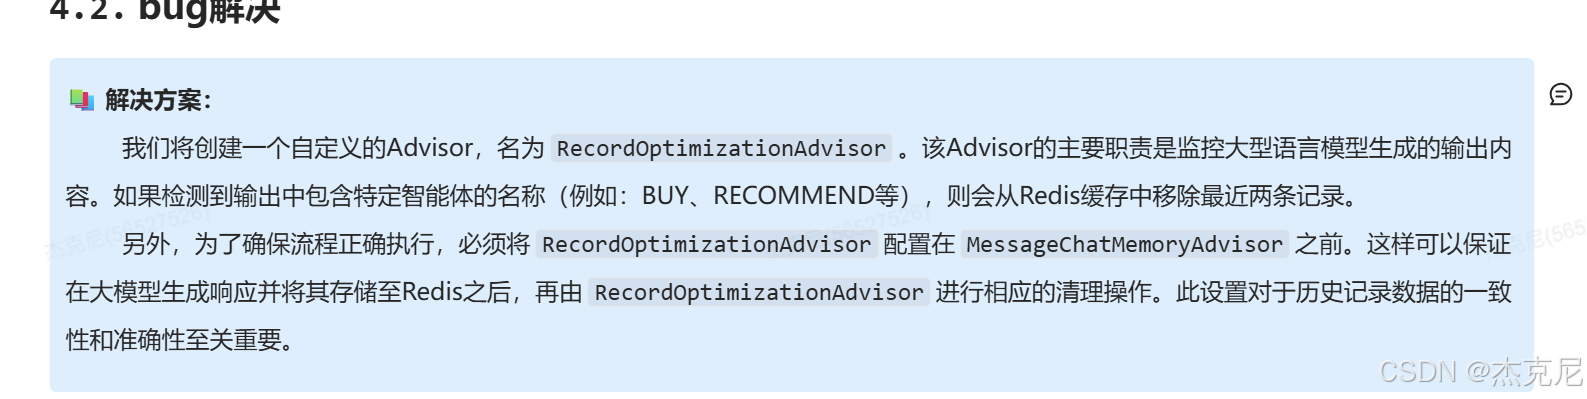
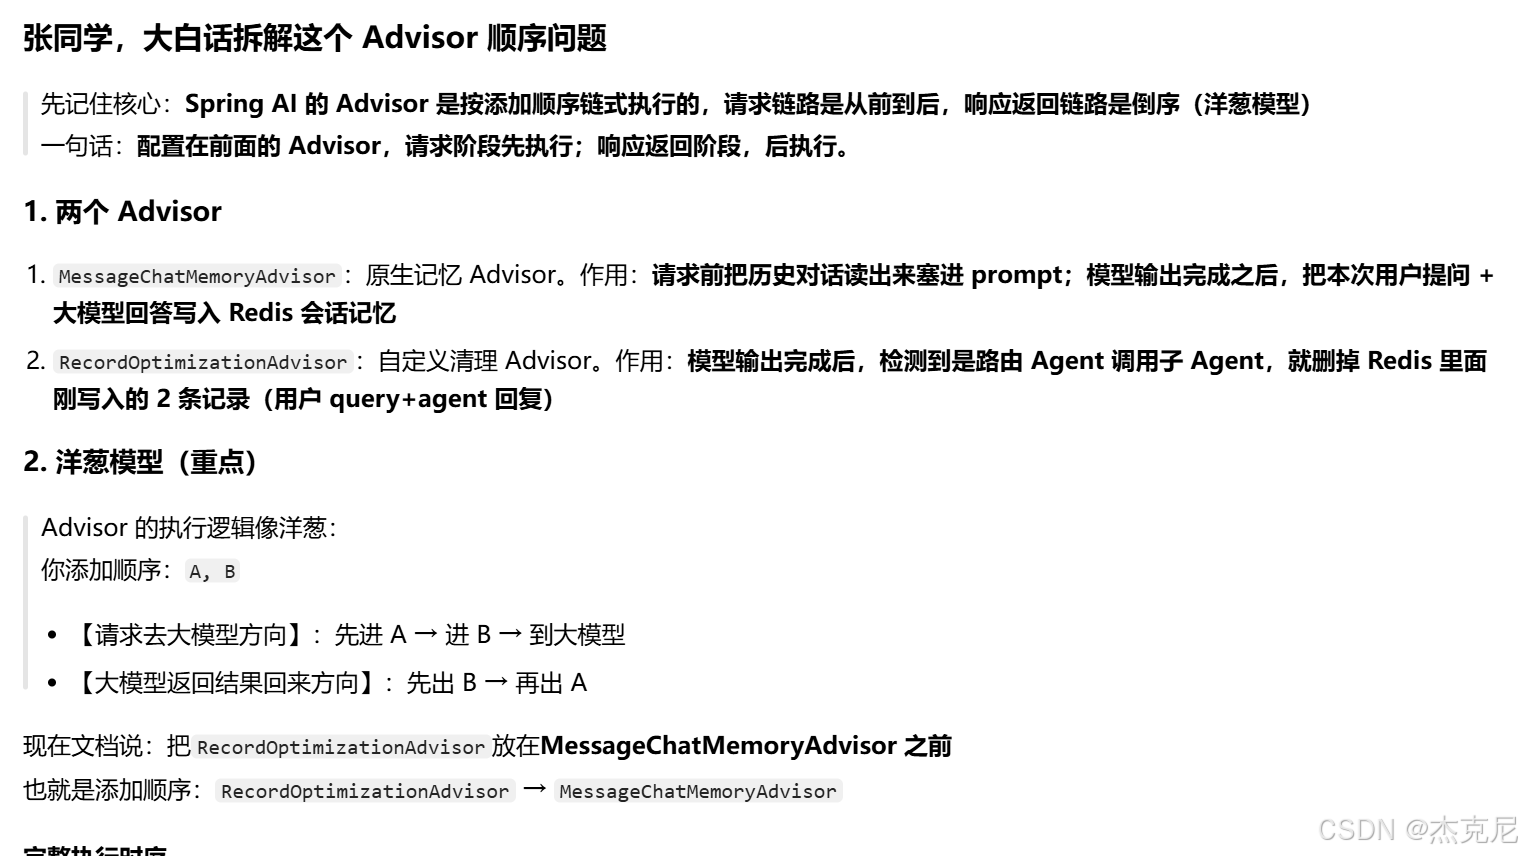
这个bug靠问题42的代码解决,思路就是将这个代码的advisor注册到agent中,然后每次执行先判断是不是那个agent类型,如果是的话就删除(使用order设置了顺序,就是这个advisor的before最先执行,after最后执行;中间是chatmemory的before和after,)//只要设置的order越小,它的before越先执行,after越后执行
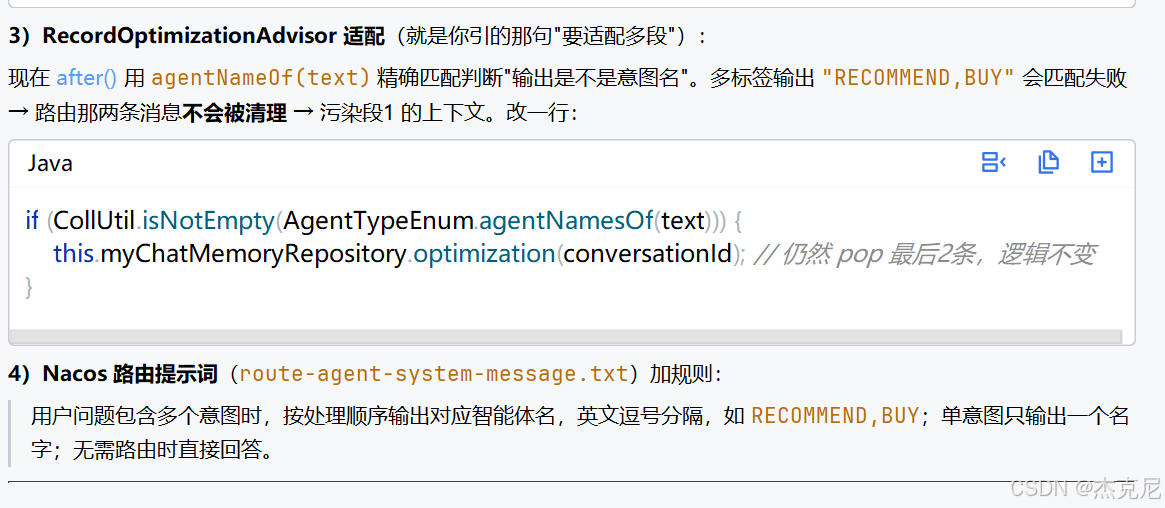
39问题:那要是第一轮就有"推荐个课"和"帮我下单" 它能解决吗?
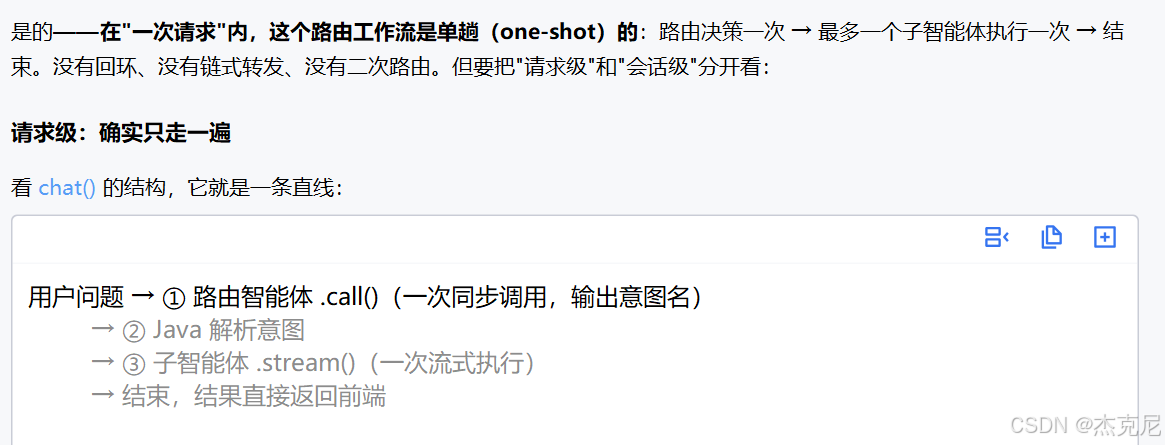
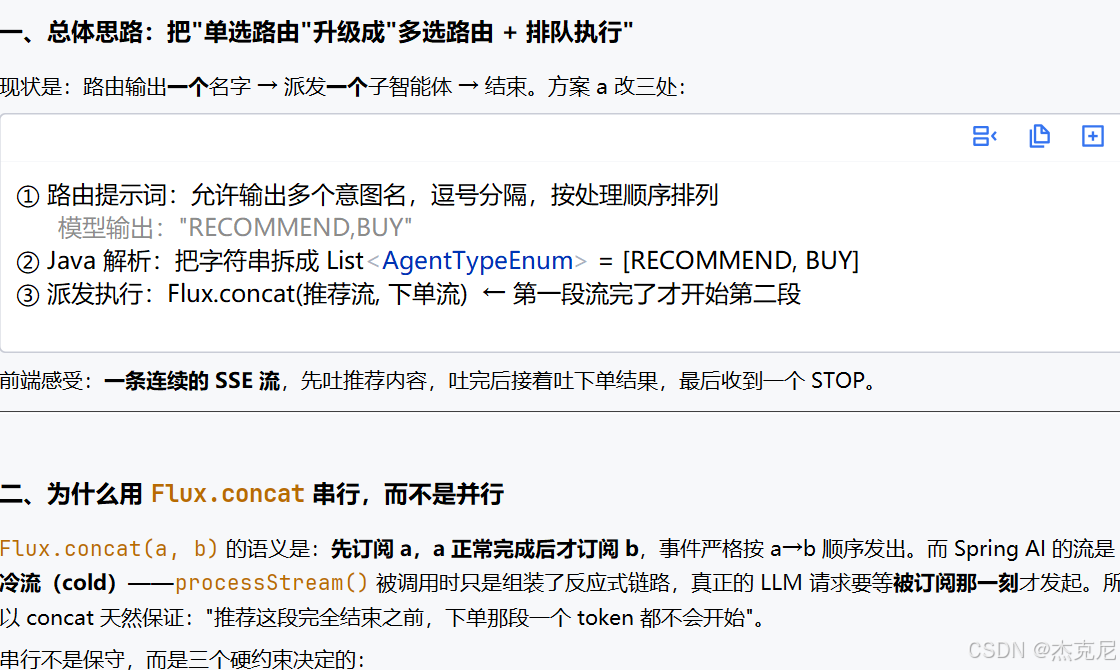
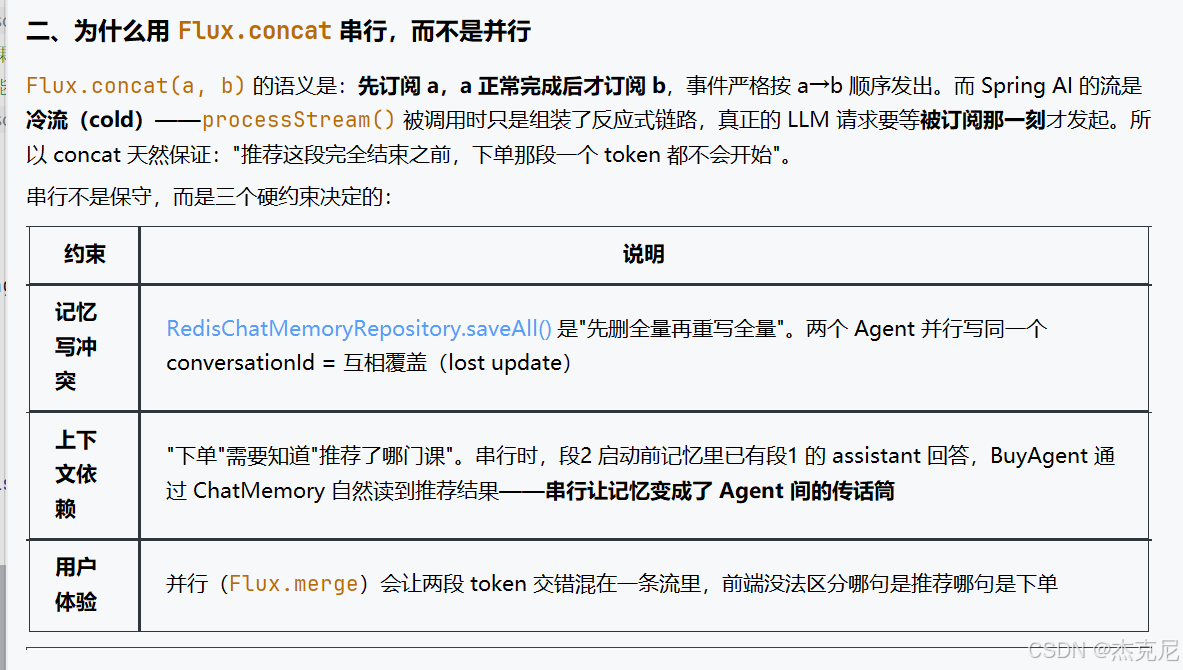
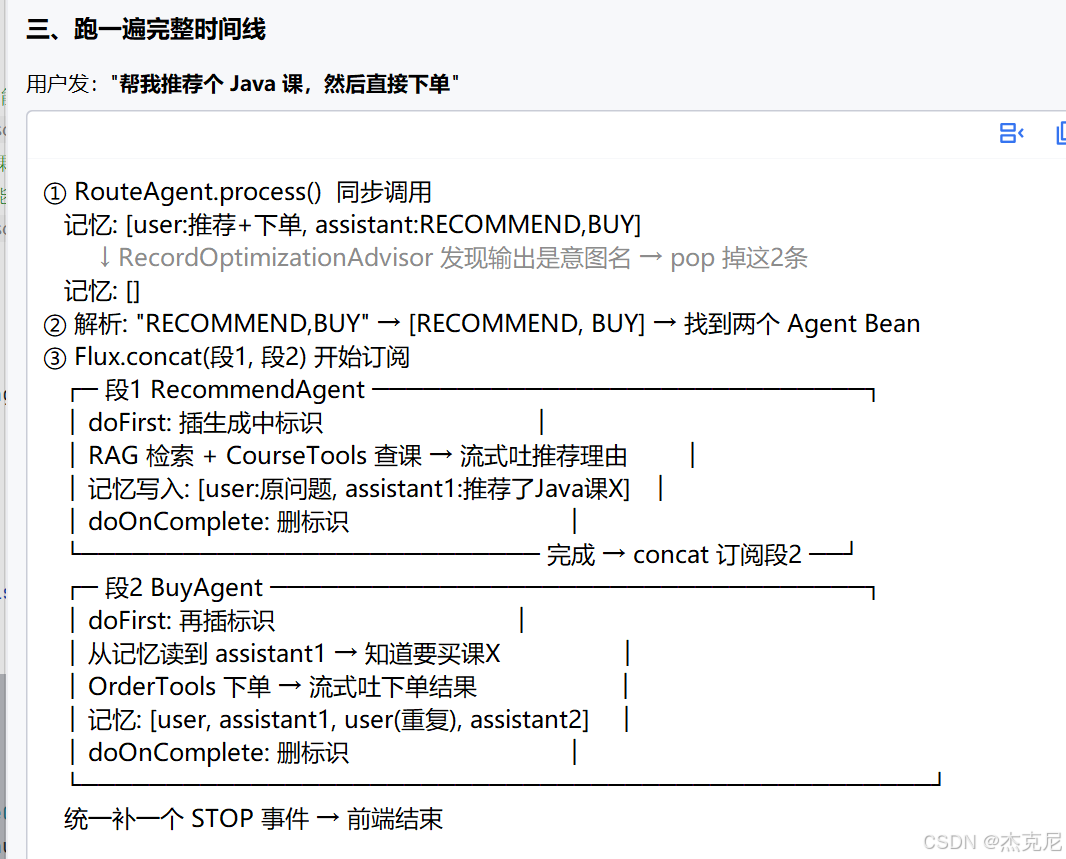
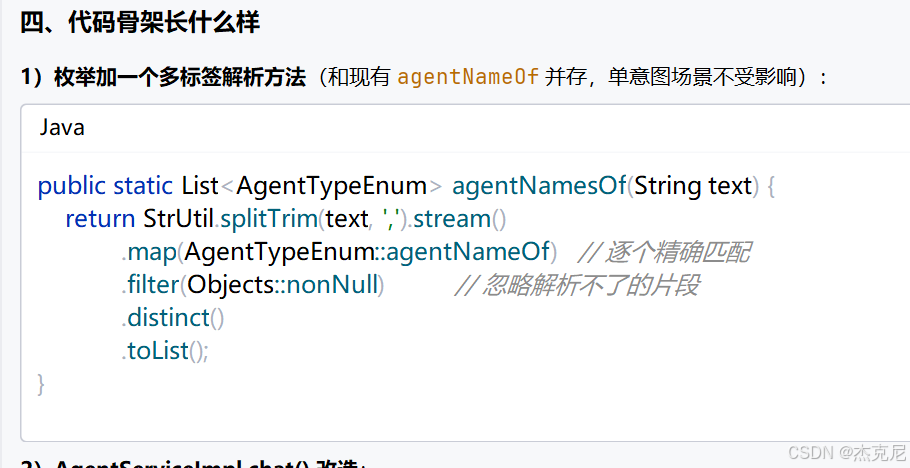
40为什么放在之前就可以?
41assert chatResponse != null;作用?
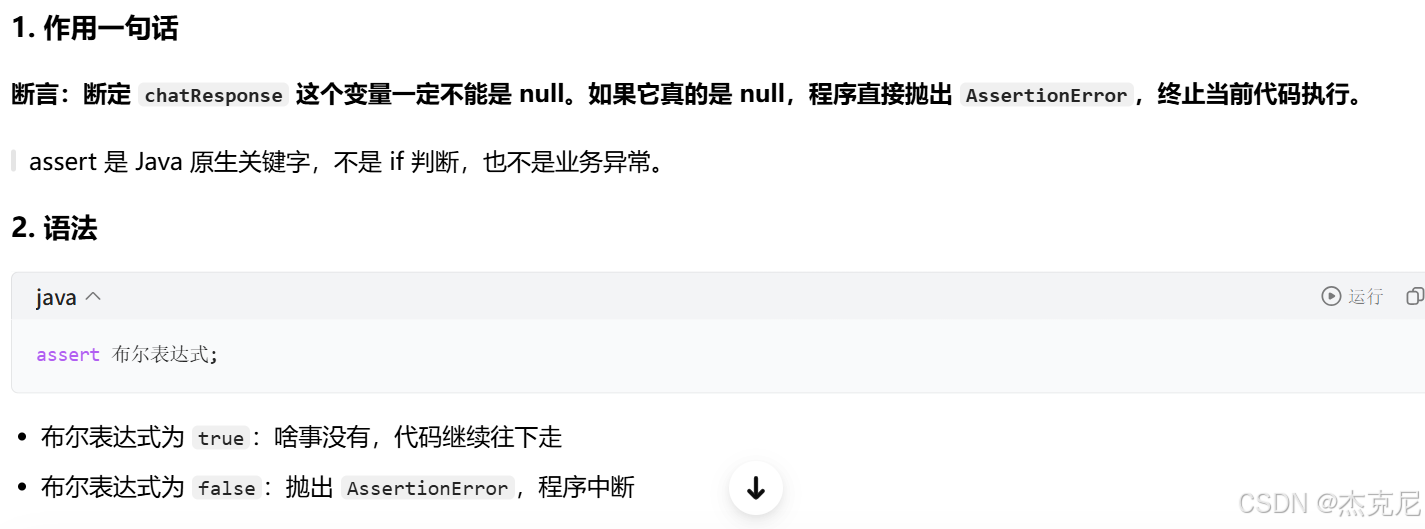
42下面代码的作用?
package com.tianji.aigc.advisor;

import cn.hutool.core.map.MapUtil;
import com.tianji.aigc.enums.AgentTypeEnum;
import com.tianji.aigc.memory.MyChatMemoryRepository;
import org.springframework.ai.chat.client.ChatClientRequest;
import org.springframework.ai.chat.client.ChatClientResponse;
import org.springframework.ai.chat.client.advisor.api.Advisor;
import org.springframework.ai.chat.client.advisor.api.AdvisorChain;
import org.springframework.ai.chat.client.advisor.api.BaseAdvisor;
import org.springframework.ai.chat.memory.ChatMemory;

/**
 * 记录优化
 */
public class RecordOptimizationAdvisor implements BaseAdvisor {

    private final MyChatMemoryRepository myChatMemoryRepository;

    public RecordOptimizationAdvisor(MyChatMemoryRepository myChatMemoryRepository) {
        this.myChatMemoryRepository = myChatMemoryRepository;
    }

    @Override
    public ChatClientRequest before(ChatClientRequest chatClientRequest, AdvisorChain advisorChain) {
        return chatClientRequest;
    }

    @Override
    public ChatClientResponse after(ChatClientResponse chatClientResponse, AdvisorChain advisorChain) {
        // 获取大模型的响应内容
        var chatResponse = chatClientResponse.chatResponse();
        // 获取大模型的响应内容,判断内容是否是智能体的名称,如果是,优化记录,否则无需优化
        assert chatResponse != null;
        var text = chatResponse.getResult().getOutput().getText();
        var agentType = AgentTypeEnum.agentNameOf(text);
        if (null != agentType) {
            // 需要优化记录
            var conversationId = MapUtil.getStr(chatClientResponse.context(), ChatMemory.CONVERSATION_ID);
            this.myChatMemoryRepository.optimization(conversationId);
        }

        return chatClientResponse;
    }

    @Override
    public int getOrder() {
        return Advisor.DEFAULT_CHAT_MEMORY_PRECEDENCE_ORDER - 100;
    }
}
这个类是路由工作流里的"记忆清洁工":它唯一的工作,就是把路由那轮产生的"垃圾消息"从对话记忆里删掉。下面拆开讲。
一、它要解决的问题:路由产物会污染记忆
ROUTE 模式下,每个用户问题都会先被 RouteAgent 处理一遍。注意 RouteAgent 用的也是 chatClient,而 chatClient 的默认 Advisor 链里有 MessageChatMemoryAdvisor——所以路由那轮问答也会被写进对话记忆:
Redis 记忆(conversationId=X):
[0] user: 帮我推荐个课
[1] assistant: RECOMMEND ← 路由中间产物,不是给人看的回答
紧接着 RecommendAgent 拿着同一个 conversationId 再次调用,记忆 Advisor 会把历史注入提示词。如果不清理,会有三个害处:
污染子智能体上下文:RecommendAgent 看到历史里有一条 assistant: RECOMMEND,这句"暗号"会干扰模型理解对话;
污染下一轮路由:第二轮路由时,RouteAgent 自己的历史里也躺着上轮的 RECOMMEND,可能误导分类;
浪费 token:每轮都积累两条无意义消息。
二、它的工作方式:识别"这轮是路由" → 删掉刚写的两条
看 after() 的三步:
拿到大模型本次的输出文本 text;
AgentTypeEnum.agentNameOf(text) 判断:输出恰好是一个智能体名(如 RECOMMEND)→ 说明本次调用是路由调用;普通回答(自然语言)匹配不上,返回 null,什么都不做;
是路由 → 从 Advisor 上下文里取出 conversationId,调 myChatMemoryRepository.optimization(conversationId),即 Redis 列表 rightPop(2)——把刚写进去的那两条(user 问题 + assistant 路由名)从尾部弹掉。
清理后记忆恢复干净,子智能体那轮写入的才是第一条有效消息。
三、关键细节:getOrder 决定了"删的时机对不对"return Advisor.DEFAULT_CHAT_MEMORY_PRECEDENCE_ORDER - 100;这行是整个类最绕的地方。Advisor 链像嵌套拦截器:order 越小越靠外层,before() 越先执行、after() 越后执行。本类把 order 设成比记忆 Advisor 小 100 → 它是外层 → 它的 after() 在记忆 Advisor 的 after()(写库)之后才跑。执行时序:
optimization.before()   空操作
  memory.before()       把历史注入请求
    → LLM 调用,输出 "RECOMMEND"
  memory.after()        把 [user问题, assistant:RECOMMEND] 写入 Redis   ← 先写
optimization.after()    发现输出是智能体名 → rightPop(2)              ← 后删,删的正是刚写的两条
如果 order 反过来(比记忆 Advisor 大),它的 after 会先于写库执行,pop 掉的就是上一轮的真实对话——直接删错数据。所以"-100"不是随便写的,是在抢"最后执行 after"的位置。
四、为什么依赖 MyChatMemoryRepository 而不是 ChatMemoryRepository
Spring AI 原生的 ChatMemoryRepository 接口只有增删查全量,没有"删除最后 N 条"这种操作。项目自定义了 MyChatMemoryRepository 接口扩展出 optimization() 方法,由 RedisChatMemoryRepository 实现。这也正好呼应你之前问的那个 IDEA 装配报错:SpringAIConfig 第136行 注入 MyChatMemoryRepository 就是给这个 Advisor 用的——只有自定义接口才有 pop 能力。
五、触发边界:它只对"路由调用"生效
子智能体(Recommend/Buy)的回答是自然语言 → agentNameOf 返回 null → 不删;
ENHANCE 模式(ChatServiceImpl)虽然也挂了这张 Advisor,但那里没有路由调用,输出永远不是纯智能体名 → 恒为空操作,无副作用;
它假设"路由问答恰好是记忆最后两条"——这个假设成立,因为 pop 紧跟在写库之后同步执行,中间没有别的写入。
六、两个小瑕疵(知道即可)
optimization() 的注释 写"弹出1个元素",实际 rightPop(2) 弹的是 2 个(注释过时);
就是上一轮讨论的:若将来路由输出多标签 "RECOMMEND,BUY",这里的 agentNameOf 精确匹配会失败 → 清理逻辑失效,需要换成 agentNamesOf 列表判断。
一句话总结:RecordOptimizationAdvisor = 挂在 Advisor 链最外层的"事后清洁工",靠"模型输出是否为智能体名"识别路由调用,并在记忆 Advisor 写完库之后,把路由那两条中间消息从 Redis 记忆里 pop 掉,保证子智能体和后续轮次看到的都是干净的真实对话。
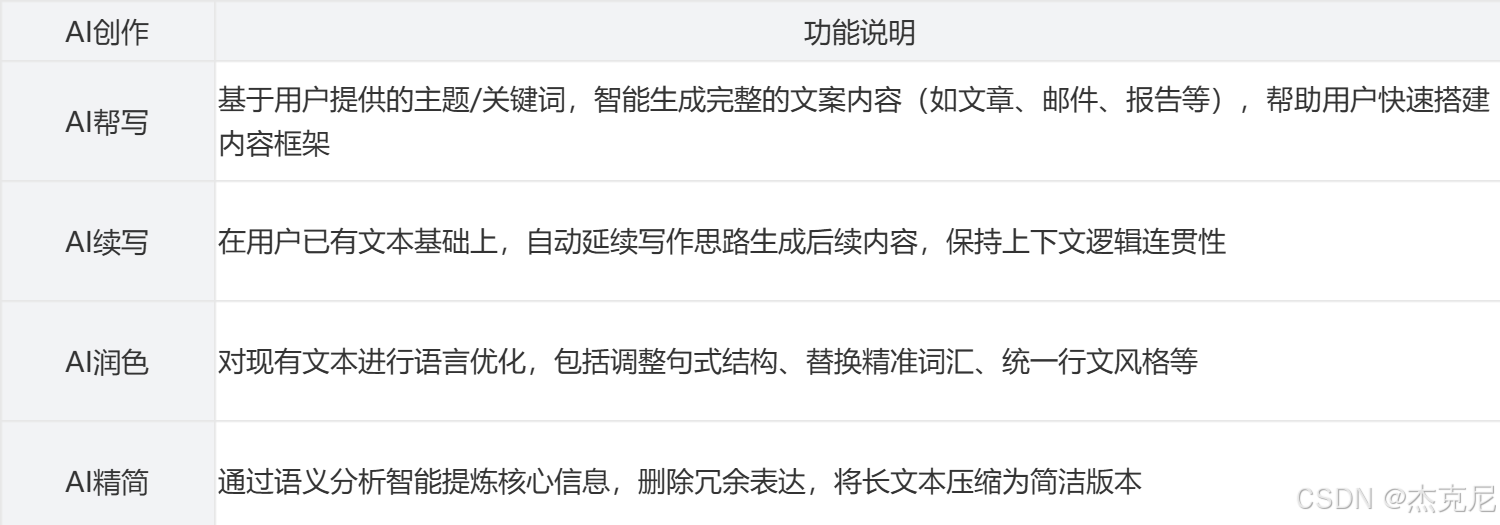
43AI创作回复功能
44bug重现
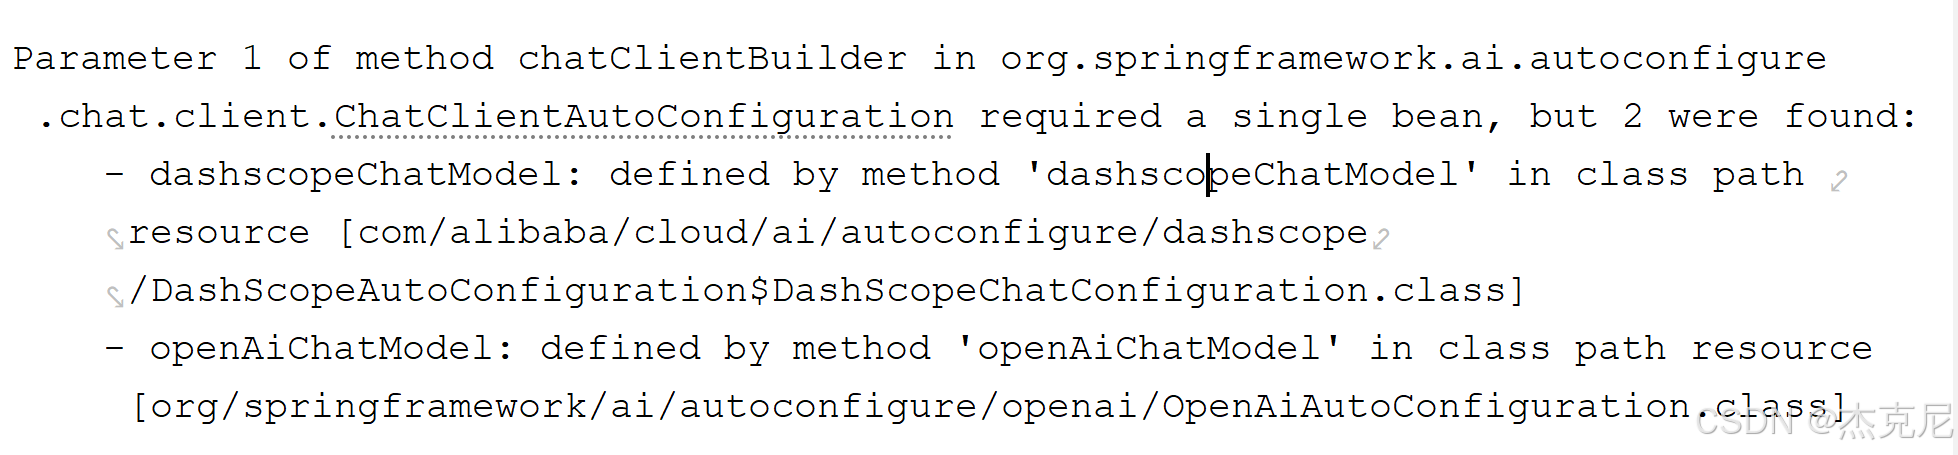
重启aigc服务,但是,会发现报错:
这是因为,在
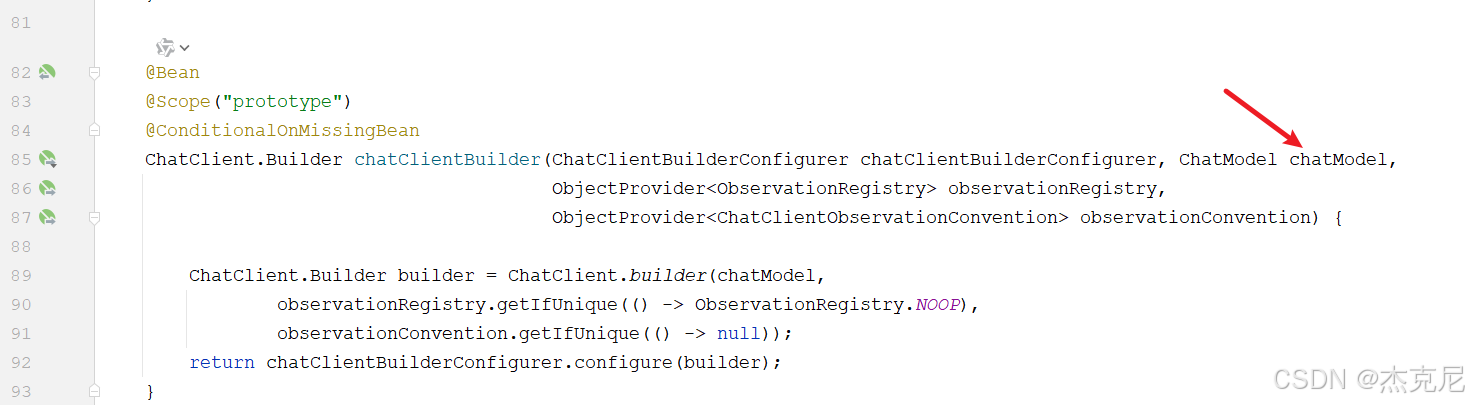
SpringAI启动时,会需要注入ChatModel对象,但是,现在由于引入了阿里云和OpenAI,会存在2个ChatModel对象实例,所以导致了报错。SpringAI就是由
org.springframework.ai.autoconfigure.chat.client.ChatClientAutoConfiguration类完成自动配置的。可以看到,在这个类中的
chatClientBuilder方法,中注入了ChatModel对象,由于现在的Spring容器中存在2个实例,所以就报错了。
怎么解决这个问题呢?
解决方法:在
SpringAIConfig中不通过ChatClient.Builder构建ChatClient对象,而是通过注入ChatModel的方式,来创建不同的ChatClient对象。2.3.4. 解决问题
在
SpringAIConfig中改造代码:@Bean public ChatClient chatClient(@Qualifier("dashscopeChatModel") ChatModel dashScopeChatModel, //注意这里@Qualifier的指定的名称,不要写错了 Advisor loggerAdvisor, // 日志记录器 Advisor messageChatMemoryAdvisor, Advisor recordOptimizationAdvisor // 记录优化 // CourseTools courseTools, // 课程工具 // OrderTools orderTools // 预下单工具 ) { return ChatClient.builder(dashScopeChatModel) .defaultAdvisors(loggerAdvisor, messageChatMemoryAdvisor, recordOptimizationAdvisor) //添加 Advisor 功能增强 // .defaultTools(courseTools, orderTools) .build(); } @Bean public ChatClient openAiChatClient(@Qualifier("openAiChatModel") ChatModel openAiChatModel, Advisor loggerAdvisor // 日志记录器 ) { return ChatClient.builder(openAiChatModel) .defaultAdvisors(loggerAdvisor) .build(); }
45AI自动回复功能怎么实现的?
在提交问题模块,当用户提交完问题后,就调用AI大模型(远程调用嘛,先将AI的方法写到API模块中(注册信息)),然后将答案更新数据库封装成DTO返回即可
46AI续写、AI扩写功能怎么实现?
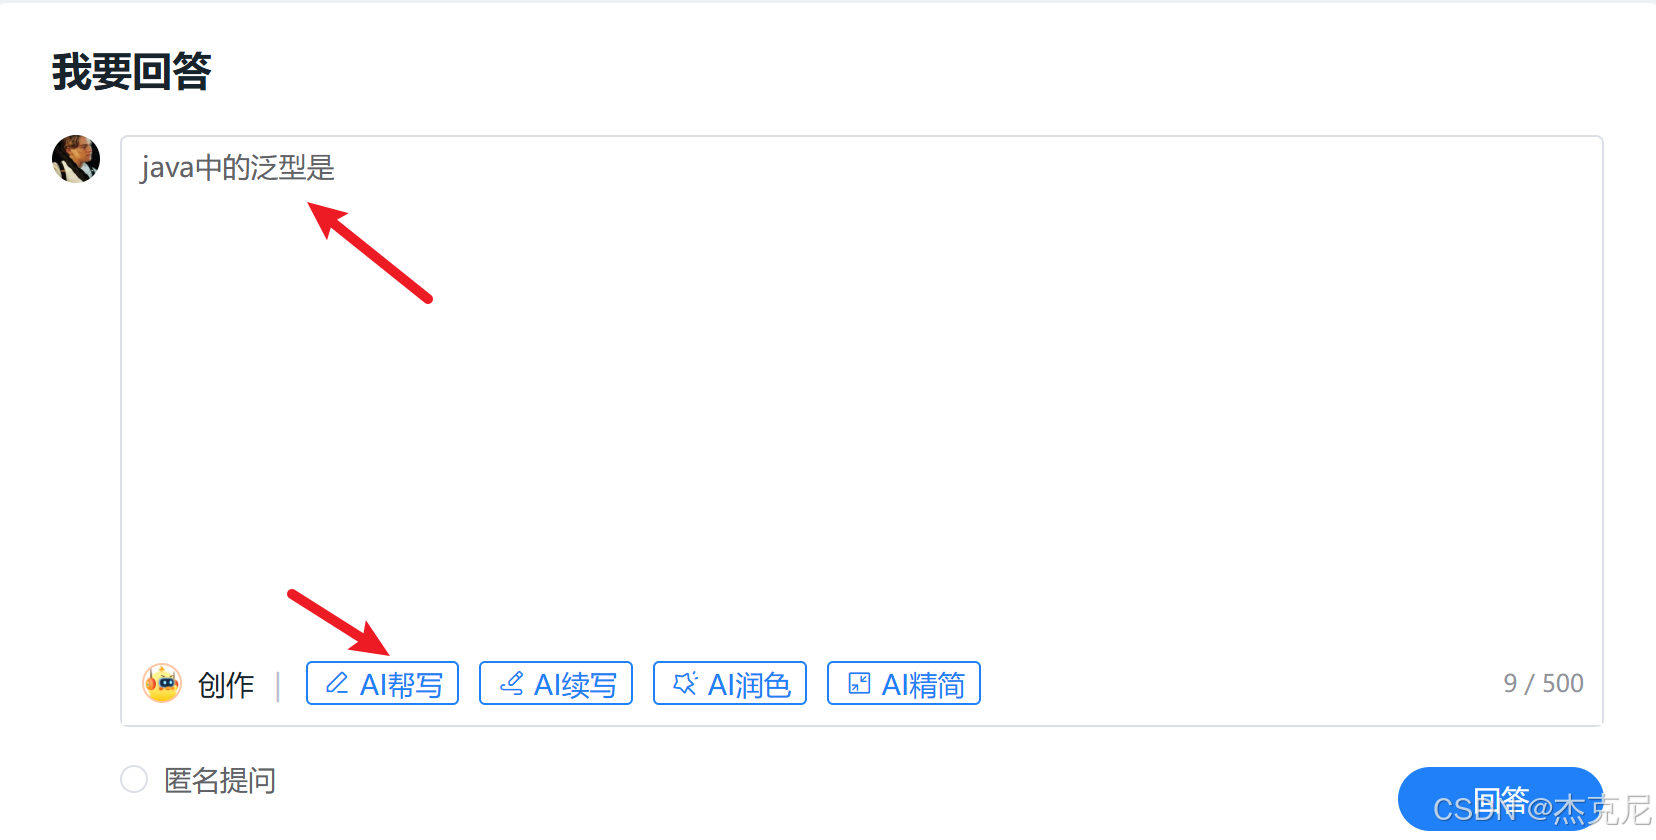
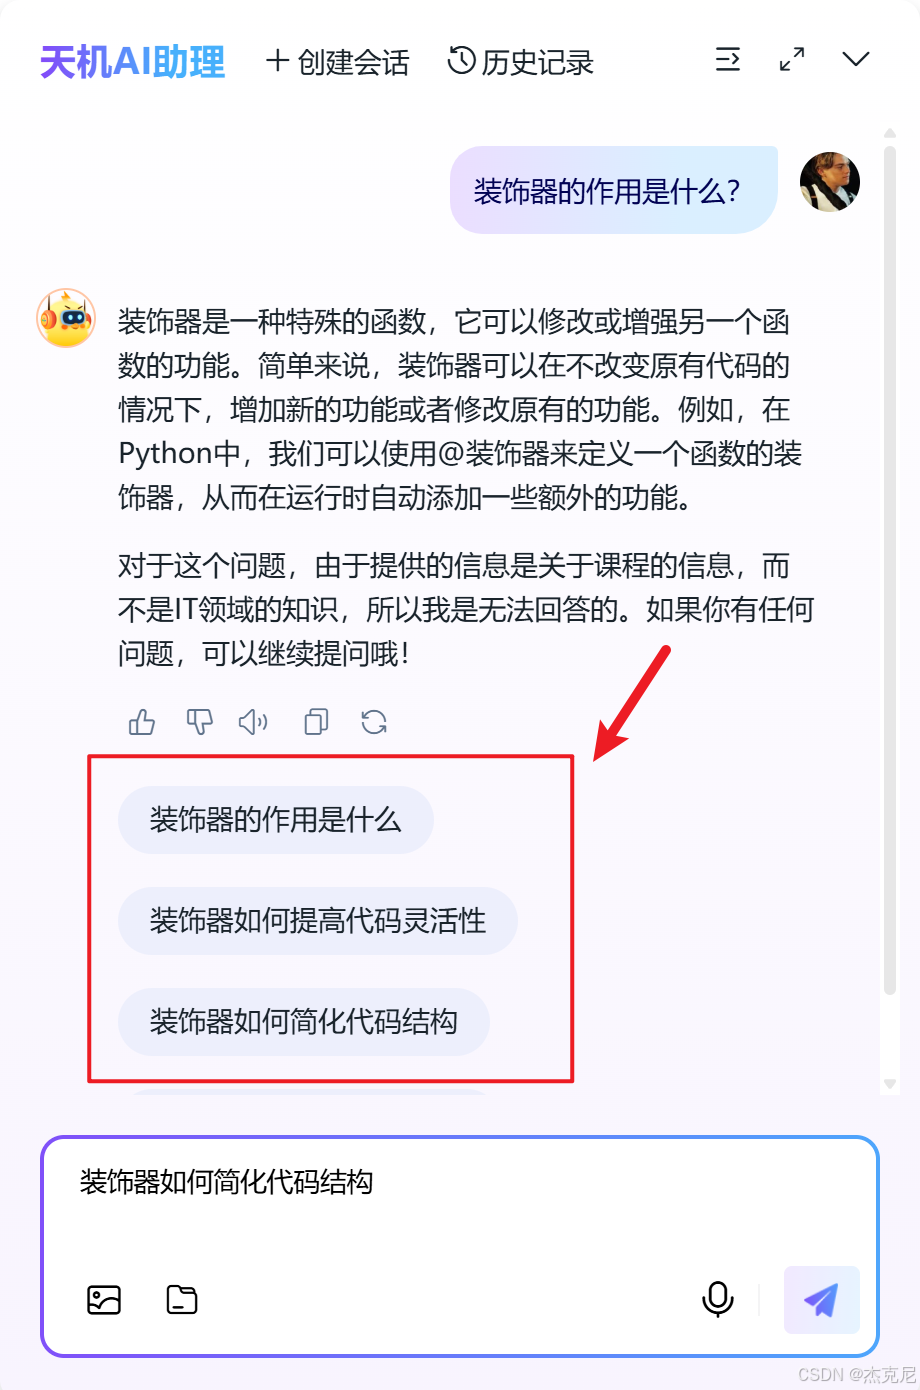
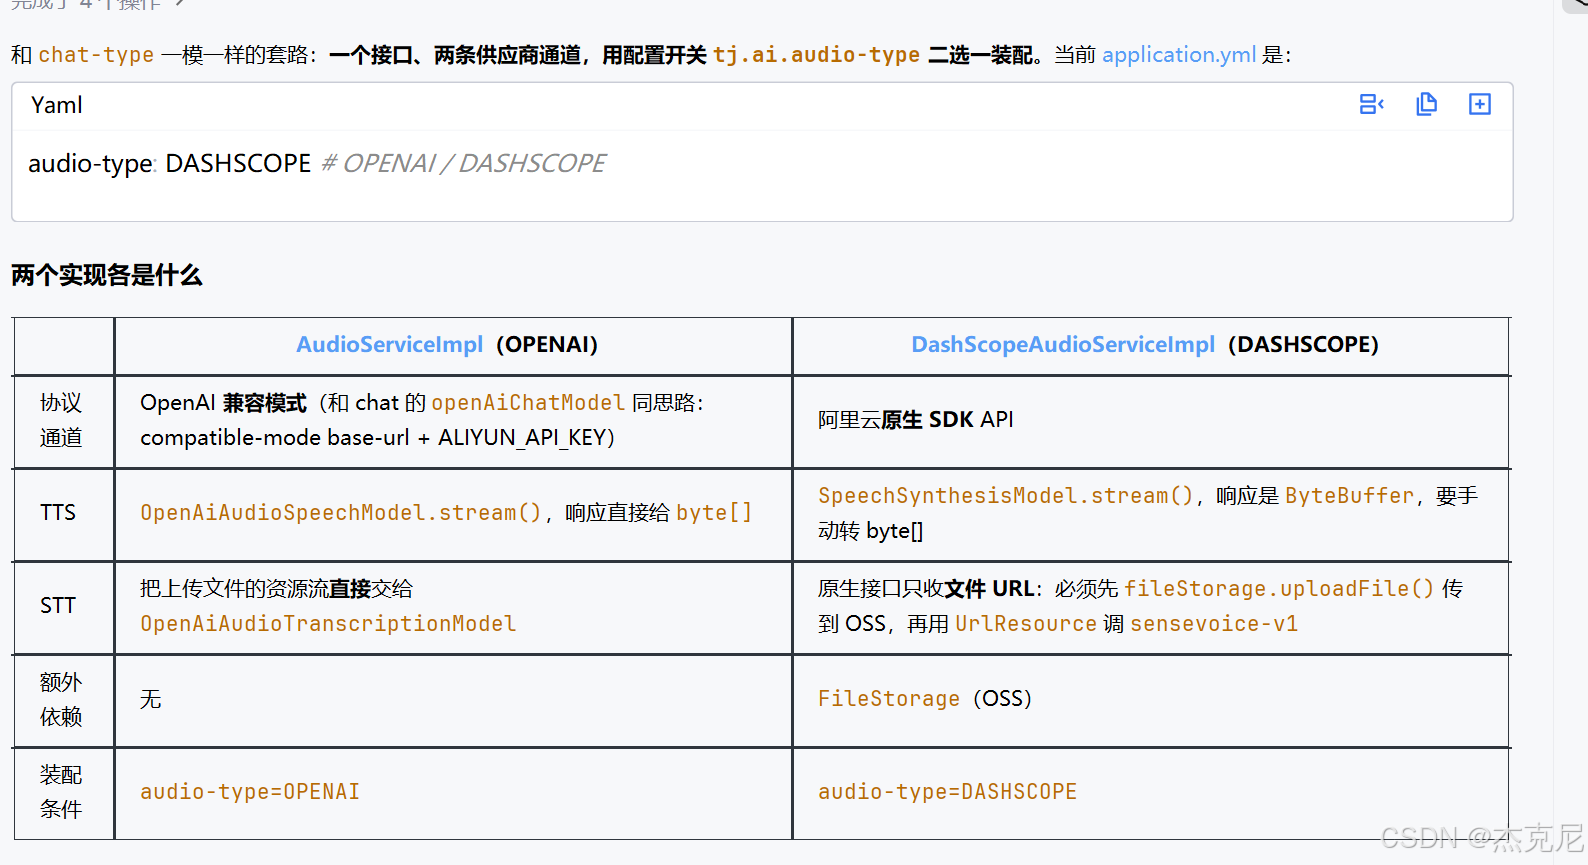
47为什么下面的功能需要两套实现类?
package com.tianji.aigc.service;

import org.springframework.web.multipart.MultipartFile;
import org.springframework.web.servlet.mvc.method.annotation.ResponseBodyEmitter;

/**
 * 文本与语音的互转服务
 */
public interface AudioService {

    /**
     * 文本转语音
     *
     * @param text 文本
     * @return 语音流
     */
    ResponseBodyEmitter ttsStream(String text);

    /**
     * 语音转文本
     *
     * @param multipartFile 语音文件
     * @return 文本内容
     */
    String stt(MultipartFile multipartFile);

}
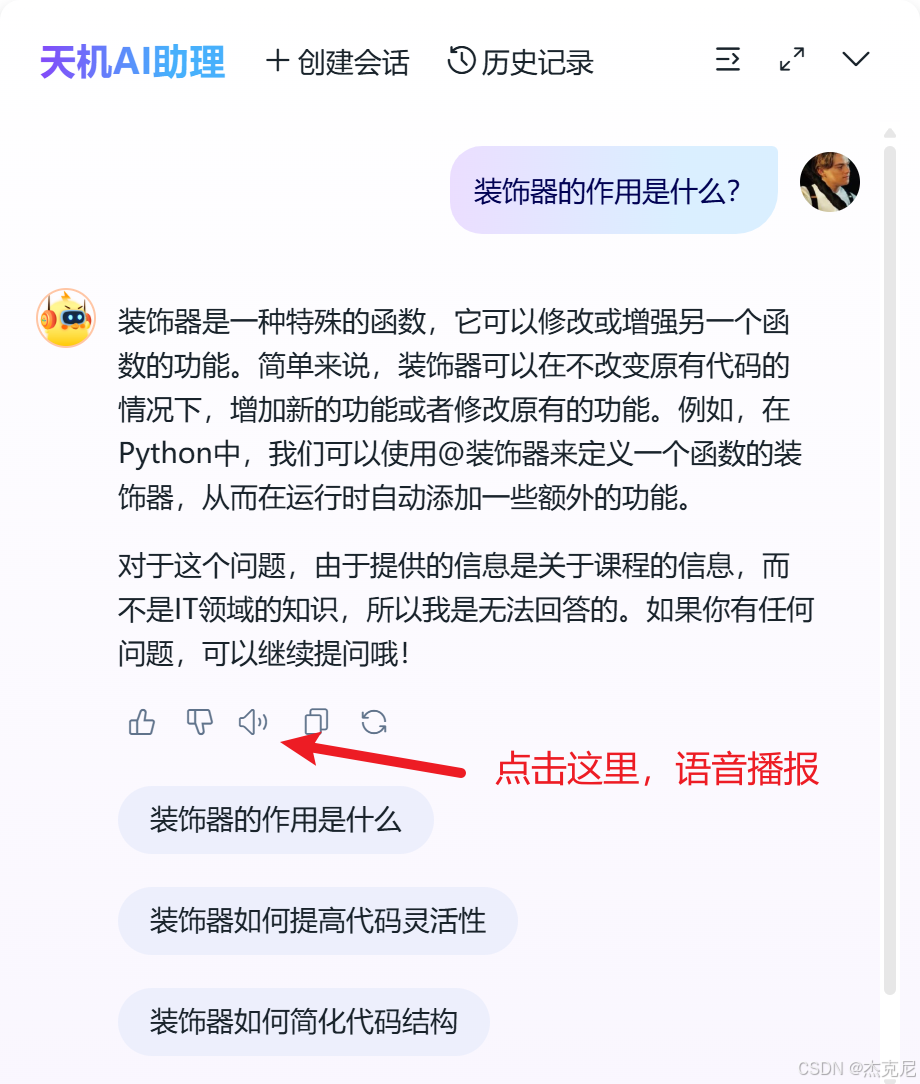
48文字转语音功能怎么实现?
    @Override
    public ResponseBodyEmitter ttsStream(String text) {
        var prompt = new SpeechSynthesisPrompt(text);
        var response = this.speechSynthesisModel.stream(prompt);
        ResponseBodyEmitter emitter = new ResponseBodyEmitter();
        // 订阅响应流并发送数据
        response.subscribe(
                speechResponse -> {
                    try {
                        // 获取响应输出的数据,并发送到响应体中
                        ByteBuffer byteBuffer = speechResponse.getResult().getOutput().getAudio();
                        byte[] bytes = new byte[byteBuffer.remaining()];
                        byteBuffer.get(bytes);
                        emitter.send(bytes);
                    } catch (IOException e) {
                        emitter.completeWithError(e);
                    }
                },
                emitter::completeWithError,
                emitter::complete
        );
        return emitter;
    }
49@PostMapping (value = "tts-stream", produces = "audio/mp3") 里面的 produces 属性有什么用?
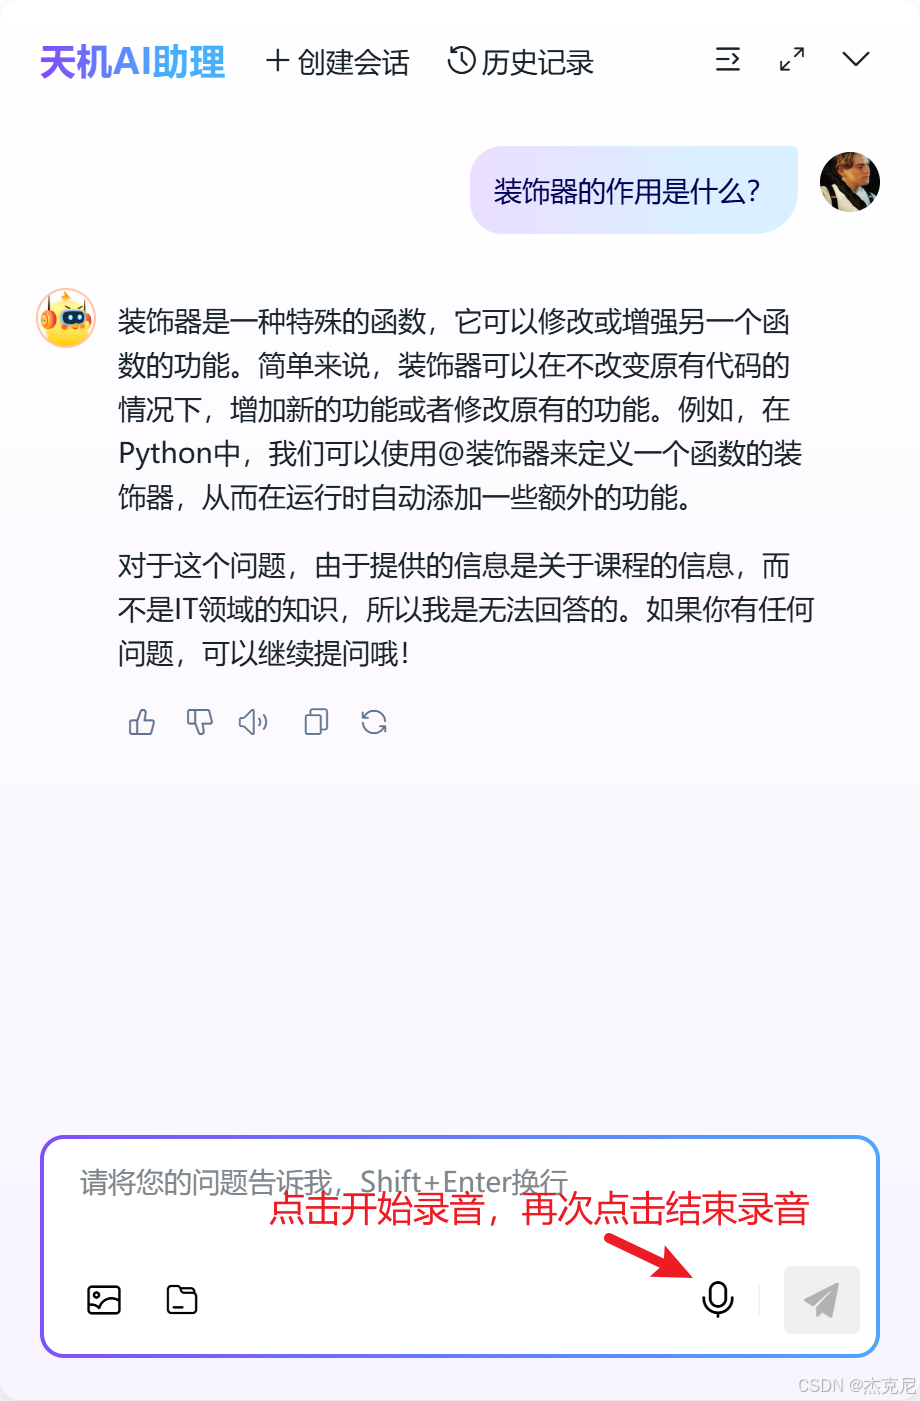
50语音转文字怎么实现?
51bug重现
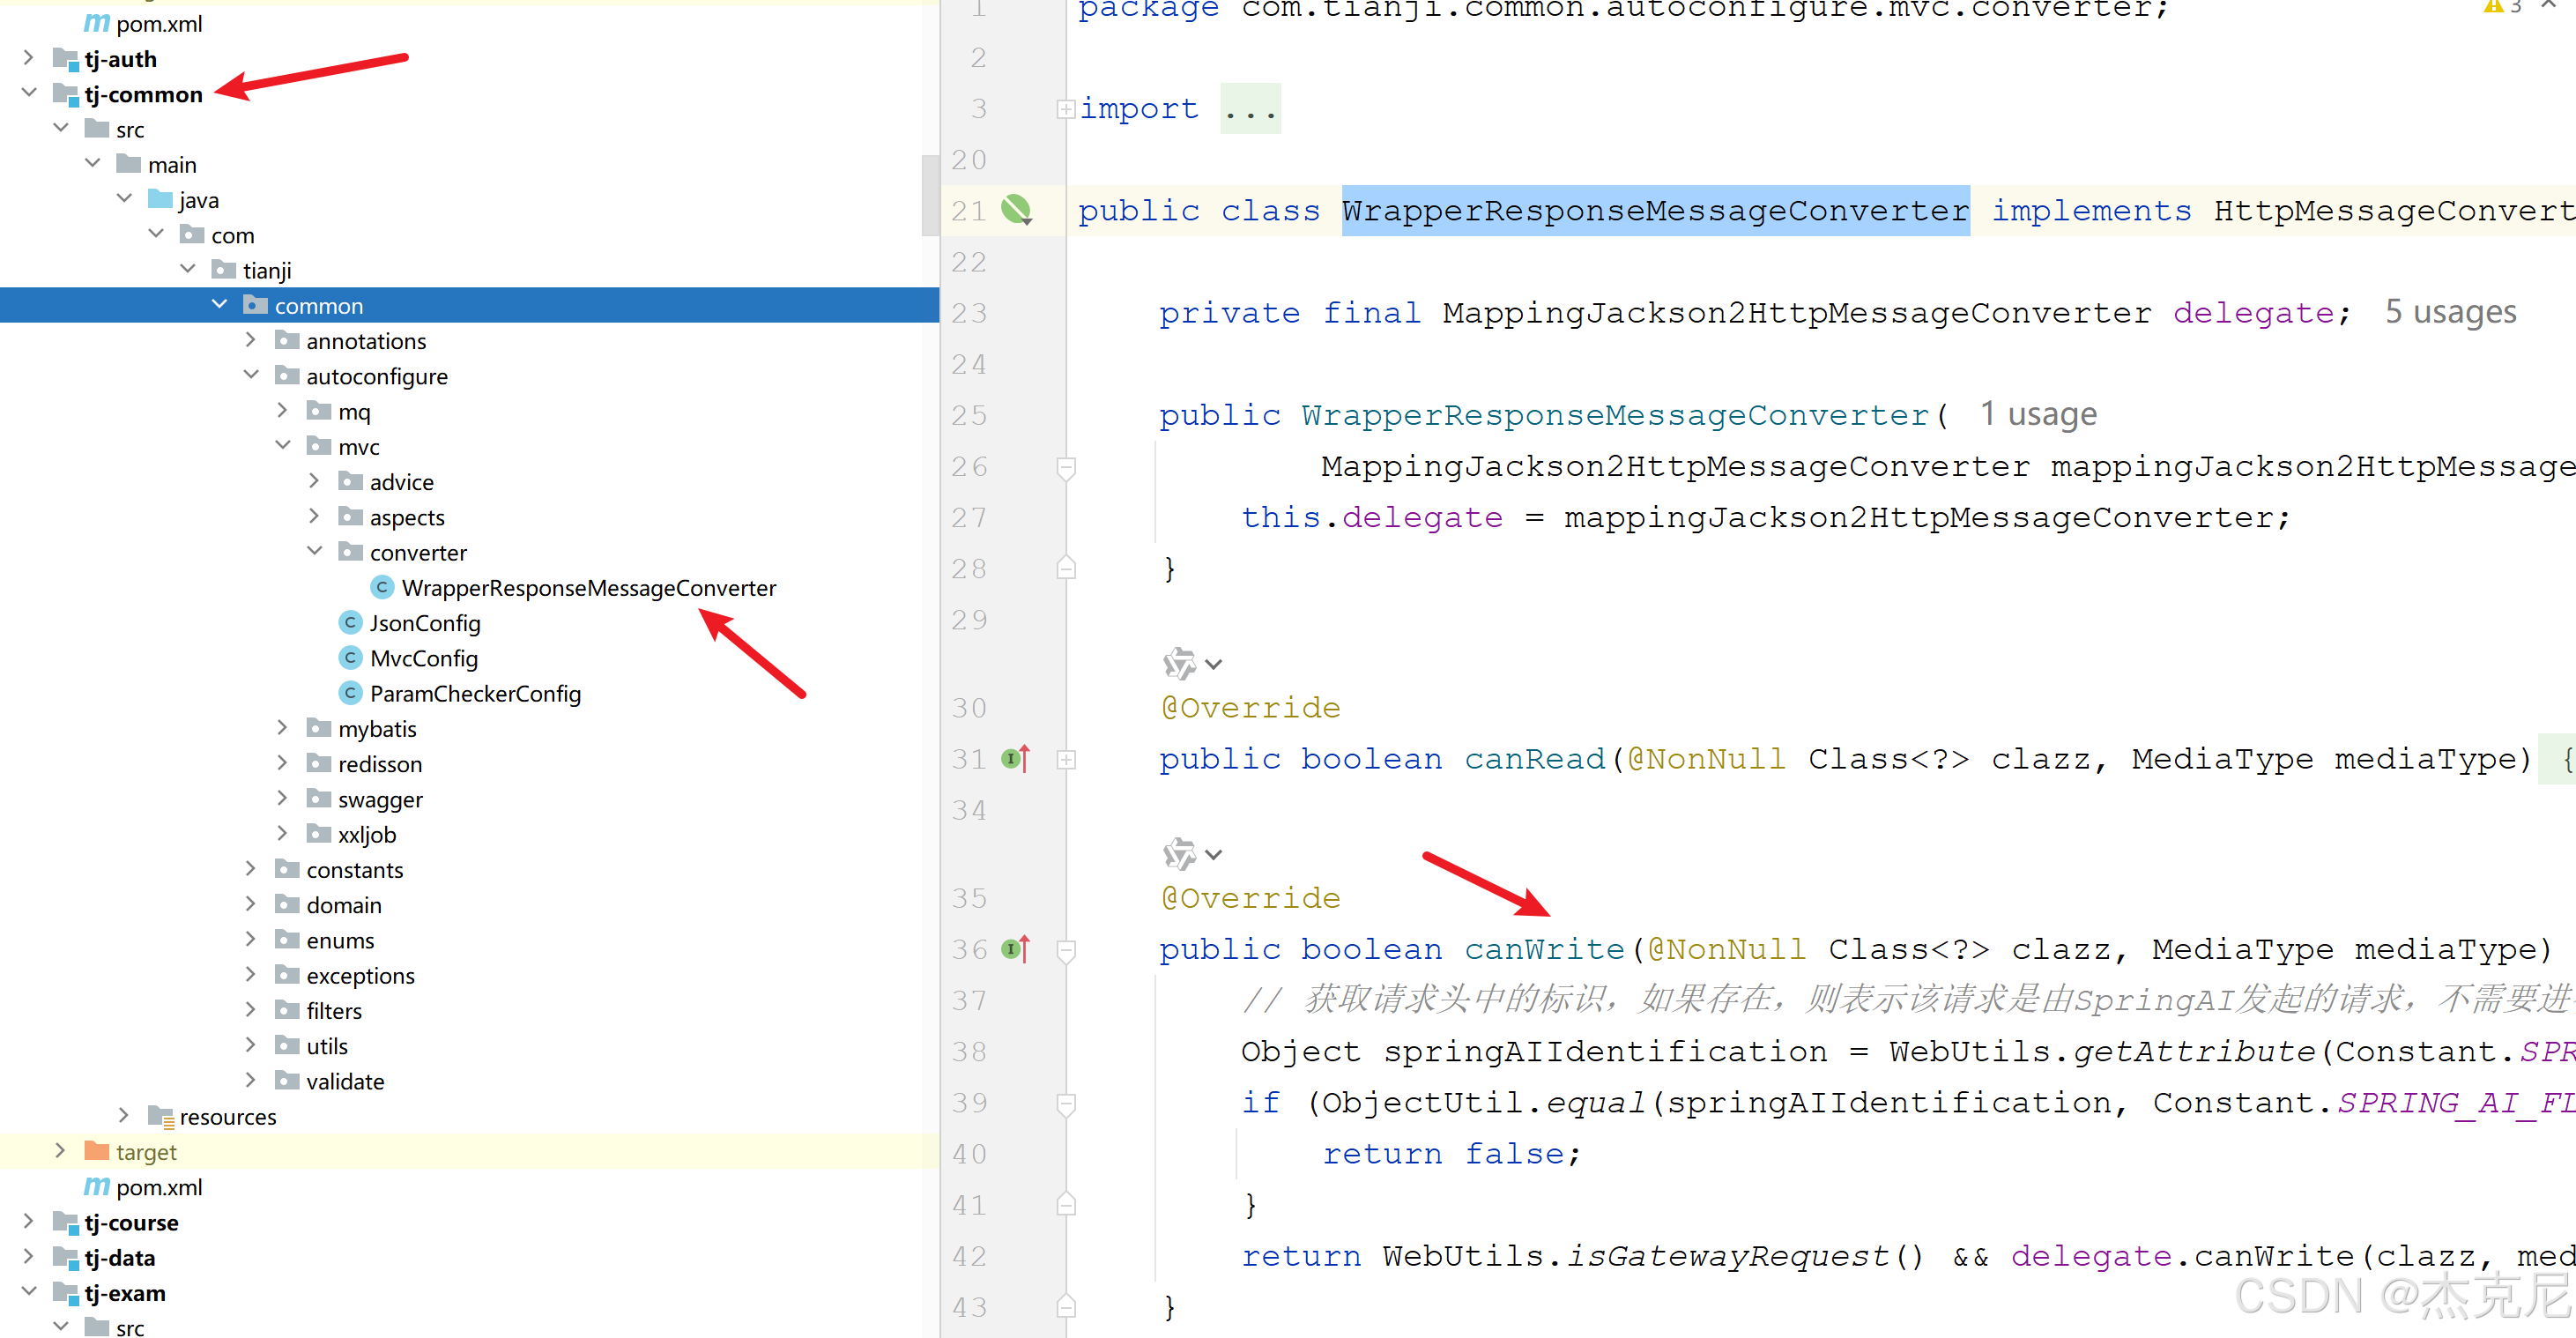
这是因为在原有的代码中,自定义了
WrapperResponseMessageConverter消息转化器,他的作用是对输出的内容进行包装,而SpringAI底层用的发起http请求的组件是RetryTemplate,而RetryTemplate也会用到这个消息转化器,但是这个消息转化器是无法处理文件的,所以报消息转化出错:
3.2.4.6. 解决问题
为了解决上述问题,需要在发起请求时,添加一个标识来表明是SpringAI发起的请求,就不再进行包装处理了。
要想实现这样的效果,需要给
RetryTemplate添加一个监听器,在发起请求前设置标识,请求结束后删除标识,这样就可以解决问题了。具体代码如下:
    /**
     * 创建并配置自定义重试监听器Bean
     * <p>
     * 实现说明:
     * 1. 创建匿名RetryListener实现,在重试操作期间管理Web属性
     * 2. 将监听器注册到提供的RetryTemplate实例
     *
     * @param retryTemplate Spring Retry模板对象,用于注册重试监听器
     * @return RetryListener 已注册到模板的重试监听器实例,将由Spring容器管理
     */
    @Bean
    public RetryListener customizeRetryTemplate(RetryTemplate retryTemplate) {
        // 创建自定义重试监听器,实现以下核心功能:
        // - 重试开始时设置上下文标识
        // - 重试结束后清理上下文标识
        RetryListener retryListener = new RetryListener() {
            @Override
            public <T, E extends Throwable> boolean open(RetryContext context, RetryCallback<T, E> callback) {
                WebUtils.setAttribute(Constant.SPRING_AI_ATTR, Constant.SPRING_AI_FLAG);
                return true;
            }

            @Override
            public <T, E extends Throwable> void close(RetryContext context, RetryCallback<T, E> callback, Throwable throwable) {
                WebUtils.removeAttribute(Constant.SPRING_AI_ATTR);
            }
        };

        // 将监听器注册到重试模板
        retryTemplate.registerListener(retryListener);
        return retryListener;
    }
@Override public boolean canWrite(@NonNull Class<?> clazz, MediaType mediaType) { // 获取请求头中的标识,如果存在,则表示该请求是由SpringAI发起的请求,不需要进行包装处理 Object springAIIdentification = WebUtils.getAttribute(Constant.SPRING_AI_ATTR); if (ObjectUtil.equal(springAIIdentification, Constant.SPRING_AI_FLAG)) { return false; } return WebUtils.isGatewayRequest() && delegate.canWrite(clazz, mediaType); }
52ResponseBodyEmitter 这个是什么类型?
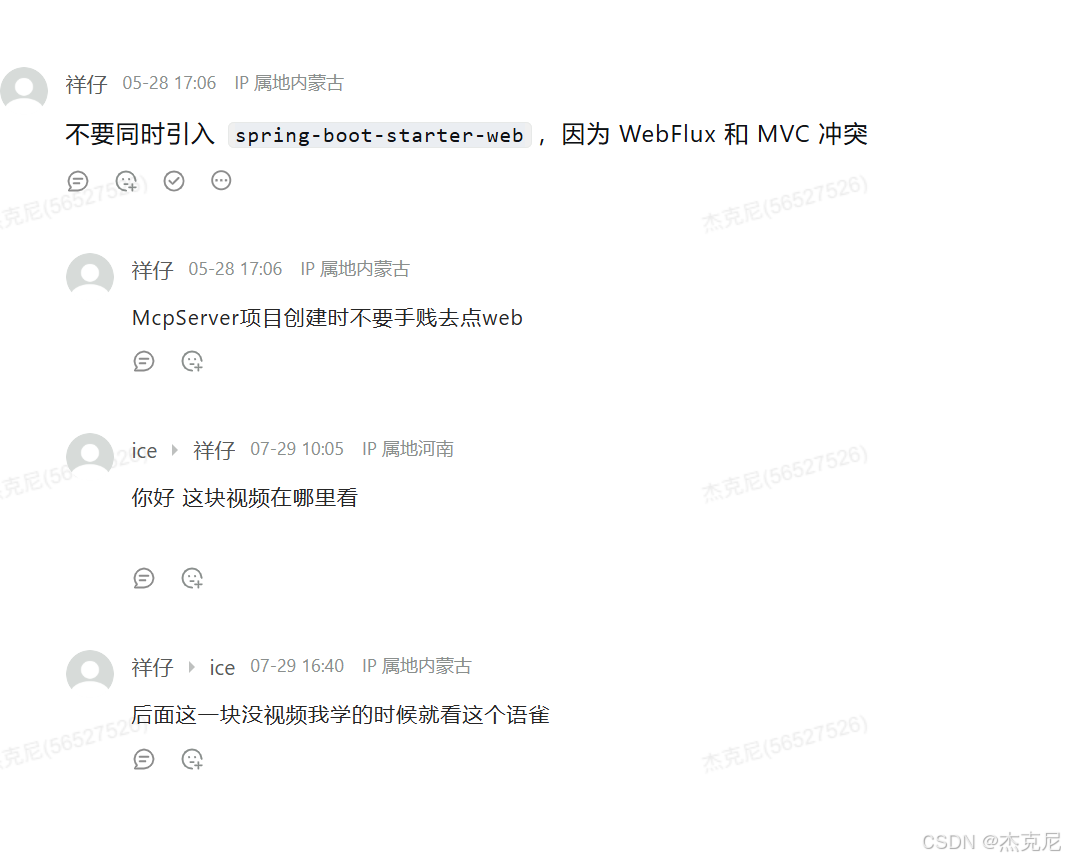
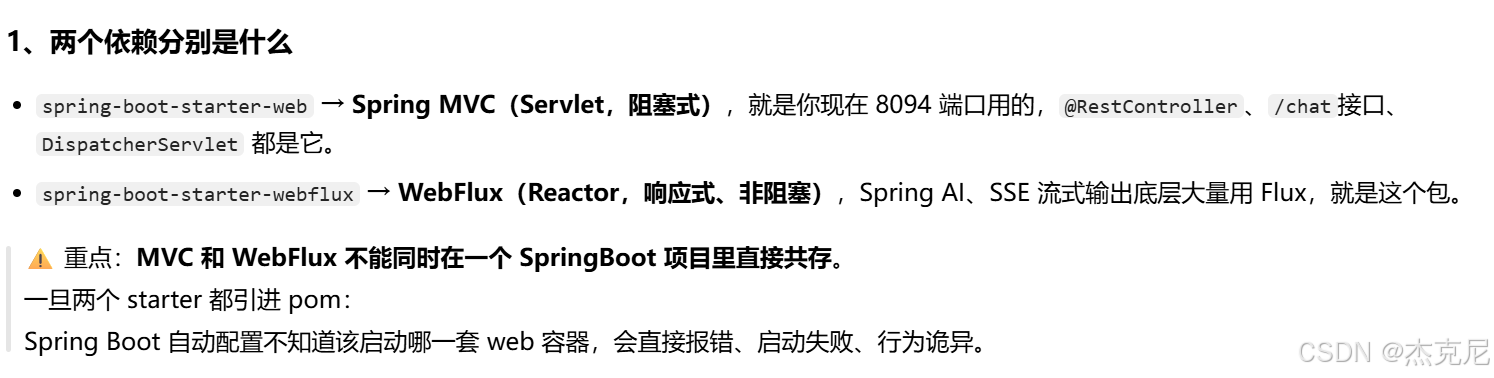
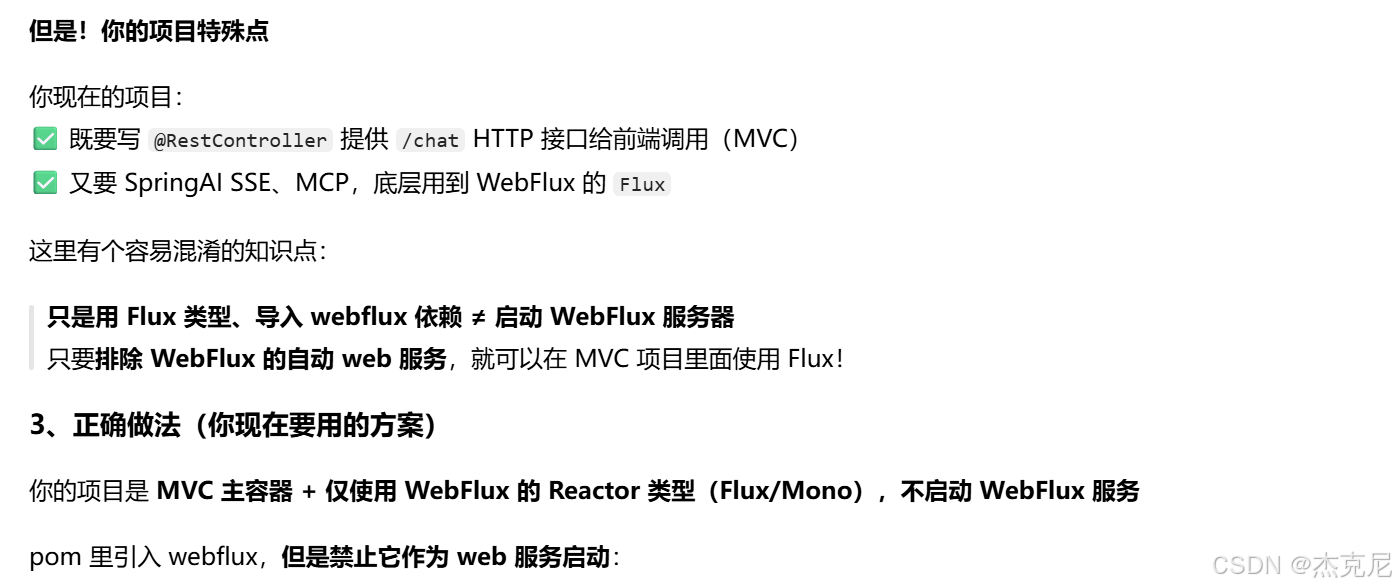
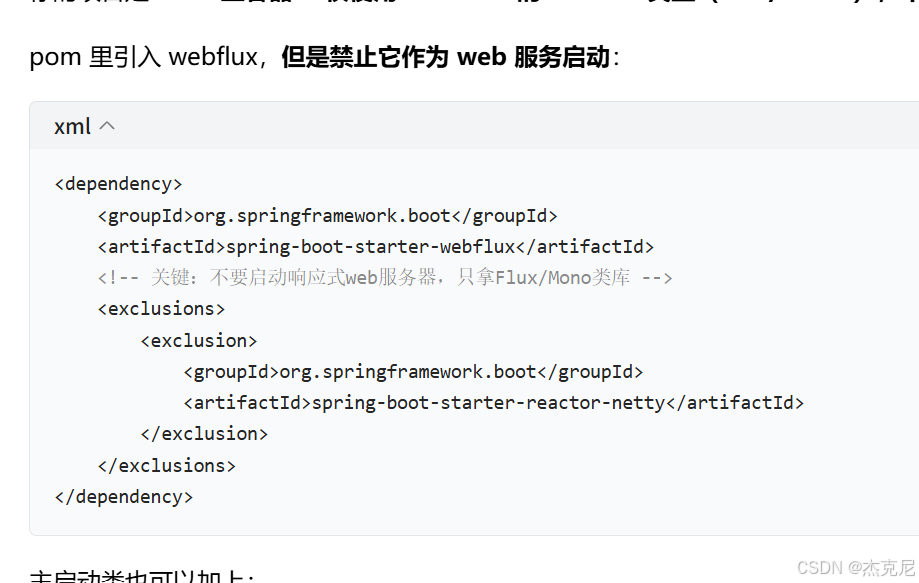
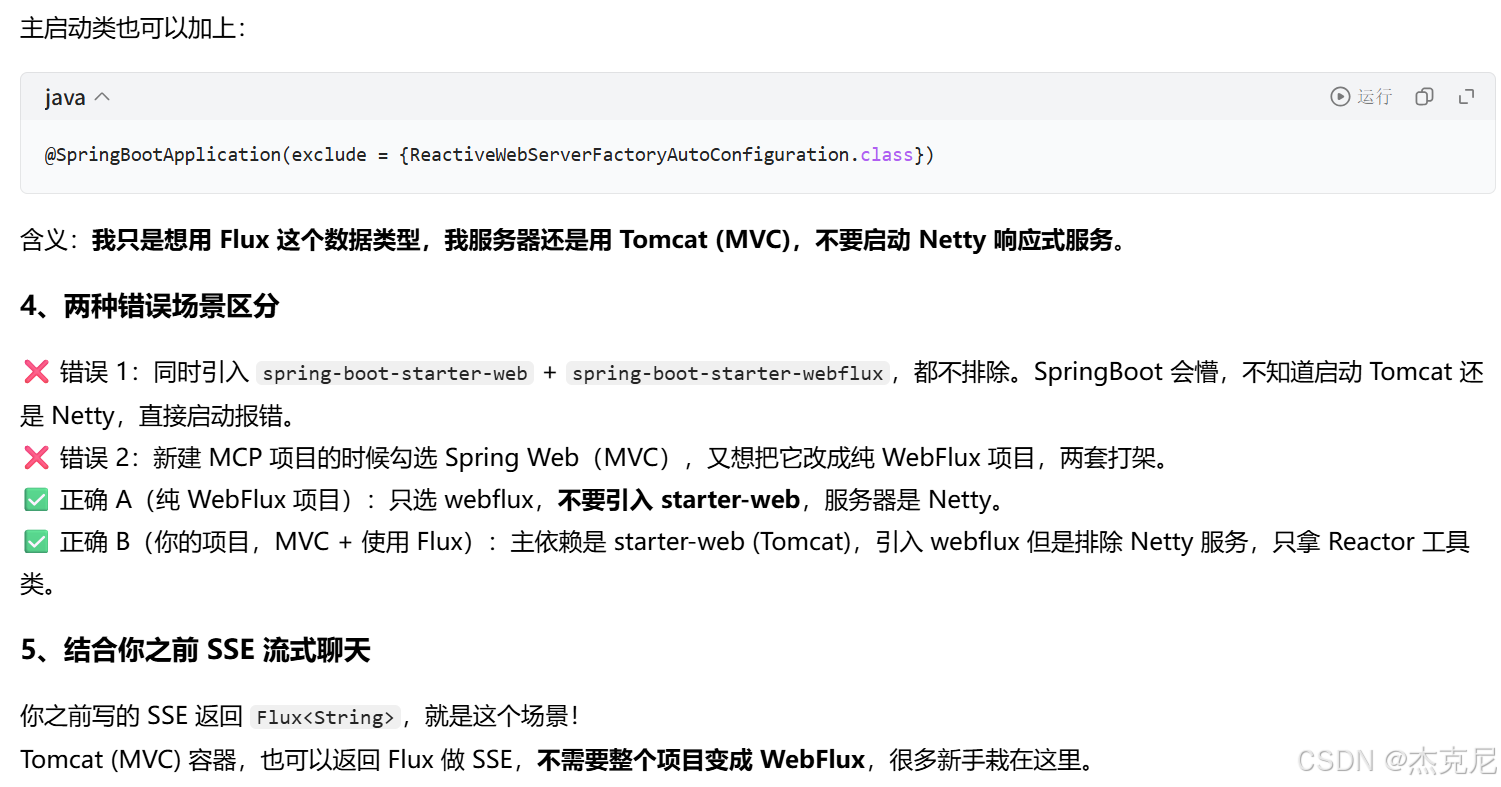
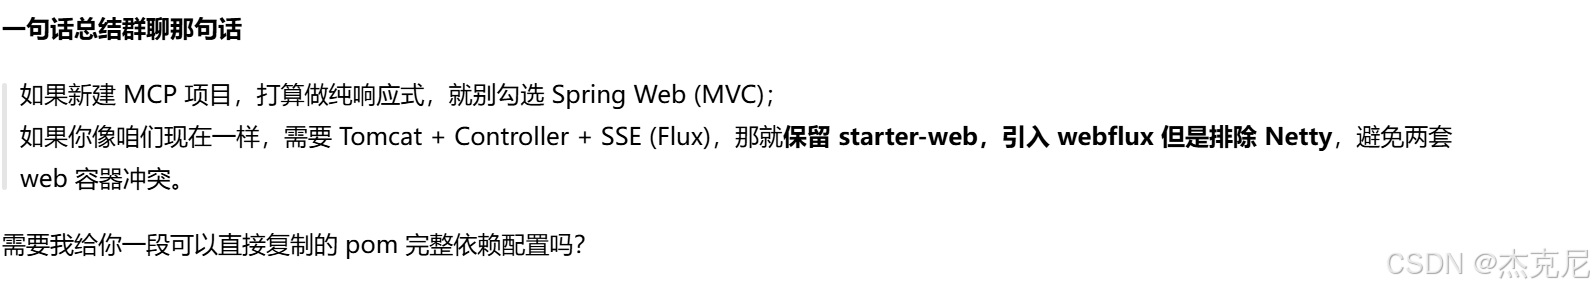
53为什么不能同时引入下面依赖?
54总结
本文系统阐述了天机AI助手的核心功能实现:通过@NoWrapper注解控制响应包装,结合WrapperResponseBodyAdvice拦截器实现灵活数据封装;基于Flux流式输出与concatWith标记结束,配合takeWhile实现动态停止生成;利用Nacos热更新系统提示词,提升可维护性;通过AtomicReference和ConcurrentHashMap保障线程安全;借助Redis实现会话记忆与中断状态持久化,并解决“停止生成”与“记忆保存”冲突问题;采用自定义Advisor链(如RecordOptimizationAdvisor)清理路由中间产物,确保上下文纯净;支持MySQL/MongoDB/Redis多模式会话存储,通过配置切换;最终构建了支持智能体路由、多轮对话、RAG检索、语音互转等能力的完整AI系统架构。

智能硬件社区聚焦AI智能硬件技术生态,汇聚嵌入式AI、物联网硬件开发者,打造交流分享平台,同步全国赛事资讯、开展 OPC 核心人才招募,助力技术落地与开发者成长。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)