Python后端爬虫专题17:让Spider交付一份能被后端读取的数据——完成JobSpider与JSONL输出
Python后端爬虫专题17:让Spider交付一份能被后端读取的数据——完成JobSpider与JSONL输出
上一篇练习完整答案
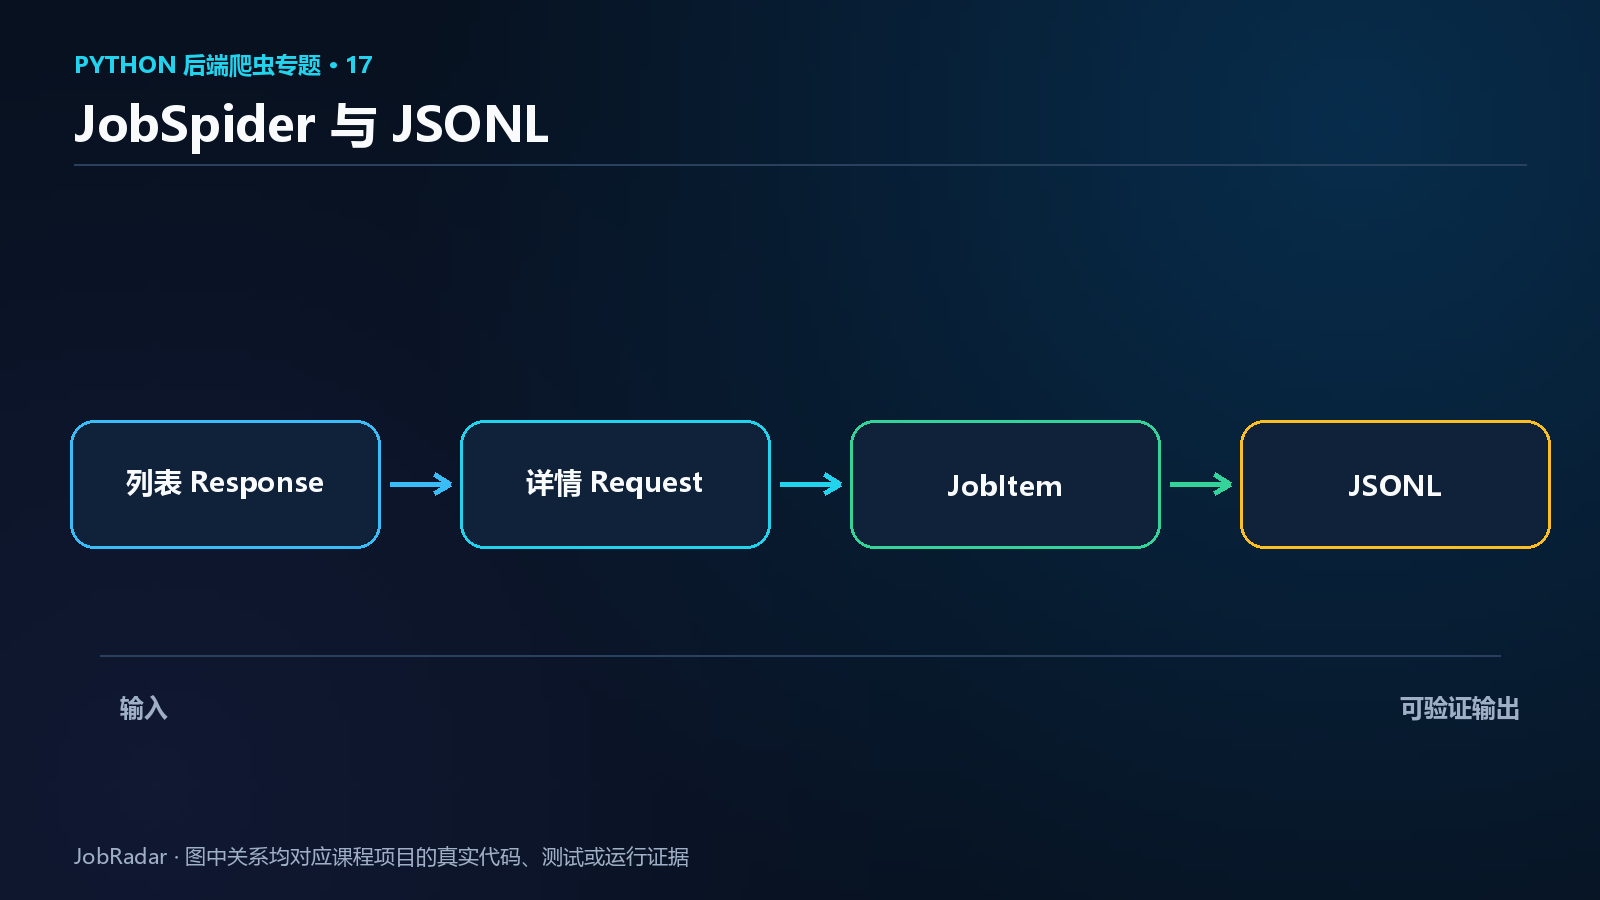
完整数据流是:start_urls 被转换为 Request,Engine 交给 Scheduler;Scheduler 去重和排队;Engine 取出后经下载中间件送到 Downloader;Response 逆向回 Engine;Engine 调用 Spider parse;它产生详情/分页 Request 再进 Scheduler;详情响应触发 parse_job;dict 进入 Item Pipeline 和 Feed Exporter。Stats Collector 在各阶段接收信号并累计统计。
callback=self.parse_job 传递可调用对象,等响应回来由 Engine 注入 response;callback=self.parse_job() 会在构造 Request 当下执行,由于缺少 response 立即 TypeError,即便勉强传值,传入 callback 的也会是调用结果而非函数。
重复链接首先经过 parse_listing 的列表收集;当前解析器会按 DOM 出现顺序给出 URL,Scrapy Request 进入 Scheduler 后由请求指纹去重。跨任务再次运行时 Scheduler 去重历史未必保留,所以数据库 (tenant_id, source_url) 唯一约束仍承担最终幂等。可以用下面命令观察单测构造出的请求:
.\.venv\Scripts\python.exe -m pytest tests\test_framework_adapters.py::test_scrapy_spider_emits_detail_and_pagination_requests -q
先定义交付物,再运行 Spider
一个 Spider “能跑”并不等于能交付。JobRadar 需要逐行 JSON:每行独立解析、UTF-8、不转义中文、日期是 ISO 字符串、字段与 JobItem 一致。这样的文件可以流式导入数据库,也能在后续交给数据分析或 RAG,不必一次把整个数组载入内存。
详情回调因此不返回 HTML 片段,也不返回 Scrapy Selector,而是经过 parse_detail 和 Pydantic 的 dict。输入是一个详情 Response,输出是零或一个业务 item;页面字段缺失时明确失败,不生成半条职位。
用本地 TargetLab 实际跑一次
先在一个终端启动受控目标:
cd project
.\.venv\Scripts\python.exe -m uvicorn targetlab.app:app --host 127.0.0.1 --port 8011
再开另一个终端执行 Spider。-O 表示覆盖输出;如果用 -o 追加,多次练习会把旧行混进新结果:
cd project
.\.venv\Scripts\scrapy.exe runspider src\jobradar\scrapy_spider.py `
  -a seed_url=http://127.0.0.1:8011/jobs?page=1 `
  -O data\scrapy-jobs.jsonl:jsonlines `
  -s LOG_LEVEL=INFO
命令行运行单文件 Spider 时,Python 包导入路径必须来自已安装的 editable 项目;这也是前面要求 pip install -e 的原因。若只双击脚本,Scrapy Engine 并不会自动启动。
输出文件应有三行。用 Python 而不是肉眼验证:
.\.venv\Scripts\python.exe -c "import json,pathlib; p=pathlib.Path('data/scrapy-jobs.jsonl'); rows=[json.loads(x) for x in p.read_text(encoding='utf-8').splitlines()]; print(len(rows), rows[0]['title'], rows[0]['published_at'])"
期望类似 3 Python 后端工程师 2026-09-01。这一步同时抓住空文件、中文编码、日期不可序列化和字段名漂移。课程检查点则专门验证 callback 输出:
.\.venv\Scripts\python.exe -m pytest tests\test_framework_adapters.py::test_scrapy_detail_callback_yields_json_serializable_item -q
为什么不在 parse_job 直接写数据库
回调直接创建 Session、commit 会把调度逻辑与事务绑死,测试需要真实数据库,而且高并发时容易耗尽连接。更合适的方案有两种:小型任务让 Item Pipeline 持有一次 Spider 生命周期内的资源;与现有 JobRadar 集成时,让 item 进入清洗/持久化适配层,调用 JobRepository.upsert,统一 tenant 与幂等规则。
无论选择哪种,Spider 都应该产出稳定合同,而不是同时负责登录、解析、SQL 和告警。框架回调越胖,失败后越难知道应该重试网络还是回滚事务。
Feed 输出并不是数据库
JSONL 是一次运行的工件,不支持并发唯一约束、租户查询或任务状态。它适合抽样、交接和离线重放,却不能替代 PostgreSQL。反过来,数据库也不适合作为源页面证据,所以第 12 篇保存原始快照。项目真实存在三个层次:原始 HTML、经过校验的 JobItem、可查询的 JobRecord。
处理坏页面时要看统计
若详情解析抛异常,Scrapy 日志会出现 spider error,成功 item 数小于发现请求数。不要看到进程退出码为 0 就宣布全量成功;至少查看 item_scraped_count、响应状态分布、retry/count、downloader/exception_count 和 finish_reason。第 18 篇会把这些数字变成运行判断。
本篇完整 JobSpider
与上一篇使用同一源码,但阅读焦点改变:这次关注 parse_job 的输出合同以及 custom_settings 对导出的影响。重复展示完整模块是为了让单篇发布时读者不必跳回旧文拼代码。
"""让 Scrapy 的调度能力复用 JobRadar 已验证的解析合同。"""

from collections.abc import Iterable
from urllib.parse import urlsplit

import scrapy
from scrapy.http import Response

from jobradar.parsing import parse_detail, parse_listing


class JobSpider(scrapy.Spider):
    """采集 TargetLab 列表与详情;item 字段与 JobItem 完全一致。"""

    name = "jobradar_jobs"
    custom_settings = {
        "ROBOTSTXT_OBEY": True,
        "AUTOTHROTTLE_ENABLED": True,
        "CONCURRENT_REQUESTS_PER_DOMAIN": 2,
        "DOWNLOAD_TIMEOUT": 10,
        "RETRY_HTTP_CODES": [429, 500, 502, 503, 504],
        "FEED_EXPORT_ENCODING": "utf-8",
    }

    def __init__(self, seed_url: str, *args: object, **kwargs: object) -> None:
        super().__init__(*args, **kwargs)
        parts = urlsplit(seed_url)
        if parts.scheme not in {"http", "https"} or not parts.hostname:
            raise ValueError("seed_url must be an absolute HTTP(S) URL")
        self.start_urls = [seed_url]
        self.allowed_domains = [parts.hostname]

    def parse(self, response: Response, **kwargs: object) -> Iterable[scrapy.Request]:
        listing = parse_listing(response.text, response.url)
        for detail_url in listing.detail_urls:
            yield scrapy.Request(detail_url, callback=self.parse_job)
        if listing.next_url:
            yield scrapy.Request(listing.next_url, callback=self.parse)

    def parse_job(self, response: Response) -> Iterable[dict[str, object]]:
        item = parse_detail(response.text, response.url)
        yield item.model_dump(mode="json")
本篇课后练习
- 实际运行 TargetLab 与 Spider,把三行 JSONL 逐行读回,并写出完整校验脚本:字段集合一致、日期是字符串、source_url 唯一。
- 比较
-o与-O,解释为什么定时全量导出通常选择覆盖,而事件流才选择追加。 - 故意使用
job-detail-missing-title.html调parse_job,记录异常字段名,并说明为什么不能返回 title 为空的 dict。下一篇从一次“进程成功但数据少了”的故障开始学习 Scrapy 统计和节流。
智能硬件社区聚焦AI智能硬件技术生态,汇聚嵌入式AI、物联网硬件开发者,打造交流分享平台,同步全国赛事资讯、开展 OPC 核心人才招募,助力技术落地与开发者成长。
更多推荐
 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)