C语言程序员转AI大模型?别人笑我太疯癫,我笑他人看不穿!
听说你是搞C语言的?
天天对着寄存器写代码,对着示波器调Bug?
STM32、FreeRTOS、Linux内核驱动,这些你闭着眼睛都能写?
摸过GPIO,调过I2C,搞过DMA,踩过各种底层深坑?
那我来问你一句话:你拿这个手艺,年薪过了40万没有?
没到的话,别急着自我怀疑。
是你的能力被低估了,不是你不努力。
C语言程序员转AI大模型开发,这条路比你想象的靠谱得多。
而且竞争者少,因为大多数AI选手根本搞不定你日常干的那些活。
🔹第一,大模型推理加速是C语言的天然主场,Python选手根本卷不动。
很多人以为搞AI就是Python调包、炼丹。
那是训练阶段。
真正商用的AI产品,推理层全是C/C++写的。
TensorRT、ONNX Runtime、MLC-LLM、GGML,底层全是C++。
为什么?因为推理要快、要省内存、要跑在各种奇怪的环境里。
Python根本兜不住这个底。
而你一个写了多年C的程序员,调推理引擎比Python选手强太多了。
性能优化是你的看家本领,AI推理加速你来做简直是无缝衔接。
薪资直接上一个台阶,而且做的人少,竞争没那么激烈。
🔹第二,嵌入式+AI才是下一个大风口,你已经在风眼里了。
大模型不只是跑在服务器和电脑上。
智能摄像头、工业机器人、自动驾驶终端、边缘计算设备,AI推理都要在端侧跑。
Apple Intelligence为什么牛?因为大模型跑在了你的手机本地。
这就需要大量懂嵌入式的AI开发者。
你懂嵌入式系统、懂硬件驱动、懂实时性约束、懂资源优化。
这类边缘AI开发岗位,市场上极度缺人。
纯AI背景的人做不了,因为他们搞不定硬件那一套。
纯嵌入式背景的人也需要补AI能力。
而你,两样都有,年薪50万根本不是上限。
🔹第三,从Triton Inference Server切入,别从Python深度学习学起。
这是最重要的一条建议。
别傻乎乎地跑去跟Python选手卷PyTorch、卷TensorFlow。
你的路线图是:Triton Inference Server → TensorRT → CUDA。
这些东西对C程序员来说,比深度学习那些玄学理论好理解得多。
Triton本质就是一个高性能推理服务器,你写服务端的时候接触过类似的东西。
TensorRT是NVIDIA的推理优化工具,跟你调嵌入式性能优化的思路一模一样。
你甚至会发现,很多概念跟你写驱动的时候是相通的。
这条路你走得比大多数人都稳。
C语言程序员,从来都不是被时代抛弃的人。
只是你的底层能力,一直没有被正确估值。
大模型这波浪潮,把你的底层能力放到台面上发光的机会来了。
能写C的人学AI,比纯AI背景的人学底层,要容易得多。
这个账要算清楚。
而且嵌入式开发有个天然的瓶颈:市场盘子太小。
工资的天花板比较低,不是因为你不行,是因为整个行业的体量就这么大。
但AI时代,边缘计算和端侧AI把嵌入式和AI两个领域打通了。
你的嵌入式经验,现在可以跟AI能力叠加。
叠加之后,你的市场就不只是嵌入式那一小块了。
是整个AI端侧应用的大市场。
这个转变,才是真正的破局。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
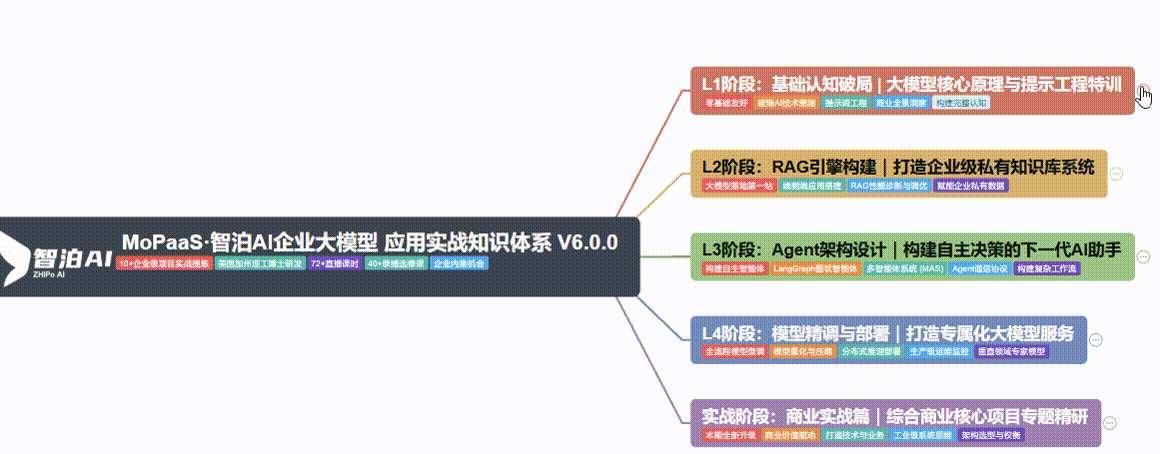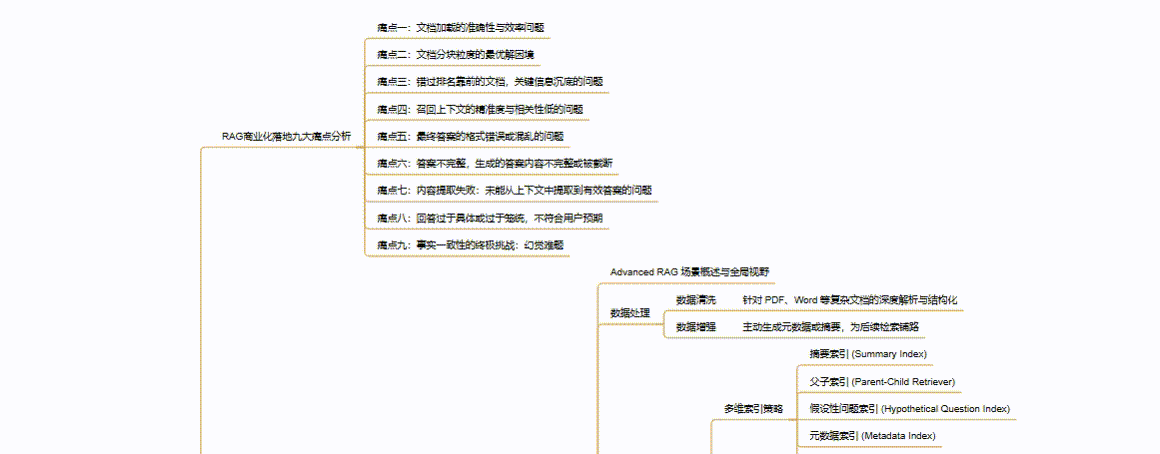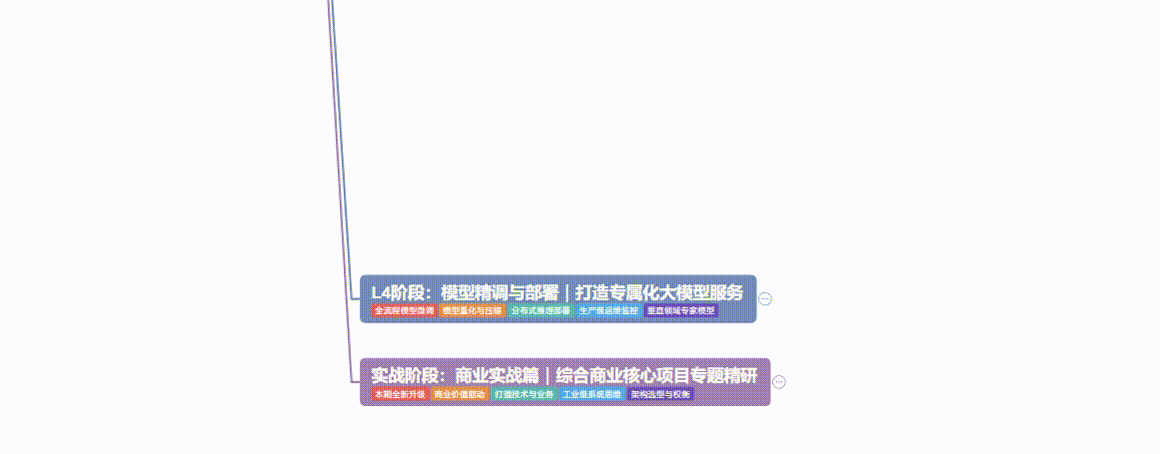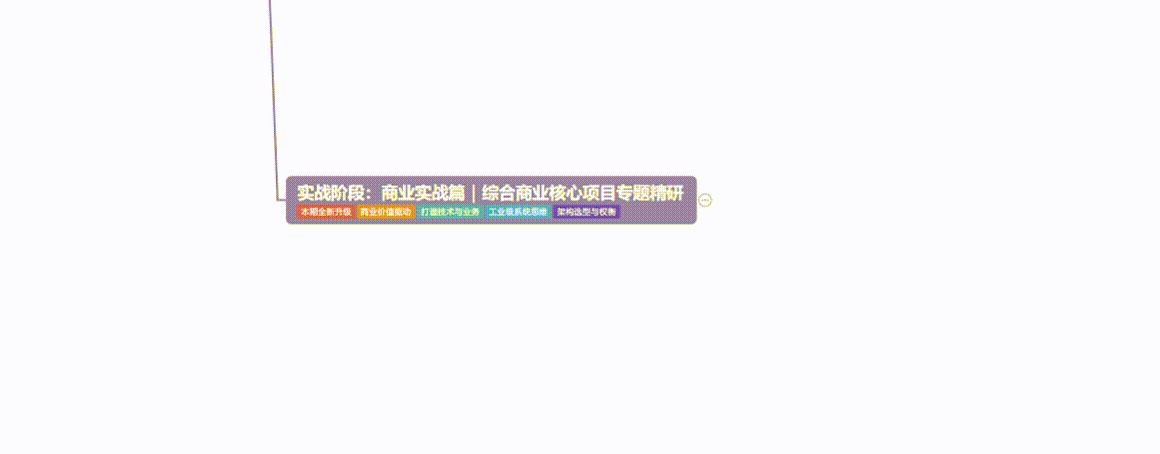
1、大模型系统化学习路线
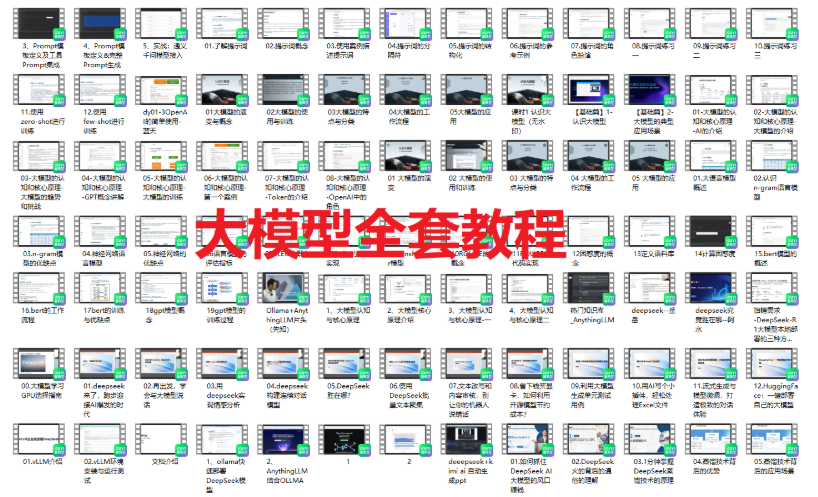
2、大模型学习视频教程
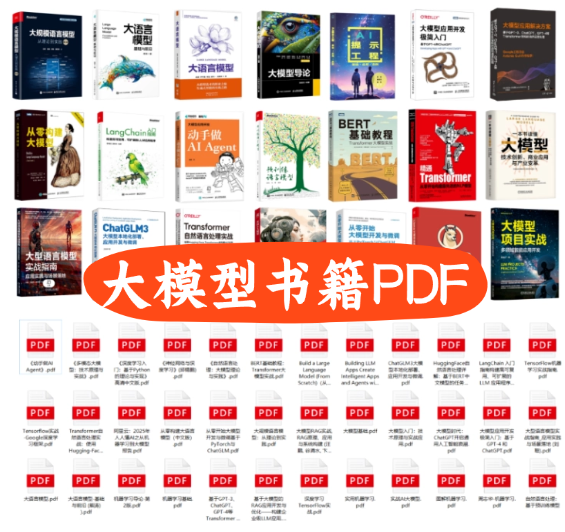
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
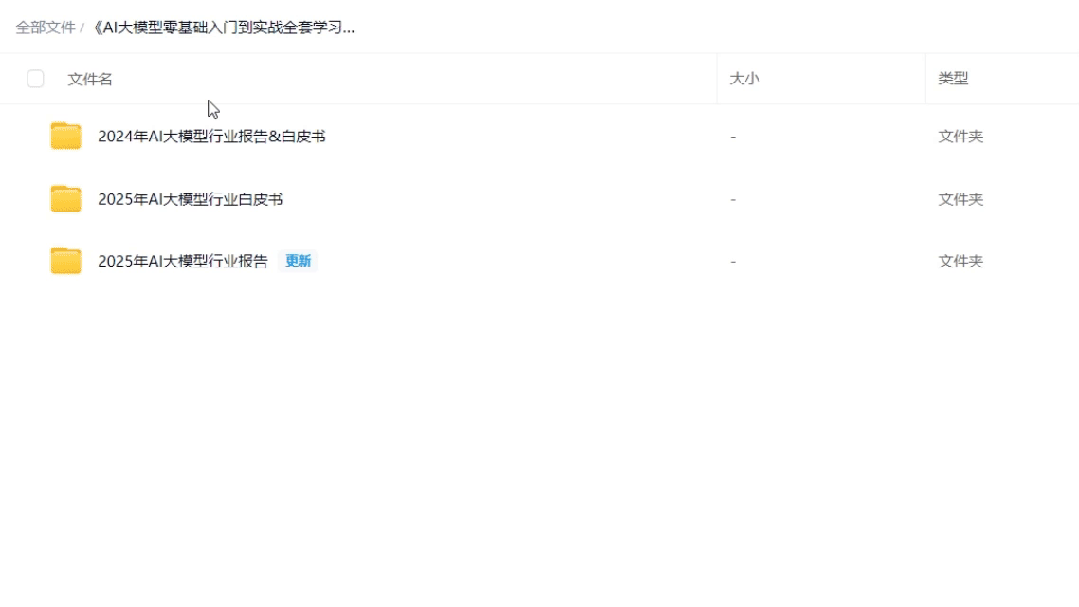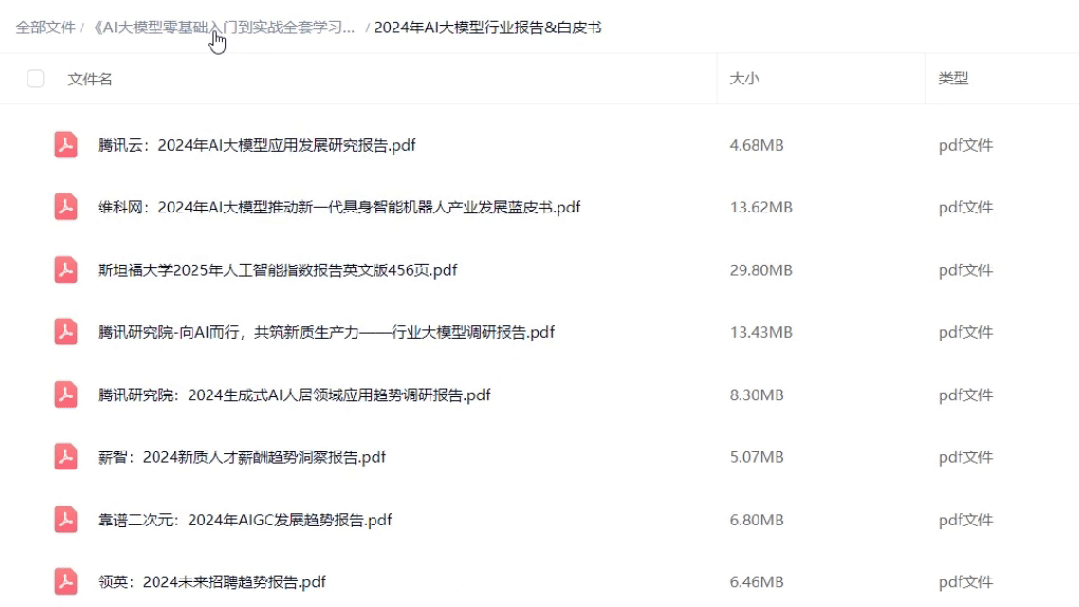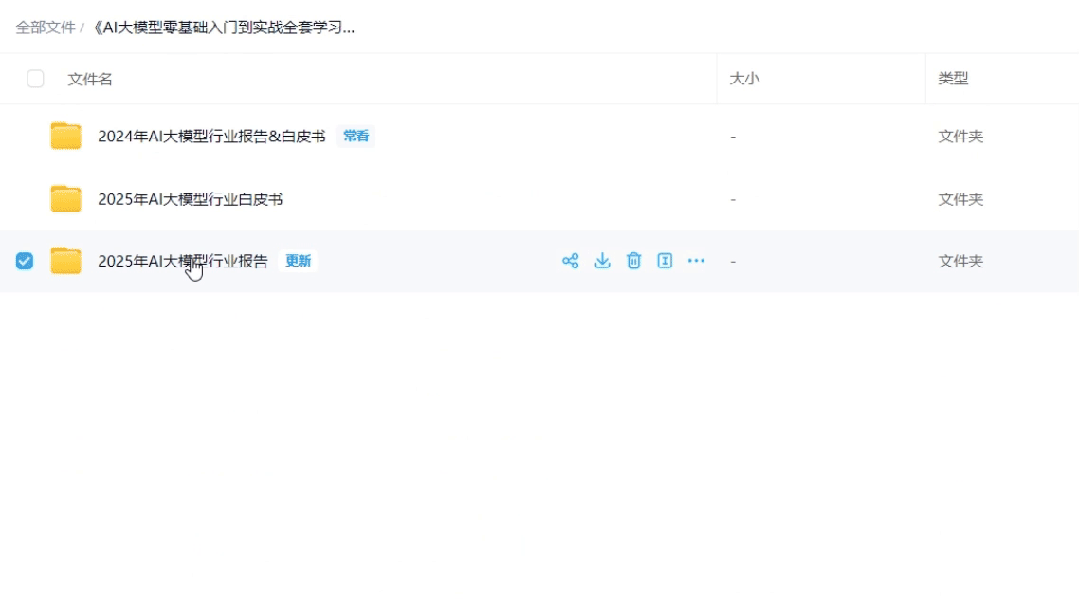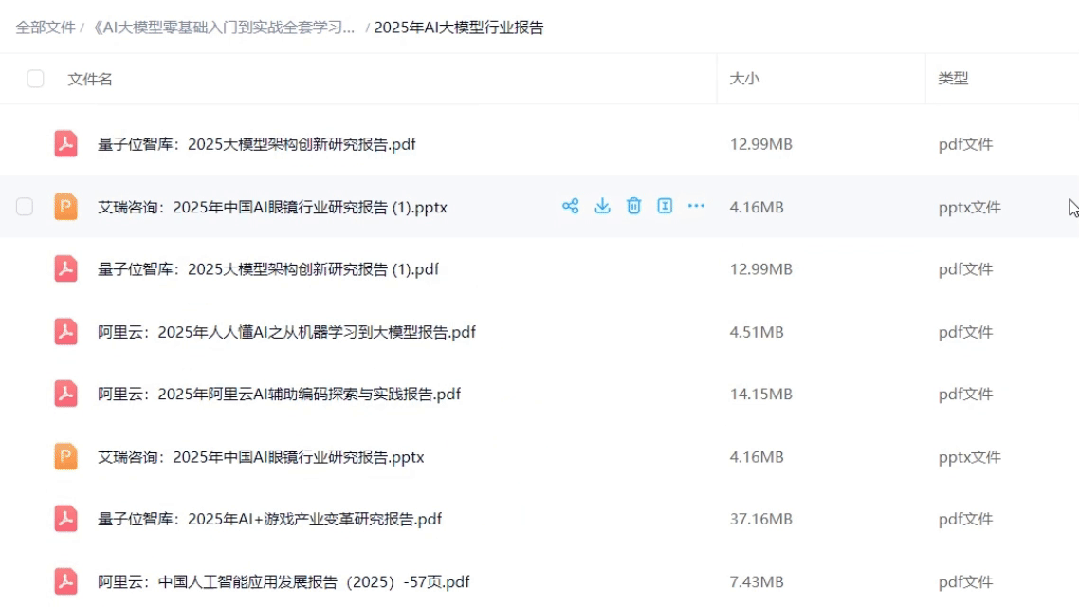
5、大模型项目实战&配套源码
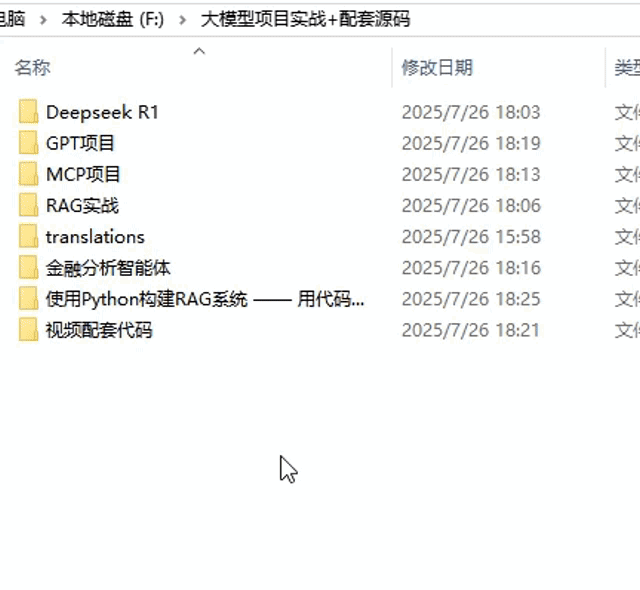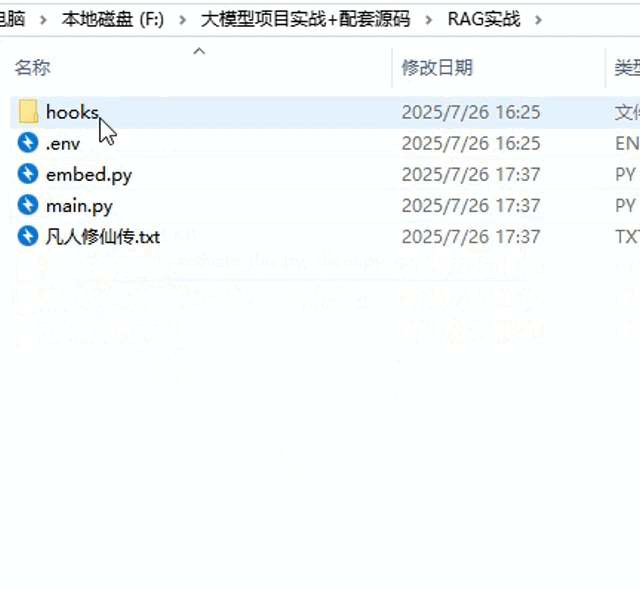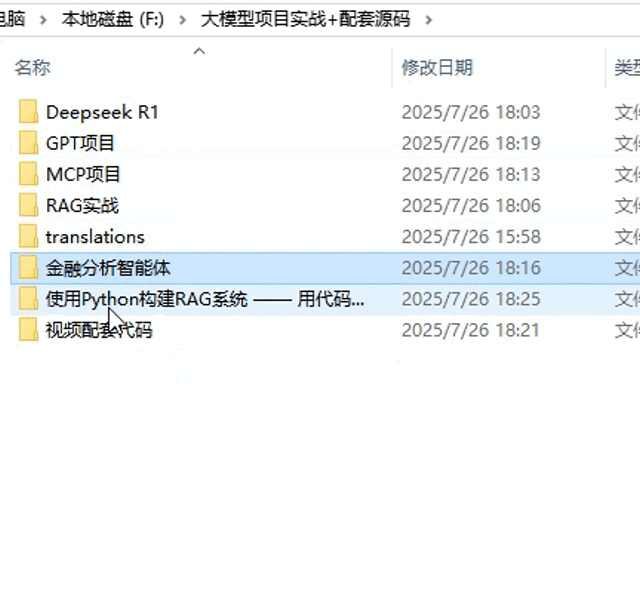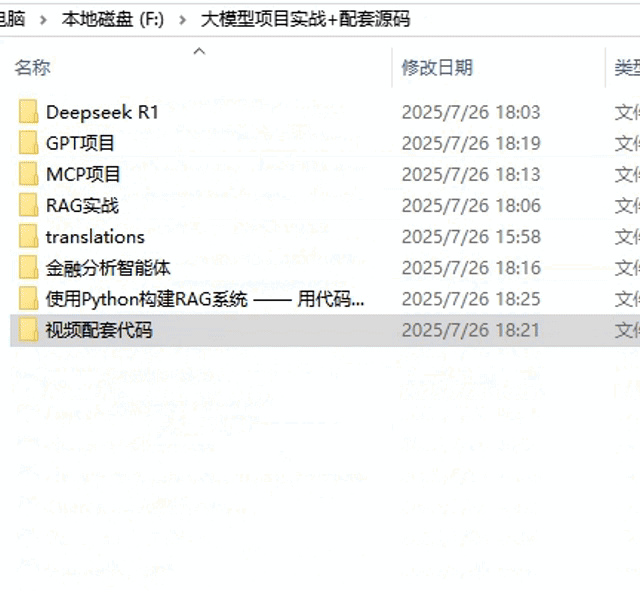
6、2026大模型大厂面试真题
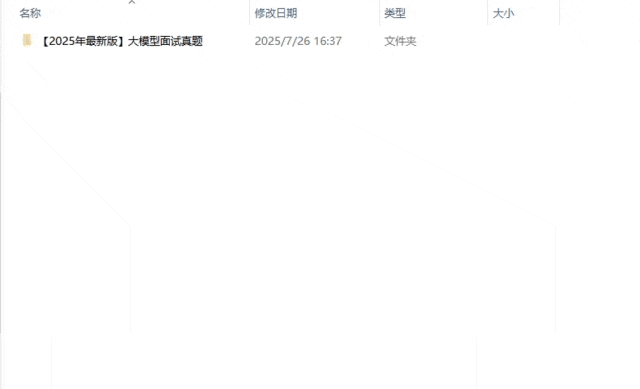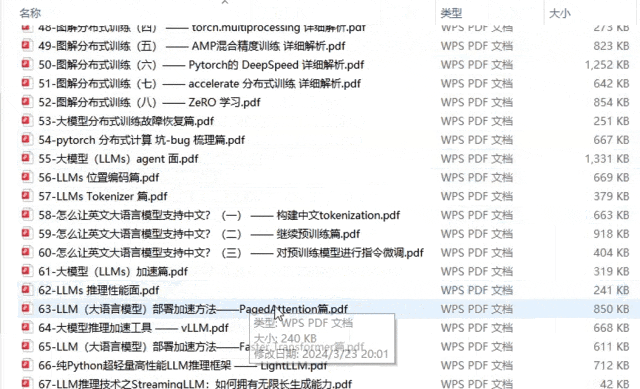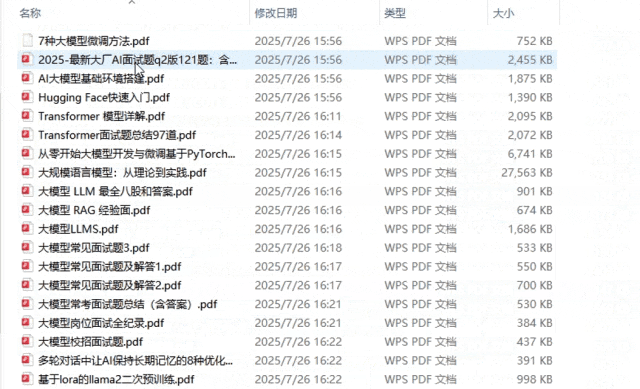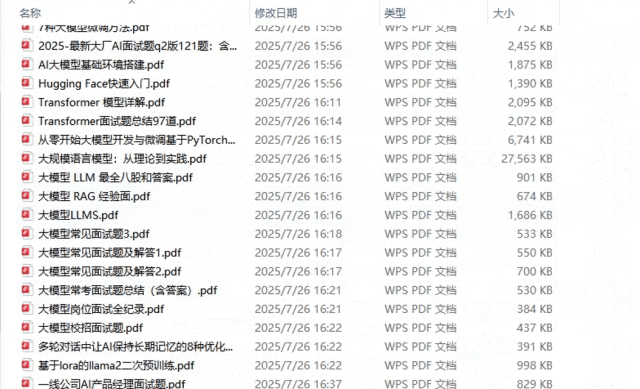
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
👇👇扫码免费领取全部内容👇👇

智能硬件社区聚焦AI智能硬件技术生态,汇聚嵌入式AI、物联网硬件开发者,打造交流分享平台,同步全国赛事资讯、开展 OPC 核心人才招募,助力技术落地与开发者成长。
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)