云安全 · 02 · 容器与 Docker 安全基础
这一篇要彻底搞懂:容器到底靠什么隔离?为什么它不像虚拟机那么安全?
一、容器是什么
容器是操作系统级别的虚拟化:它不虚拟出一整套硬件,而是让多个进程共用同一个 Linux 内核,只是给每个进程组套上“隔离罩”。
1.1 容器 vs 虚拟机
| 对比项 | 虚拟机(VM) | 容器 |
|---|---|---|
| 隔离层次 | 硬件级,各自有独立内核 | 进程级,共享宿主内核 |
| 启动速度 | 分钟级 | 毫秒~秒级 |
| 体积 | GB 级 | MB 级 |
| 隔离强度 | 强(Hypervisor 隔离) | 较弱(内核出问题就一起完蛋) |
| 逃逸难度 | 需攻破 Hypervisor | 内核/配置有缺陷即可逃逸 |
核心安全结论:容器共享内核,所以内核漏洞、危险配置都能导致逃逸。这也是第 03 篇存在的原因。
二、容器隔离的三大支柱
容器的“隔离罩”由三样东西组成,缺一不可:
2.1 Namespace(命名空间)—— 负责“看不见”
Namespace 让容器里的进程看不到宿主机的其他资源。Linux 有 8 种:
| Namespace | 隔离内容 | 看不到什么 |
|---|---|---|
mnt (Mount) | 挂载点/文件系统 | 宿主机的目录树 |
pid (PID) | 进程号 | 宿主机的其他进程 |
net (Network) | 网卡、IP、端口、路由 | 宿主机的网络 |
ipc (IPC) | 进程间通信(信号量、共享内存) | 宿主机的 IPC |
uts (UTS) | 主机名和域名 | 宿主机 hostname |
user (User) | 用户和用户组 ID | 宿主机的用户(容器内 root 可映射成宿主普通用户) |
cgroup | cgroup 视图 | 宿主机的 cgroup 树 |
time | 系统时钟(较新) | 宿主机的时钟偏移 |
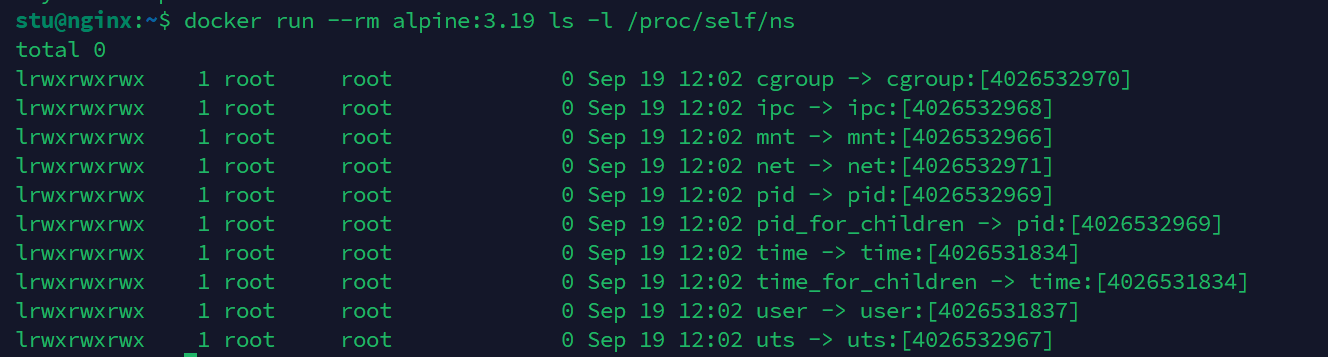
在容器里查看自己的 namespace
docker run --rm alpine:3.19 ls -l /proc/self/ns
docker run = 新建容器 + 立刻启动容器,一步完成两件事:
- 根据镜像(如 alpine:3.19)创建容器实例(镜像相当于模板,容器是模板跑起来的实例)
- 启动这个容器,执行里面指定的程序。
逐段解释:
-
docker run:启动一个容器。 -
--rm:容器退出后自动删除,避免堆积垃圾容器。 -
alpine:3.19:使用的镜像,Alpine 是一个只有几 MB 的极小 Linux。 -
ls -l /proc/self/ns:/proc/self是当前进程自己的信息目录,ns子目录列出该进程所属的各种 namespace。 -
/proc/self是当前正在访问这个目录的进程的 proc 信息,/proc/self/ns就是当前进程所属 Linux Namespace(内核命名空间)的目录
关键理解:容器里每个 namespace 后面都带一个 [...] 编号(如 mnt:[4026532...])。如果和宿主机上 ls -l /proc/1/ns 的编号不同,就说明被隔离了。
2.2 Cgroups(控制组)—— 负责“用多少”
Namespace 管“看得见看不见”,Cgroup 管“能用多少”:CPU、内存、磁盘 IO、进程数上限。
为什么和安全有关:cgroup 的某些功能(尤其 cgroup v1 的 release_agent)历史上被用作逃逸入口
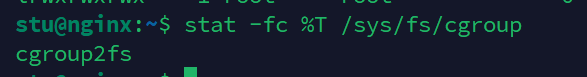
实验:确认环境是 cgroup v2
stat -fc %T /sys/fs/cgroup
-
stat:查看文件/文件系统信息。 -
-f:显示文件系统信息。 -
-c %T:只输出文件系统类型。 -
输出
cgroup2fs表示 cgroup v2;输出tmpfs表示 cgroup v1。 -
cgroup2fs 是 cgroup v2(第二代控制组)对应的内核伪文件系统(虚拟文件系统),用于限制、统计进程 CPU / 内存等资源,是容器资源管控底层,搭配 namespace 实现容器隔离。
可能踩坑:本实验环境是 cgroup v2(输出
cgroup2fs)。网上很多老教程的release_agent逃逸手法在 cgroup v2 上无效。
2.3 联合文件系统(UnionFS / overlayfs)—— 负责“文件从哪来”
容器镜像是一层层叠加的只读层,最上面加一个可写层。容器运行时的写操作都落在可写层,删掉容器可写层就没了。
-
好处:镜像分层复用,省空间、启动快。
-
安全含义:镜像层是只读的,但可写层和挂载点是攻击者重点利用的地方(如挂载宿主机目录)。
实验:查看存储驱动
docker info | grep -i "storage driver"
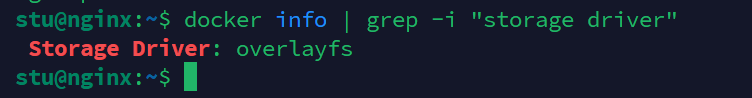
Storage Driver 是 Docker 用来管理容器镜像、容器文件系统的驱动程序。
输出 Storage Driver: overlayfs,指 Docker 当前使用的存储驱动类型, overlayfs 通常就是 overlay2 驱动在特定 环境或旧版本中的显示名称。(旧版本叫 overlay2)。
三、Docker 架构与组件
理解组件关系,才能理解逃逸的“跳板”在哪里:
API 是应用编程接口,是软件之间交互的约定,允许一个程序调用另一个程序的功能,REST API 是遵循 REST 风格的 Web API。
docker 命令行
     │  (REST API,默认走 /var/run/docker.sock)
     ▼
dockerd(Docker 守护进程,接收 API 请求)
     │
     ▼
containerd(容器生命周期管理)
     │
     ▼
runc(真正调用内核 namespace/cgroup 创建容器的工具)
     │
     ▼
容器进程
敲docker run只是客户端,真正干活的是后台守护进程 dockerd;dockerd 再调用 containerd,containerd 调用 runc,runc 去调用 Linux 内核的 namespace、cgroup 接口,拉起容器里面的业务进程,这个就是容器进程。
| 组件 | 作用 | 安全关注点 |
|---|---|---|
docker CLI | 客户端 | - |
dockerd | 守护进程,监听 socket | docker.sock 泄露 = 控制整台宿主机 |
containerd | 运行时管理 | containerd.sock 同理 |
runc | 底层创建容器 | runc 漏洞 = 容器逃逸(CVE-2019-5736) |
| OCI | 容器标准规范 | 镜像/运行时遵循标准 |
查看本机 Docker 组件
docker info | grep -Ei "server version|cgroup|runtime|storage"
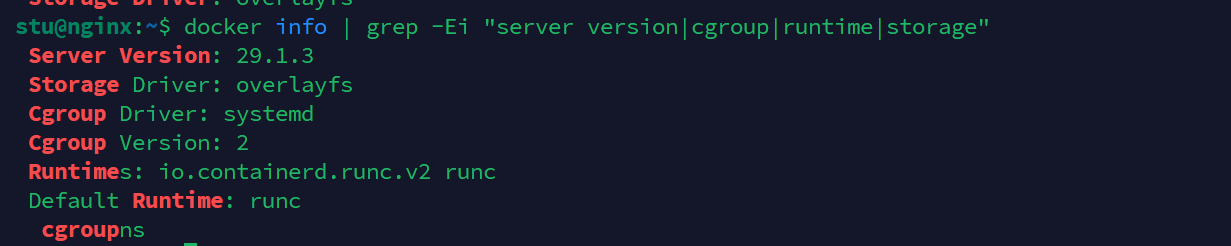
逐行理解:
-
Server Version:dockerd 版本。 -
Storage Driver:文件系统驱动。 -
Cgroup Driver: systemd:cgroup 由 systemd 管理。 -
Cgroup Version: 2:内核 cgroup 版本。 -
Runtimes ... runc:底层运行时是 runc。
四、镜像与 Dockerfile 安全
4.1 镜像分层
docker history 展示镜像的分层构建过程,分层要从下往上看
docker history alpine:3.19

| 列名 | 含义 |
|---|---|
| IMAGE | 该层的镜像 ID(前 12 位)。<missing> 表示这一层没有独立的镜像 ID,通常是被后续层覆盖或作为中间层存在。 |
| CREATED | 该层的创建时间(相对时间)。这里是 11 个月前。 |
| CREATED BY | 创建这一层所执行的命令。 |
| SIZE | 这一层占用的磁盘空间大小。 |
| COMMENT | 注释信息,这里显示是 buildkit.dockerfile.v0,说明是用 BuildKit 构建的。 |
告诉这个镜像是由哪些层(Layer)一层层叠出来的
逐层看镜像怎么构建的。安全含义:
-
镜像层里删掉的文件仍在历史层里,可能泄露密钥(例如构建时
COPY了.env再RUN rm,历史层里还在)。 -
私有镜像仓库未授权可拉取,等于源码/凭证泄露。
4.2 Dockerfile 常见安全问题
Dockerfile 是手动编写的文本构建脚本,用来定义镜像内容;通过 docker build 命令读取 Dockerfile,自动分层构建出 Docker 镜像。
| 问题 | 例子 | 风险 |
|---|---|---|
| 硬编码密钥 | ENV AK=xxx | 镜像里可提取 |
| 使用 root 运行 | 默认就是 root | 逃逸后直接是宿主 root |
| 基础镜像过旧 | FROM ubuntu:16.04 | 含大量已知漏洞 |
| 安装不必要的包 | apt install curl vim gcc | 攻击者拿到后工具齐全 |
ADD 远程文件 | ADD http://... / | 不可控内容 |
| 未固定版本 | FROM node:latest | 供应链不确定性 |
最佳实践:
-
用
USER nonroot以非 root 运行。 -
多阶段构建,最终镜像不含构建工具和密钥。
-
用
hadolint、trivy扫描镜像漏洞和密钥。
五、危险配置项(逃逸的“温床”)
这是本篇最重要的部分。
| 配置 | 含义 | 危害等级 |
|---|---|---|
--privileged | 给容器几乎全部能力 + 访问所有设备 | ★★★★★ |
-v /var/run/docker.sock:/var/run/docker.sock | 把 Docker 控制权给容器 | ★★★★★ |
-v /:/host | 挂载宿主机根目录 | ★★★★★ |
--pid=host | 共享宿主机 PID 命名空间 | ★★★★ |
--network=host | 共享宿主机网络 | ★★★ |
--cap-add=SYS_ADMIN | 增加系统管理能力 | ★★★★ |
--cap-add=SYS_PTRACE | 可调试/注入其他进程 | ★★★ |
--user=0(默认) | 容器内是 root | ★★★ |
| 未启用 seccomp/AppArmor | 缺少系统调用过滤 | ★★ |
5.1 Capabilities(能力)是什么
Linux 把 root 的超级权限拆成了几十种“能力”(capability),容器默认丢弃了大部分危险能力。--privileged 相当于把能力全加回来。
查看容器默认能力 vs 特权容器能力
docker run --rm alpine:3.19 grep Cap /proc/self/statusdocker run --rm --privileged alpine:3.19 grep Cap /proc/self/status
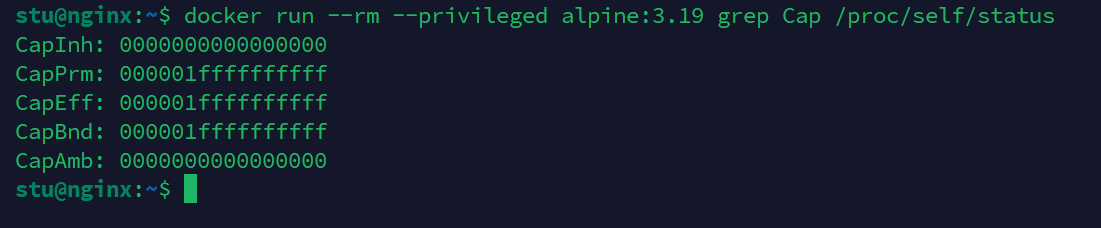
逐段解释:
-
grep Cap /proc/self/status:从进程状态文件里过滤能力字段。 -
输出里
CapEff表示当前生效的能力位图(十六进制)。 -
对比两条命令的
CapEff,特权容器的值明显更大(本环境特权容器是000001ffffffffff,即全部能力)。
CapEff是十六进制位图,人眼看不出含义。可以用capsh --decode=000001ffffffffff解码(需安装libcap2-bin)。
5.2 seccomp 与 AppArmor
seccomp(Secure Computing Mode,安全计算模式)
属于内核的系统调用过滤器
- 作用:限制进程能调用哪些 Linux 系统调用 (syscall)
- 原理:程序要调用内核功能(创建进程、读写文件、修改网络等)都要走系统调用。seccomp 配置白 / 黑名单,禁止危险系统调用。
- Docker 默认自带 seccomp 配置文件,默认禁用几十种高危系统调用,减少容器逃逸攻击面。
举例:阻止容器调用
mount、reboot这类危险 syscall
AppArmor(应用程序强制访问控制 MAC)
属于强制访问控制 MAC 模块(Ubuntu 常用,CentOS 用 SELinux)
- 作用:给程序配置独立的访问权限策略,限制这个程序能读 / 写哪些文件、能访问哪些资源。
- 原理:给进程绑定一个 profile(配置模板),进程只能做 profile 允许的行为。
- Docker 可以加载 AppArmor 配置,限制容器内进程读写宿主机文件。
seccomp:过滤容器能调用的系统调用。Docker 默认启用一个白名单,阻止如 mount、reboot 等危险调用。
AppArmor / SELinux:强制访问控制,进一步限制容器能碰的文件。
--privileged 会关闭这些限制。
六、感受隔离边界
1)容器共享宿主机内核
docker run --rm alpine:3.19 uname -a

回显里的内核版本与宿主机 uname -a 完全一致,这就是“共享内核”的铁证。
2)容器默认看不到宿主机进程
docker run --rm alpine:3.19 ps -ef
#PID=1 是 ps 命令本身
ps(查看进程状态)的参数
- -e:every,列出所有进程(等价
-A),不只是当前终端的进程 - -f:full,完整格式输出,会展示 UID、PID、PPID、STIME、TTY、TIME、COMMAND
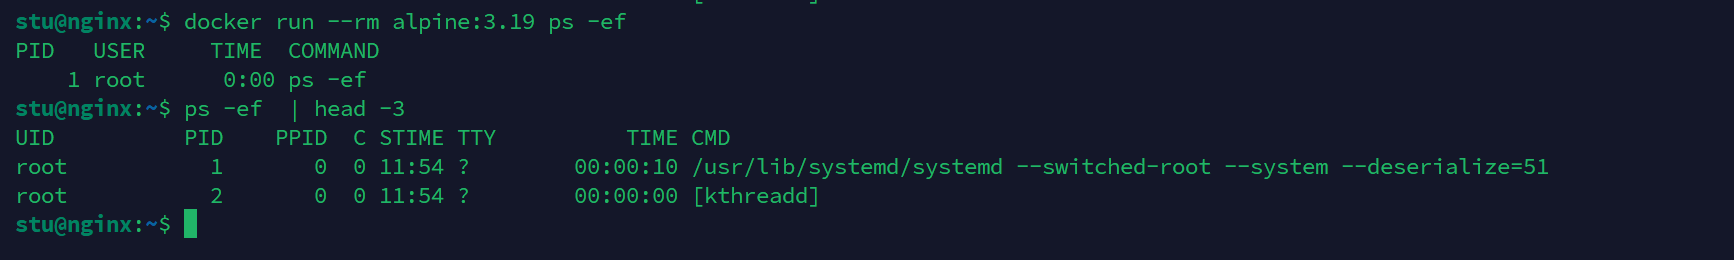
通常只看到容器内自己的几个进程(因为 PID namespace 隔离)。对比在宿主机执行 ps -ef,进程数量完全不同。
3)容器默认有独立网络
docker run --rm alpine:3.19 ip addr
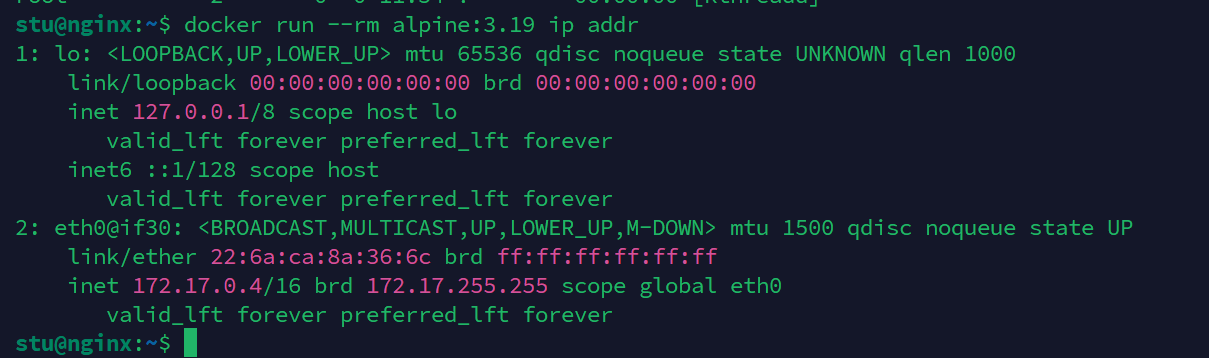
会看到容器自己的 eth0,IP 一般是 172.17.0.x(Docker 默认网桥网段)。宿主机上则有一个 docker0 网桥(本环境是 172.17.0.1)。
4)容器内是 root,但通常逃不出去
docker run --rm alpine:3.19 id
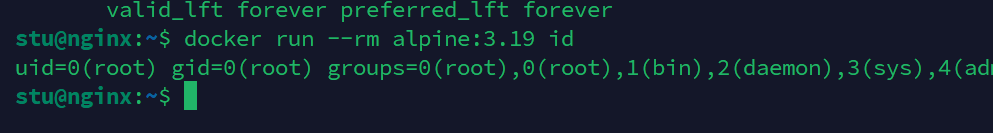
输出 uid=0(root)——注意,这个 root 只是容器 namespace 内的 root,默认情况下它没有权限动宿主机的核心资源。只有配置了特权/挂载等,才会真正危险。
七、防御要点(本篇版)
-
永远不要用
--privileged,除非你完全清楚在做什么。 -
不要把
docker.sock挂进容器;必须用就通过受限代理(如 docker-socket-proxy)只开放必要 API。 -
容器以非 root 用户运行:
docker run --user 1000:1000 ...。 -
按需授予能力,避免
--cap-add=SYS_ADMIN:--cap-drop=ALL --cap-add=NET_BIND_SERVICE。 -
不要
--pid=host / --network=host,除非确有需要。 -
启用 seccomp、AppArmor(Docker 默认已开,别关)。
-
用
trivy/grype扫描镜像漏洞,用hadolint检查 Dockerfile。 -
宿主机及时打内核补丁。
八、本篇小结
-
容器 = 共享内核 + namespace 隔离 + cgroup 限额 + 联合文件系统。
-
namespace 管“看不见”,cgroup 管“用多少”,UnionFS 管“文件从哪来”。
-
Docker 调用链:
docker → dockerd → containerd → runc → 容器。 -
危险配置是逃逸的根本原因:
--privileged、docker.sock、-v /:/host、--pid=host。 -
本环境是 cgroup v2,部分老逃逸手法失效。
智能硬件社区聚焦AI智能硬件技术生态,汇聚嵌入式AI、物联网硬件开发者,打造交流分享平台,同步全国赛事资讯、开展 OPC 核心人才招募,助力技术落地与开发者成长。
更多推荐
 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)