【学习笔记】 STM32 的 CMake 构建系统
STM32 + CMake 全流程图解:从 CMakeLists 到 F103.bin
不扯 CMake 的历史,也不铺垫编译原理,直接上干货。
本文基于一个真实的 STM32F103(Cortex-M3)裸机工程,配 10 张自制插图,按 CMake 自己的两个阶段——配置阶段和构建阶段——把「用 CMake 开发 STM32」这件事讲透。文中所有数字都来自真实编译日志(Arm GNU Toolchain 13.3.1)。
超级鹿鹿子/cmake+stm32
本次用的模板工程项目地址
0. 先看结果
我们要做的事,最终就是敲两条命令:
cmake -B build -G Ninja      # 第一条:配置
cmake --build build          # 第二条:构建
然后 build/ 目录里就躺着这四个文件:
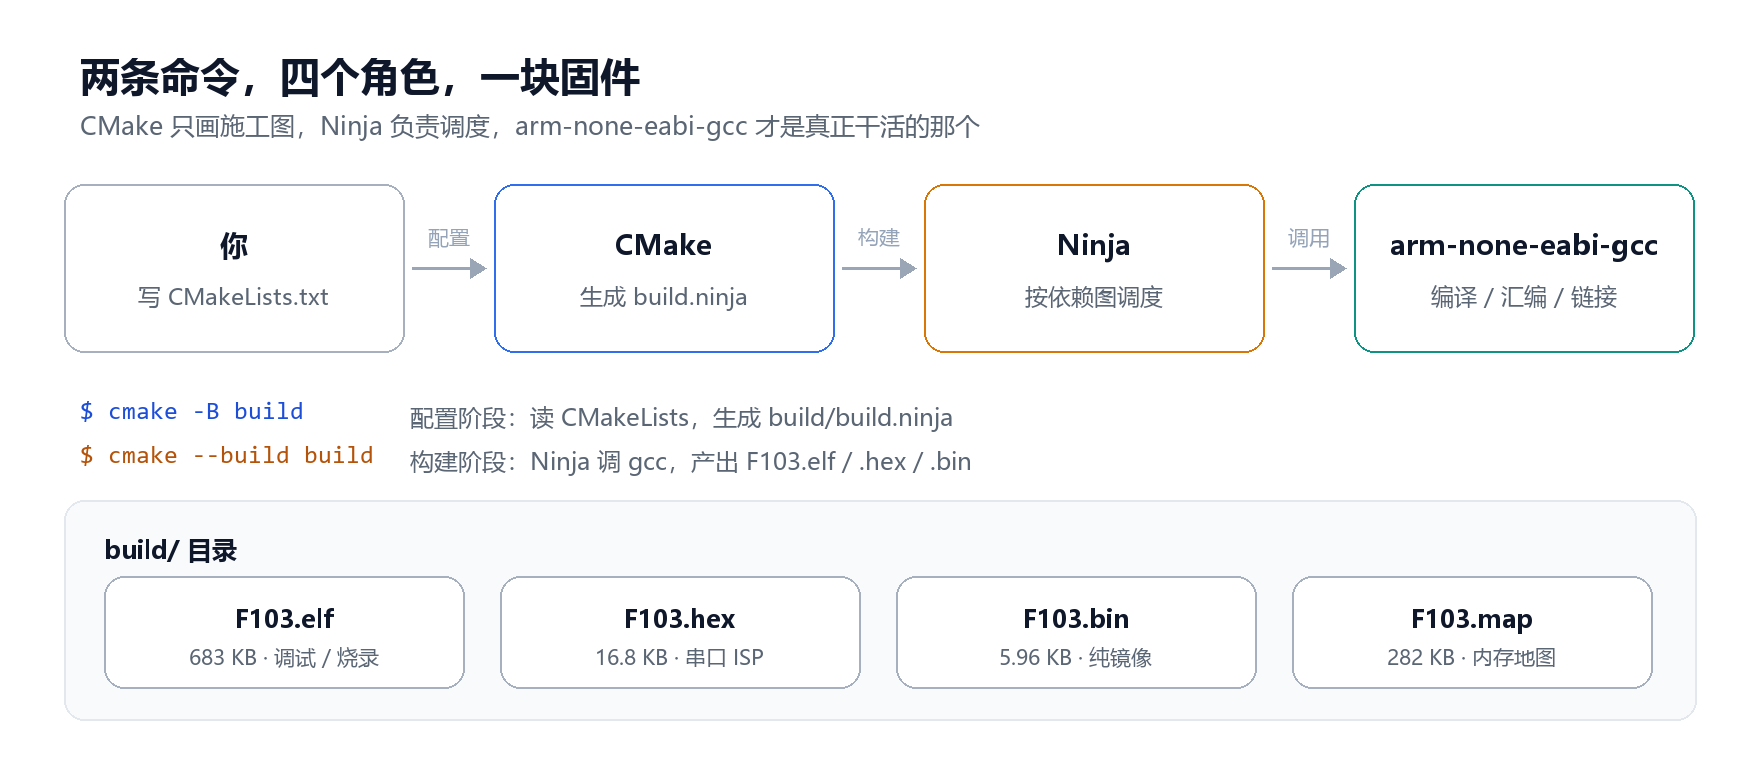
先别急着看代码。这张图里其实藏着一个很多人一开始就搞错的事实:CMake 不编译代码。真正把 .c 变成机器码的是 arm-none-eabi-gcc,而指挥它的又是 Ninja。CMake 只负责把工程「翻译」成施工图。
四个角色的分工,一句话一个:
| 角色 | 干什么 | 类比 |
|---|---|---|
| 你 | 写 CMakeLists.txt | 出需求 |
| CMake | 读配置,生成 build/build.ninja | 设计院出施工图 |
| Ninja | 按依赖图决定编译谁、什么顺序 | 施工队长派活 |
| arm-none-eabi-gcc | 编译、汇编、链接 | 工人 |
至于 CMakeLists.txt 本身是什么:
CMakeLists.txt是 CMake 这个「构建系统生成器」读取的工程配置文件。
搞清楚了这两个前提,动手前就只剩两个文件要准备:
-
工具链文件(
cmake/cortex_m3.cmake)——告诉 CMake 用哪套编译器; -
工程配置文件(
CMakeLists.txt)——告诉 CMake 这个工程由哪些源文件组成。
本工程的目录结构如下,后文就按这个顺序展开:
f103/
├── CMakeLists.txt                  ← 顶层工程总纲(第 1.1 / 1.3 节)
├── cmake/
│   ├── cortex_m3.cmake             ← 工具链文件(第 1.2 节)
│   ├── cortex_m4.cmake
│   └── cortex_m7.cmake
├── STM32F103XX_FLASH.ld            ← 链接脚本(第 2.3 节)
├── src/
│   ├── app/CMakeLists.txt          ← 应用层(第 1.4 节)
│   └── driver/CMakeLists.txt       ← 驱动层(第 1.4 节)
└── third_party/
    └── st/STM32F1xx_HAL_Driver/
        └── CMakeLists.txt          ← HAL 库(第 1.4 节)
1. 配置阶段:CMake 在画施工图
cmake -B build 这一下敲下去,CMake 会把工程里所有 CMakeLists.txt 全部读一遍,最后吐出 build.ninja。这一阶段不产生任何机器码。
顶层文件干的事,按顺序是:定规矩 → 选工具链 → 宣布开工 → 建目标 → 挂代码 → 定链接 → 导出产物。先看骨架(省略了细节):
cmake_minimum_required(VERSION 3.20) # ① 最低版本
set(CMAKE_C_STANDARD 17) # ② 语言标准
set(CMAKE_C_STANDARD_REQUIRED ON)
set(CMAKE_CXX_STANDARD 20)
set(CMAKE_CXX_STANDARD_REQUIRED ON)
set(CMAKE_BUILD_TYPE Debug) # ③ 构建类型
set(CMAKE_TOOLCHAIN_FILE ".../cortex_m3.cmake") # ④ 工具链(见第 1.2 节)
project(F103 LANGUAGES C CXX ASM) # ⑤ 正式开工
add_executable(${PROJECT_NAME}) # ⑥ 建一个"空目标"
# ⑦ 往目标上挂头文件路径、源文件(1.3 / 1.4 节)
# ⑧ 指定链接脚本(2.3 节)
# ⑨ 编译完导出 hex/bin(2.3 节)1.1 它按什么顺序读文件
配置阶段的执行路径是确定的,不是「大概遍历一下」:
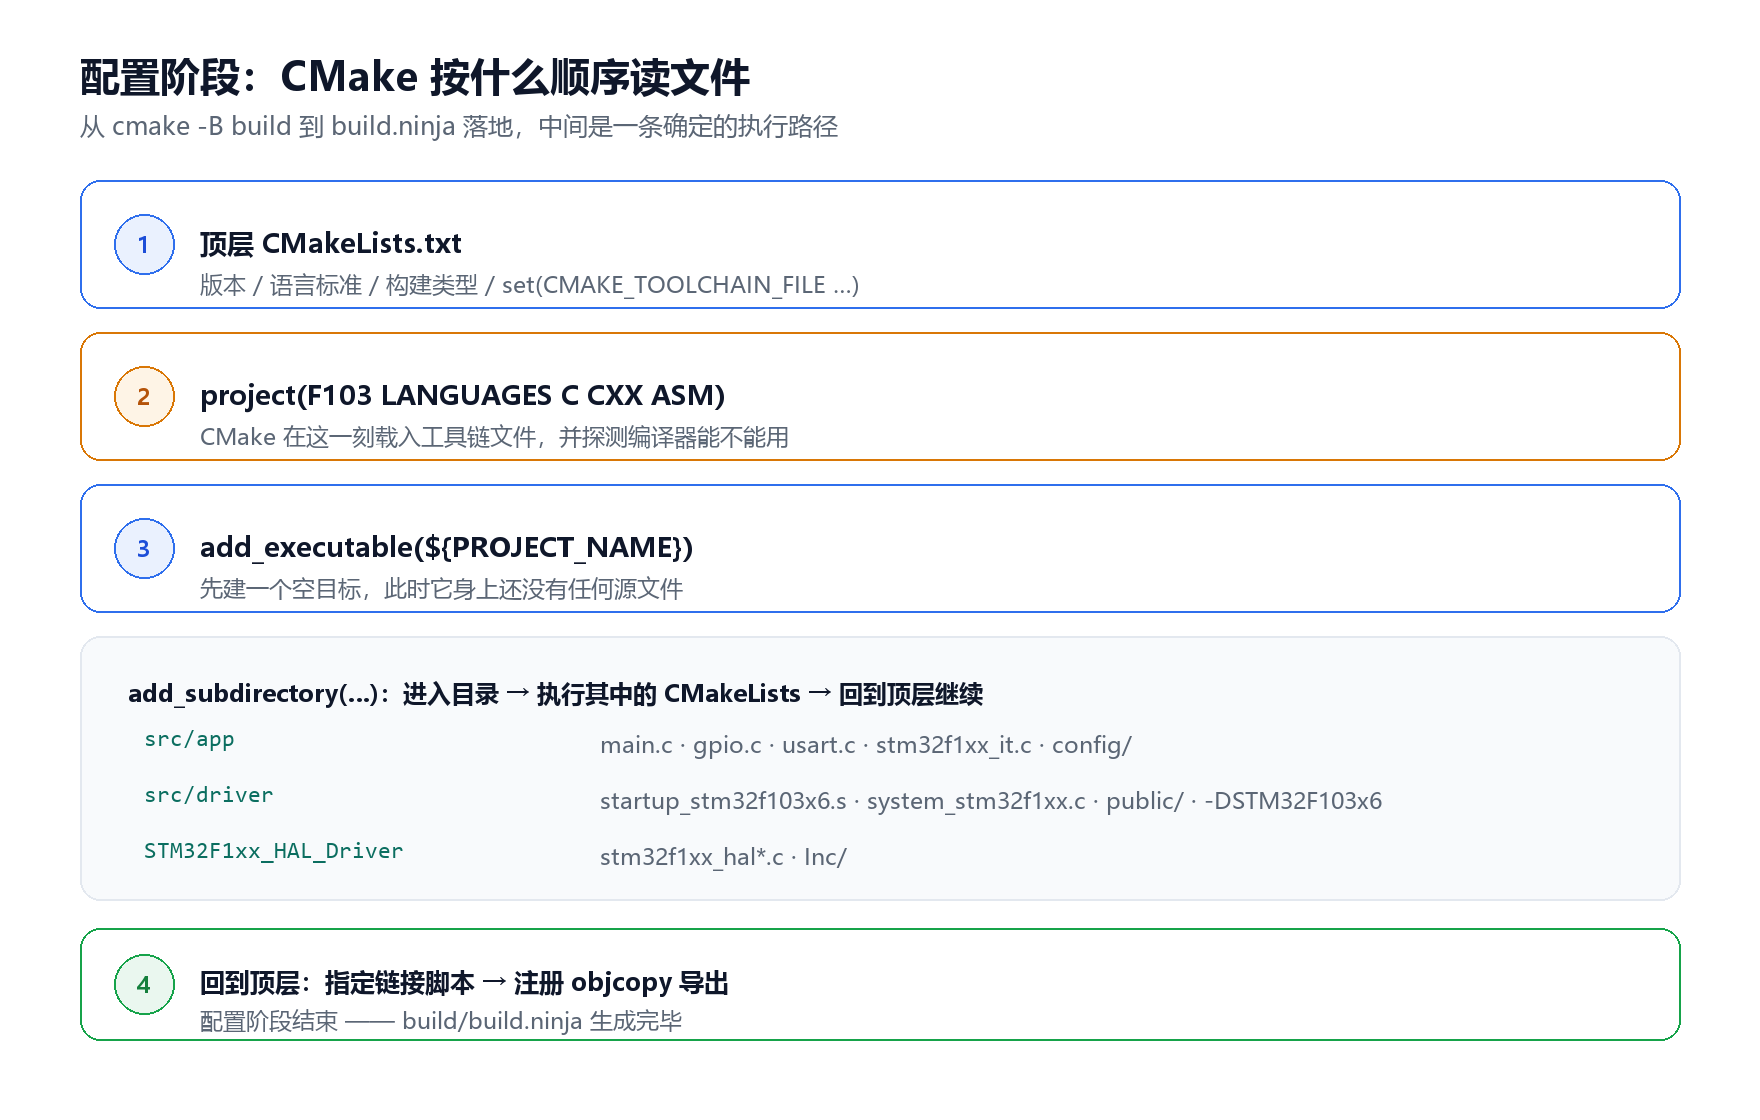
三个要点:
-
工具链文件不是自己跑的,它由顶层那个
set(CMAKE_TOOLCHAIN_FILE ...)引入,并且必须写在project()之前——原因见 1.2 节末尾那个「全文第一大坑」。 -
add_executable(${PROJECT_NAME})建的是一个空目标,此刻它身上一个源文件都没有。 -
add_subdirectory(…)是递归进入 → 执行 → 返回,所以执行顺序是:顶层上半 → app → driver → HAL → 顶层下半。
project() 前后是两个世界。 project(F103 LANGUAGES C CXX ASM) 这行是分界线:
-
之前:只能做环境设定(版本、标准、工具链),CMake 还没检查编译器;
-
之后:CMake 已经确认编译器能干活,
add_executable等正式命令才能用。
参数解读:F103 是工程名(同时自动生成变量 ${PROJECT_NAME},全文都在用它);LANGUAGES C CXX ASM 声明用到三种语言——ASM 不是可选项,因为启动文件 startup_stm32f103x6.s 是汇编写的,不声明 ASM 语言它就没法编译。
另外两个前置设定:
-
cmake_minimum_required(VERSION 3.20):声明工程需要的 CMake 最低版本。版本太低会直接报错拒绝配置——这行必须放在最前面。 -
set(CMAKE_BUILD_TYPE Debug):构建类型。Debug 意味着带调试信息、不做优化,方便打断点单步调试。想要小体积的发布版一般用 Release(-Os优化),本工程为了调试体验固定为 Debug。
1.2 第一份文件:工具链文件
工具链文件只回答三个问题——用哪套编译器?目标是什么运行环境?编译链接加什么参数? 四段代码对应如下:
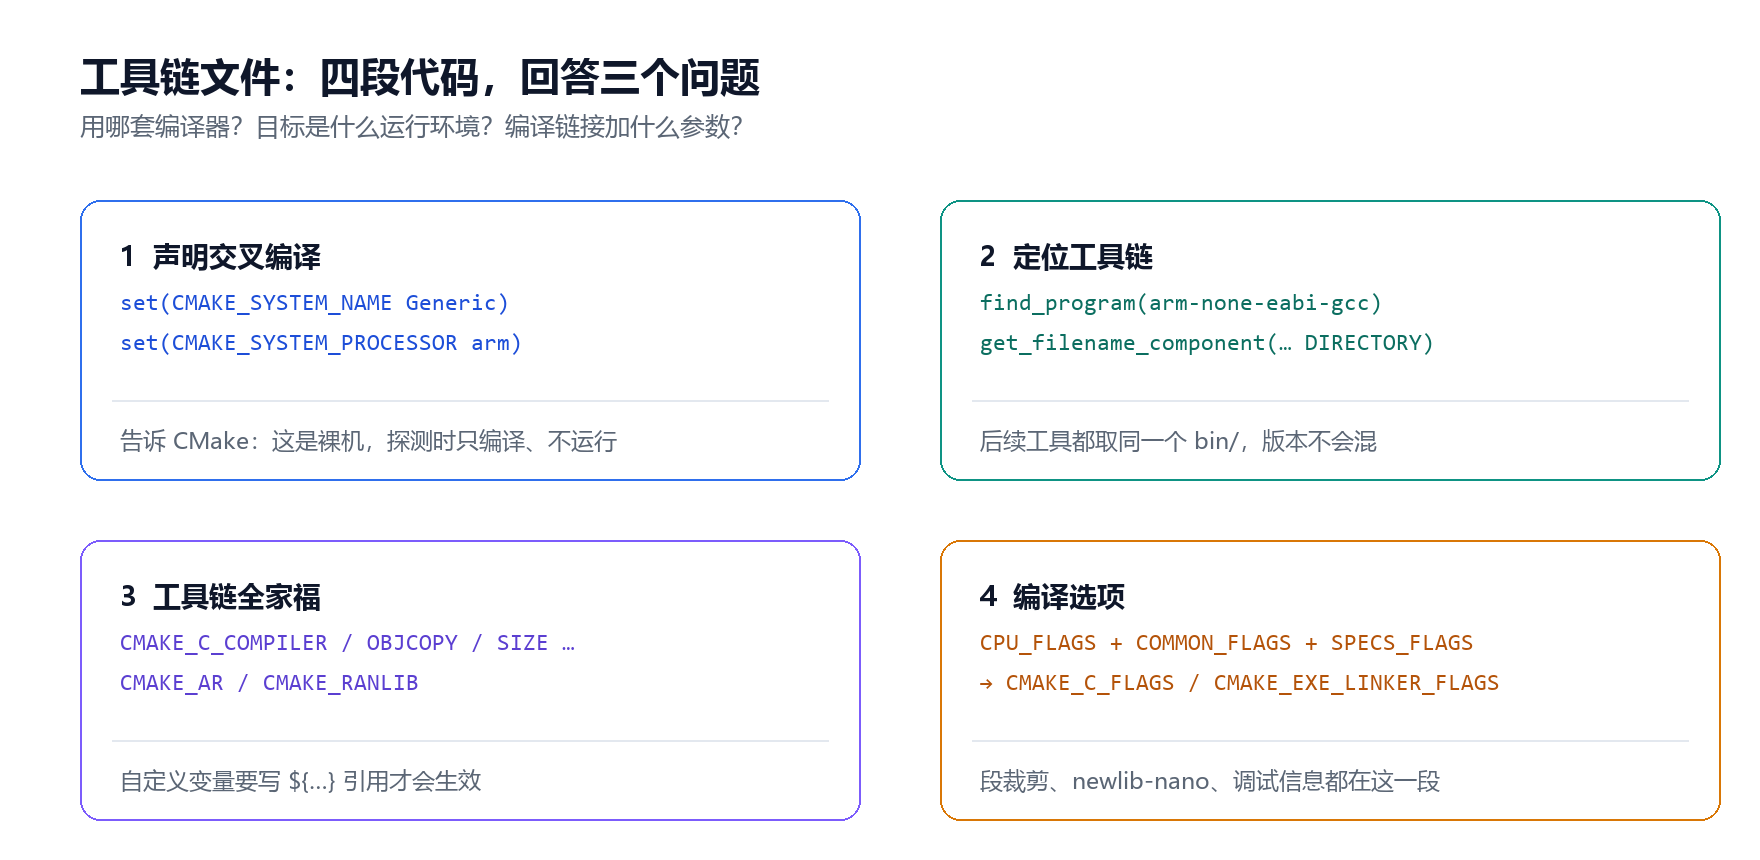
先补一句背景:什么叫交叉编译。 你的电脑是 x86,目标芯片是 ARM,在 x86 上编出 ARM 程序,这就叫交叉编译。所以工具链名字叫 arm-none-eabi-gcc:
-
arm:目标架构是 ARM; -
none-eabi:目标环境「无操作系统、嵌入式 ABI」(裸机); -
gcc:GCC 本尊。
① 声明「这是交叉编译」
set(CMAKE_SYSTEM_NAME Generic)
set(CMAKE_SYSTEM_PROCESSOR arm)
CMAKE_SYSTEM_NAME 设为 Generic 是裸机工程的标配,意思是「目标平台没有操作系统」。CMake 看到这个名字后知道两件事:
-
这是交叉编译(目标平台 ≠ 宿主机),
CMAKE_CROSSCOMPILING自动为真; -
编译出来的测试程序没法在 PC 上运行,所以编译器探测只编译、不运行。
为什么这一步重要:CMake 配置时会先探测编译器(编译一个小测试程序来判断编译器好不好使)。如果不声明
Generic,CMake 可能按「在 PC 上跑的普通程序」来探测和链接,裸机工程在这步就会翻车。
② 在 PATH 里找到工具链
find_program(COMPILER_ON_PATH arm-none-eabi-gcc)
if(COMPILER_ON_PATH)
get_filename_component(ARM_TOOLCHAIN_PATH ${COMPILER_ON_PATH} DIRECTORY)
message(STATUS "Using ARM GCC from path = ${ARM_TOOLCHAIN_PATH}")
else()
message(FATAL_ERROR "Unable to find ARM GCC. Add to your PATH")
endif()逻辑很直白:在系统 PATH 里找 arm-none-eabi-gcc;找到就取它所在的目录(工具链的 bin/ 目录);找不到就报错终止。
-
find_program(变量名 要找的程序):CMake 自带的「在 PATH 里找可执行文件」命令,结果存进第一个参数的变量里。 -
get_filename_component(... DIRECTORY):从完整路径里取目录部分。拿到bin/后,后面所有工具都从这里取——保证编译器、汇编器、链接器是同一套版本,不会出现用 A 家的 gcc 配 B 家的 objcopy 这种事。 -
message(FATAL_ERROR ...):打印消息并立刻终止配置。你会在这里得到本文第一个报错——它通常只意味着工具链没装好,或没进 PATH。
注意:这里故意写
arm-none-eabi-gcc而不是arm-none-eabi-gcc.exe——不带扩展名,Windows 上自动匹配.exe,Linux/macOS 上也能用,一份配置跨三个平台。
③ 工具链全家福
set(CMAKE_C_COMPILER   ${ARM_TOOLCHAIN_PATH}/arm-none-eabi-gcc.exe)
set(CMAKE_CXX_COMPILER ${ARM_TOOLCHAIN_PATH}/arm-none-eabi-g++.exe)
set(CMAKE_ASM_COMPILER ${ARM_TOOLCHAIN_PATH}/arm-none-eabi-gcc.exe)   # 汇编也用 gcc 驱动
...
set(CMAKE_OBJCOPY      ${ARM_TOOLCHAIN_PATH}/arm-none-eabi-objcopy.exe)
set(CMAKE_OBJDUMP      ${ARM_TOOLCHAIN_PATH}/arm-none-eabi-objdump.exe)
set(CMAKE_SIZE_UTIL    ${ARM_TOOLCHAIN_PATH}/arm-none-eabi-size.exe)
set(CMAKE_AR           ${ARM_TOOLCHAIN_PATH}/arm-none-eabi-gcc-ar.exe)
其中几个关键角色:
| 变量 | 作用 | 什么时候用到 |
|---|---|---|
CMAKE_C/CXX/ASM_COMPILER | 三种语言的编译器(汇编也用 gcc 驱动) | Ninja 每次编译都调用 |
CMAKE_LINKER | 链接器(本工程用 gcc 驱动 ld) | 链接阶段 |
CMAKE_CPP | C 预处理器 | 预处理阶段 |
CMAKE_OBJCOPY | 格式转换(ELF → hex/bin) | 第 2.3 节的 POST_BUILD 命令 |
CMAKE_OBJDUMP | 反汇编,生成 .dump/.lst | 排查问题时用 |
CMAKE_SIZE_UTIL | 查看 text/data/bss 占用 | 想知道固件多大时手动执行 |
CMAKE_AR / CMAKE_RANLIB | 打包静态库 / 为静态库建索引 | 本工程没用到静态库,先混个脸熟 |
一个容易忽略的区别:
CMAKE_C_COMPILER、CMAKE_AR这些是 CMake 官方变量,CMake 自己会用;而CMAKE_OBJCOPY、CMAKE_SIZE_UTIL属于工程自定义命名——CMake 不会主动使用,只有你在命令里写${CMAKE_OBJCOPY}它才生效。 所以这些名字理论上可以随便起,但保持CMAKE_前缀是好习惯。
④ 编译选项:裸机工程的灵魂参数
这是工具链文件里信息量最大的部分,逐组看。
CPU 相关(告诉编译器为谁生成代码):
set(CPU_FLAGS "-mthumb -mcpu=cortex-m3")-
-mcpu=cortex-m3:按 Cortex-M3 的指令集和特性生成代码; -
-mthumb:使用 Thumb 指令集(Cortex-M3 只支持 Thumb,代码密度高)。
段裁剪组合拳(省 Flash 的关键,第 2.2 节细讲):
set(COMMON_FLAGS "-ffunction-sections -fdata-sections ...")
set(CMAKE_EXE_LINKER_FLAGS "-Wl,--gc-sections ...")
C 库选择(newlib 精简版):
set(SPECS_FLAGS "--specs=nosys.specs --specs=nano.specs")-
nano.specs:用 newlib-nano,精简版 C 库,printf这类庞然大物能小一半以上; -
nosys.specs:newlib 里有些函数(_write、_sbrk等)默认假设「有操作系统」,裸机上没有,这个选项提供一套空实现,让链接能通过。
其余参数一览(知道有这回事即可):
| 参数 | 作用 |
|---|---|
-Wall | 打开常用警告 |
-Wdouble-promotion | float 被隐式提升为 double 时告警——M3 没有 FPU,双精度运算全靠软件模拟,很慢 |
-Wno-sign-compare | 关闭有符号 / 无符号比较的警告 |
-Wno-psabi | 关闭 GCC 的 ABI 变化提示(ARM GCC 下常见的刷屏信息) |
-g3 -ggdb3 | 生成最全的调试信息(含宏定义),供 GDB / Ozone / VSCode 等调试器使用 |
-x assembler-with-cpp(汇编用) | 让 .S 启动文件先经过预处理器,汇编里就能写 #include / #define |
-fno-rtti -fno-exceptions -fno-threadsafe-statics(C++ 用) | 关闭运行时类型信息、异常机制与局部静态变量的线程安全初始化,省空间 |
-Wl,--no-warn-rwx-segments | 关闭新版 binutils 对「可读可写可执行段」的警告(嵌入式常态,无需理会) |
-Wl,--print-memory-usage | 链接完成后自动打印 Flash / RAM 的实际占用 |
最后组装:
set(CMAKE_C_FLAGS   "${CPU_FLAGS} ${COMMON_FLAGS} ${SPECS_FLAGS}")
set(CMAKE_CXX_FLAGS "${CPU_FLAGS} ${COMMON_FLAGS} ${SPECS_FLAGS} ${CXX_FLAGS}")
set(CMAKE_ASM_FLAGS "${CPU_FLAGS} ${SPECS_FLAGS} -x assembler-with-cpp")
CMAKE_C_FLAGS 等是 CMake 官方认的变量,编译每个 .c 时都会带上里面的内容。${...} 是 CMake 的变量取值语法,把前面定义的几个变量拼成最终参数串。
⑤ 它什么时候生效:全文第一大坑
工具链文件不是自己单独跑的,它由顶层 CMakeLists.txt 引入:
set(CMAKE_TOOLCHAIN_FILE "${CMAKE_SOURCE_DIR}/cmake/cortex_m3.cmake")🕳️ 全文第一大坑:这行
set必须出现在project()之前。因为
project()才是 CMake 真正开始探测编译器的时刻。如果把工具链文件的引入写在project()之后,CMake 会先按「宿主机普通程序」用 MSVC/MinGW 做一轮探测,然后你的交叉编译配置和探测结果打架,报出各种诡异错误。一句话规则:工具链配置永远在
project()之前。
1.3 空目标与两个挂载命令
add_executable 大家都不陌生,但本工程的写法有点特别:
add_executable(${PROJECT_NAME})眼熟又陌生?教程里通常写 add_executable(demo main.c),把源文件一次列全。这里一个源文件都没给——因为源文件分散在 app、driver、HAL 三层,每层自己往这个目标上补充(1.4 节)。这就是本工程的核心构建模式,先记住结论:
顶层开一个空目标,所有子目录都往这一个目标上挂东西。
那么「挂」这个动作,靠的就是两个命令:
target_include_directories(${PROJECT_NAME} PRIVATE
"${CMAKE_SOURCE_DIR}/third_party/arm/cmsis-core/Include"
)
target_sources(${PROJECT_NAME} PRIVATE
"${CMAKE_SOURCE_DIR}/third_party/arm/cmsis-compiler/source/gcc/retarget_syscalls.c"
)-
target_include_directories(目标 PRIVATE 目录...):给目标加头文件搜索路径,相当于手工编译时的-I目录; -
target_sources(目标 PRIVATE 文件...):给目标追加源文件。
PRIVATE 是作用域限定词,意思是「只对本目标生效,不传递给其他目标」。你会在本工程里看到所有命令都写 PRIVATE——因为所有东西都挂在同一个目标上,没有「传递给谁」的问题。等你在第 5 节见到「每层一个静态库」的写法后,PUBLIC / INTERFACE 才会真正登场。
顺带解释一下那个 retarget_syscalls.c 是干嘛的:newlib 的 printf、malloc 底层依赖 _write、_sbrk 等系统调用,裸机上没人提供它们,链接时会报 undefined reference to _write。这个文件就是这些系统调用的桩实现——先知道它是「让 C 库函数在裸机上活下来」的补丁即可。
1.4 各层报到:一个 target,四个 CMakeLists
顶层里有三行「召集令」:
add_subdirectory(src/app)
add_subdirectory(src/driver)
add_subdirectory(third_party/st/STM32F1xx_HAL_Driver)
add_subdirectory(目录) 的行为:进入该目录,执行它里面的 CMakeLists.txt,然后回来继续。注意这三行位于 add_executable 之后——子目录要往目标上挂东西,目标得先存在。
先看四个文件分别往里写了什么:
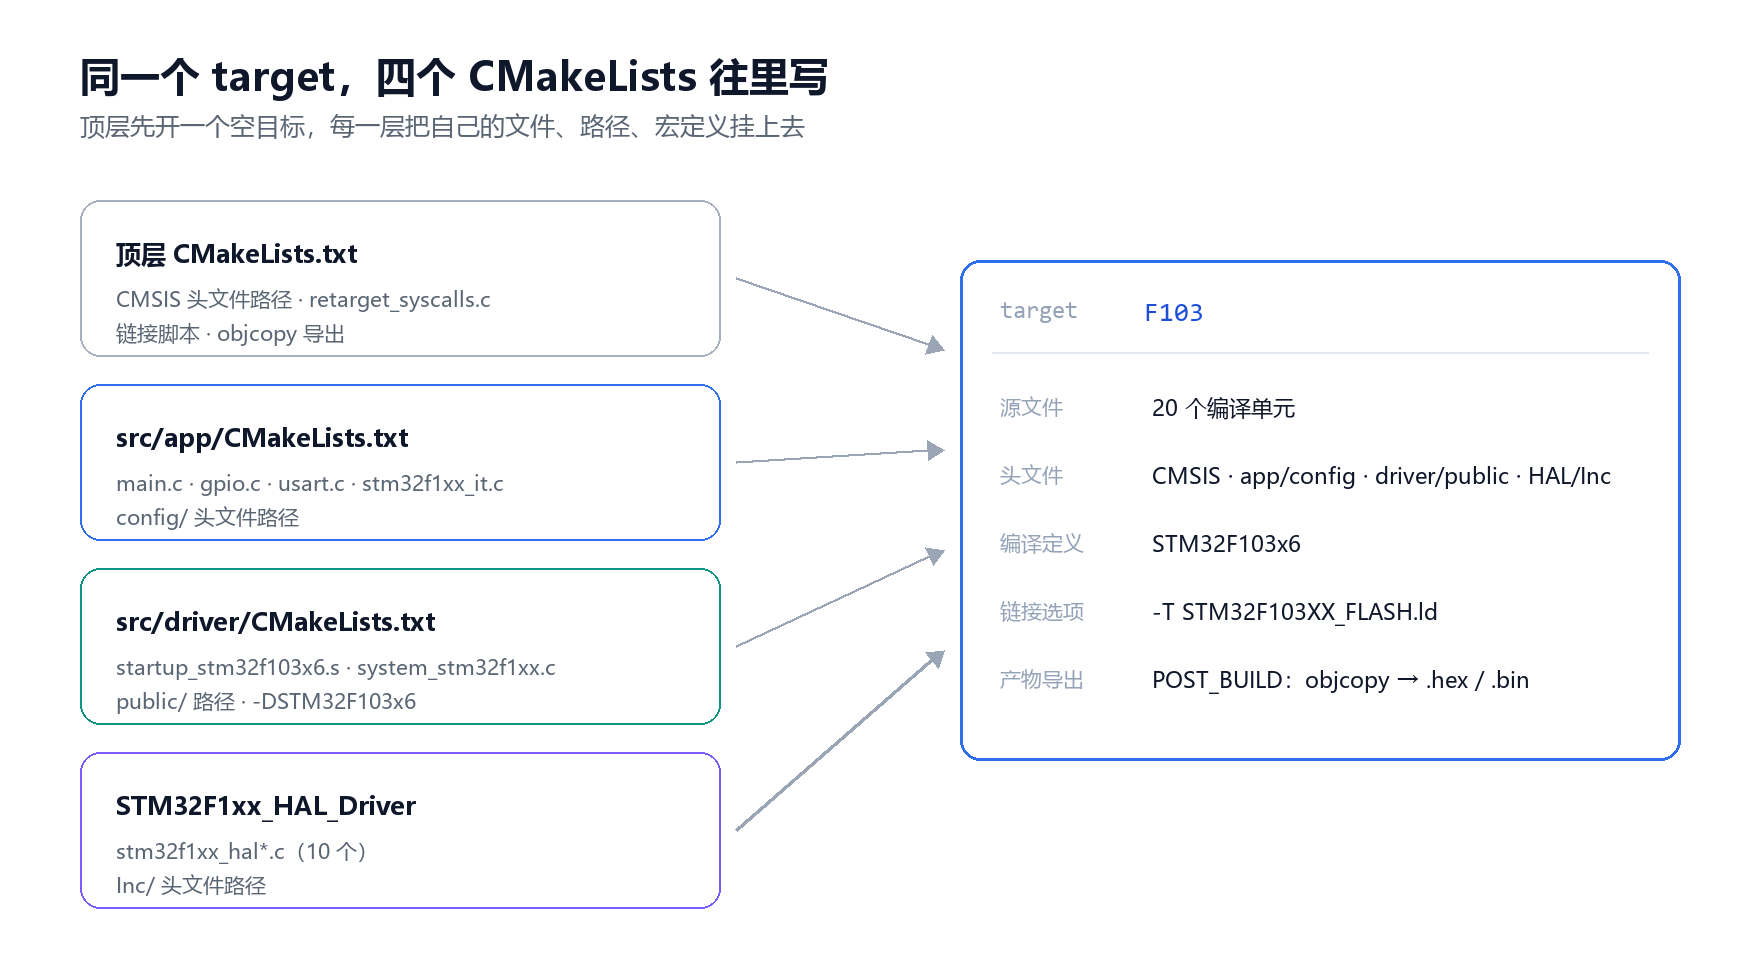
三个子文件全文(都很短),你会发现一个共同点:
src/app/CMakeLists.txt
target_include_directories(${PROJECT_NAME} PRIVATE
"${CMAKE_CURRENT_LIST_DIR}/config"
)
target_sources(${PROJECT_NAME} PRIVATE
"${CMAKE_CURRENT_LIST_DIR}/main.c"
"${CMAKE_CURRENT_LIST_DIR}/config/gpio.c"
"${CMAKE_CURRENT_LIST_DIR}/config/usart.c"
"${CMAKE_CURRENT_LIST_DIR}/config/stm32f1xx_it.c"
)src/driver/CMakeLists.txt
target_compile_definitions(${PROJECT_NAME} PRIVATE STM32F103x6)
target_include_directories(${PROJECT_NAME} PRIVATE
"${CMAKE_CURRENT_LIST_DIR}/public"
)
target_sources(${PROJECT_NAME} PRIVATE
"${CMAKE_CURRENT_LIST_DIR}/sdk_init.c"
"${CMAKE_CURRENT_LIST_DIR}/startup_stm32f103x6.s" ← 启动文件在这
"${CMAKE_CURRENT_LIST_DIR}/system_stm32f1xx.c"
)third_party/st/STM32F1xx_HAL_Driver/CMakeLists.txt
target_sources(${PROJECT_NAME} PRIVATE
${CMAKE_CURRENT_SOURCE_DIR}/Src/stm32f1xx_hal.c
${CMAKE_CURRENT_SOURCE_DIR}/Src/stm32f1xx_hal_cortex.c
${CMAKE_CURRENT_SOURCE_DIR}/Src/stm32f1xx_hal_rcc.c
${CMAKE_CURRENT_SOURCE_DIR}/Src/stm32f1xx_hal_gpio.c
${CMAKE_CURRENT_SOURCE_DIR}/Src/stm32f1xx_hal_uart.c
# stm32f1xx_hal_tim.c ... 用到哪个外设,取消对应注释
)
target_include_directories(${PROJECT_NAME} PRIVATE
${CMAKE_CURRENT_SOURCE_DIR}/Inc
...
)共同点:三个文件都在操作同一个 ${PROJECT_NAME}。这就是 1.3 节说的核心模式——
核心模式:顶层开一个空书架(空目标),每个车间把自己的书(源文件、头文件路径、宏定义)放上去。最终书架上是什么样,固件就是什么样。
1.5 三个容易踩的坑
坑一:宏定义决定 HAL 认不认得这块芯片。
target_compile_definitions(${PROJECT_NAME} PRIVATE STM32F103x6)这行等价于给每个编译单元加了 -DSTM32F103x6。它的作用链路:
cmake: target_compile_definitions(STM32F103x6)
  ↓
编译器给预处理器的命令行:-DSTM32F103x6
  ↓
stm32f1xx.h 预处理时:
   第 62 行"全都没定义?" → 假(STM32F103x6 已定义)→ 不报错
   第 108 行逐条 #elif → 命中 #elif defined(STM32F103x6)
  ↓
#include "stm32f103x6.h"  ← 才是真正描述芯片的文件
没这个宏,HAL 连芯片型号都不知道,直接编译报错。 顺着这条链路,头文件的包含关系一路展开:
main.c
 └─ #include "main.h"
     └─ #include "stm32f1xx_hal.h" …………………………… [HAL/Inc]
         └─ #include "stm32f1xx_hal_conf.h" …………… [src/app/config]   ← 你的配置单
             └─ #ifdef HAL_GPIO_MODULE_ENABLED
                 #include "stm32f1xx_hal_gpio.h" …… [HAL/Inc]         ← 模块开关过滤
                     └─ #include "stm32f1xx_hal_def.h" [HAL/Inc]
                         └─ #include "stm32f1xx.h" …… [src/driver/public] ← 家族路由表
                             └─ #elif defined(STM32F103x6)   ←★ 由 -DSTM32F103x6 命中
                                 #include "stm32f103x6.h" … [src/driver/public] ← 芯片描述
                                     └─ #include "core_cm3.h" … [cmsis-core/Include] ← 内核
                                         ├─ #include "cmsis_version.h"
                                         └─ #include "cmsis_compiler.h" [cmsis-compiler/include]
                                             └─ #include "cmsis_gcc.h"  [cmsis-compiler/include/gcc]
坑二:子目录里的路径不要硬拼。
顶层可以用 ${CMAKE_SOURCE_DIR},但子目录里推荐用 CMAKE_CURRENT_LIST_DIR——它的值是当前这个 CMakeLists.txt 所在的目录,于是整个文件不依赖任何外部路径,整个目录挪到哪都能用。
永远用
CMAKE_CURRENT_LIST_DIR(或CMAKE_CURRENT_SOURCE_DIR,两者在常规场景下等价,HAL 那份用的就是后者)拼出当前目录,再拼相对子路径。不要写../开头的裸相对路径——相对路径是相对构建目录解析的,行为和直觉不符,是新手常见的诡异错误来源。
坑三:HAL 要改两处,而且必须同步。
HAL 库的 CMakeLists.txt 里一半是注释:
    ${CMAKE_CURRENT_SOURCE_DIR}/Src/stm32f1xx_hal_uart.c
    # ${CMAKE_CURRENT_SOURCE_DIR}/Src/stm32f1xx_hal_i2c.c
    # ${CMAKE_CURRENT_SOURCE_DIR}/Src/stm32f1xx_hal_spi.c
HAL 的每个外设驱动是独立的 .c,用不用由你决定。但「是否启用某外设」有两个地方要改:CMake 里的源文件列表,和配置头 stm32f1xx_hal_conf.h(一堆 #define HAL_UART_MODULE_ENABLED 式开关)。两处必须一致:
-
配置开了、源文件没编进来 → 链接报
undefined reference to HAL_xxx; -
配置关了、源文件编进来了 → 浪费 Flash(好在不报错)。
到这里配置阶段就结束了,build.ninja 落地。
2. 构建阶段:Ninja 按施工图干活
cmake --build build 之后,才是真正产生机器码的阶段。
2.1 20 个编译单元 + 1 次链接
实测日志显示,这个工程一共 20 个编译单元,最后链接 1 次:
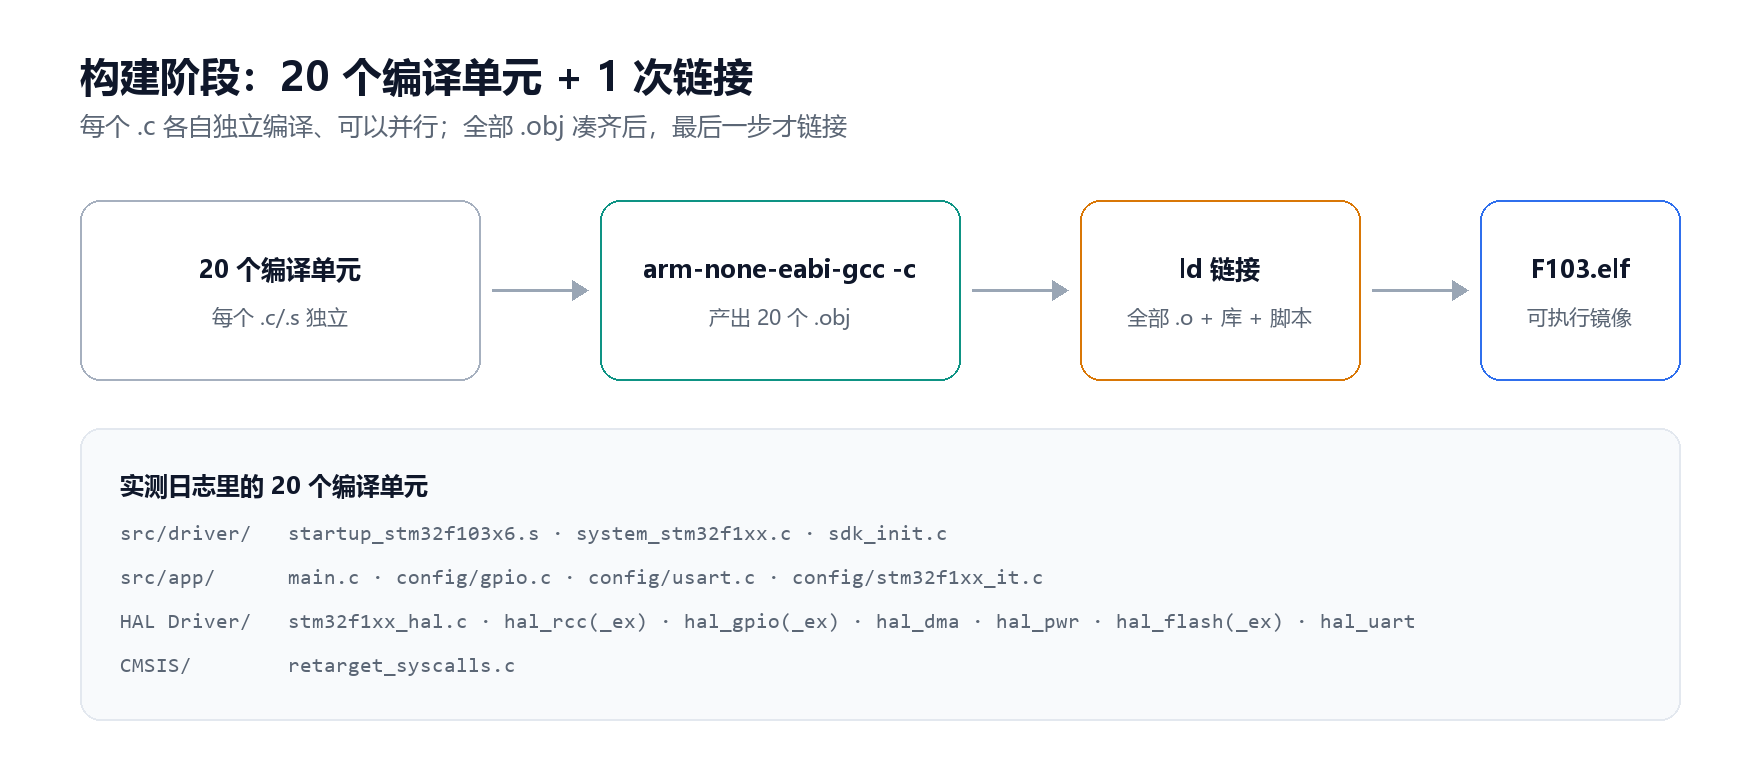
单个 .c 走的是经典四阶段——预处理 → 编译 → 汇编 → 链接;放到工程尺度上,前三个阶段是「每个 .c 各自独立跑」的,互不影响所以可以并行;只有链接是全局的、必须等所有 .obj 凑齐。
这也是为什么改一个 main.c 只重编一个文件、再链接一次,而不是全部重来。
2.2 分箱与扔箱:省 Flash 的关键
上面只讲了流程,但决定固件大小的是编译选项里那对「组合拳」:
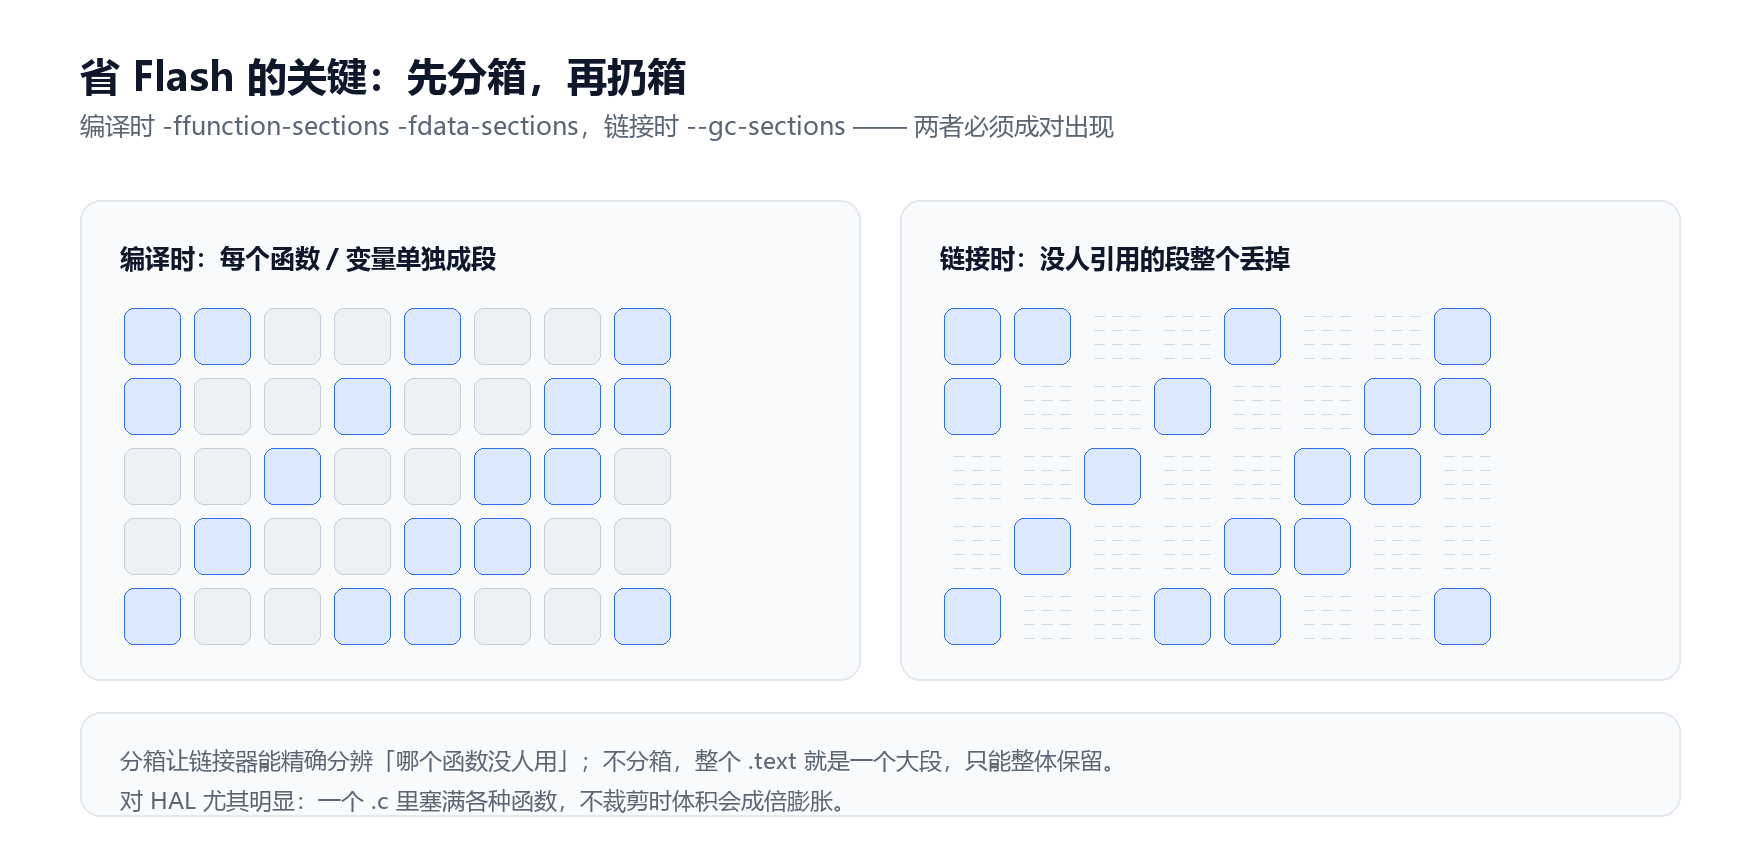
原理就两步:
编译时  -ffunction-sections -fdata-sections
        → 每个函数、每个全局变量各装一个"独立小箱子"(独立的段)

链接时  --gc-sections
        → 从入口点出发做可达性分析,没人引用的箱子整个扔掉
两者必须成对出现:编译时不分箱,链接时就没法精确扔。这一套对 HAL 库尤其重要——HAL 一个 .c 里塞满各种函数,不裁剪的话体积会成倍膨胀。
2.3 最后一锤:地址和格式
链接阶段干两件事:把段放到正确的地址上,然后把 ELF 转成能烧的格式。
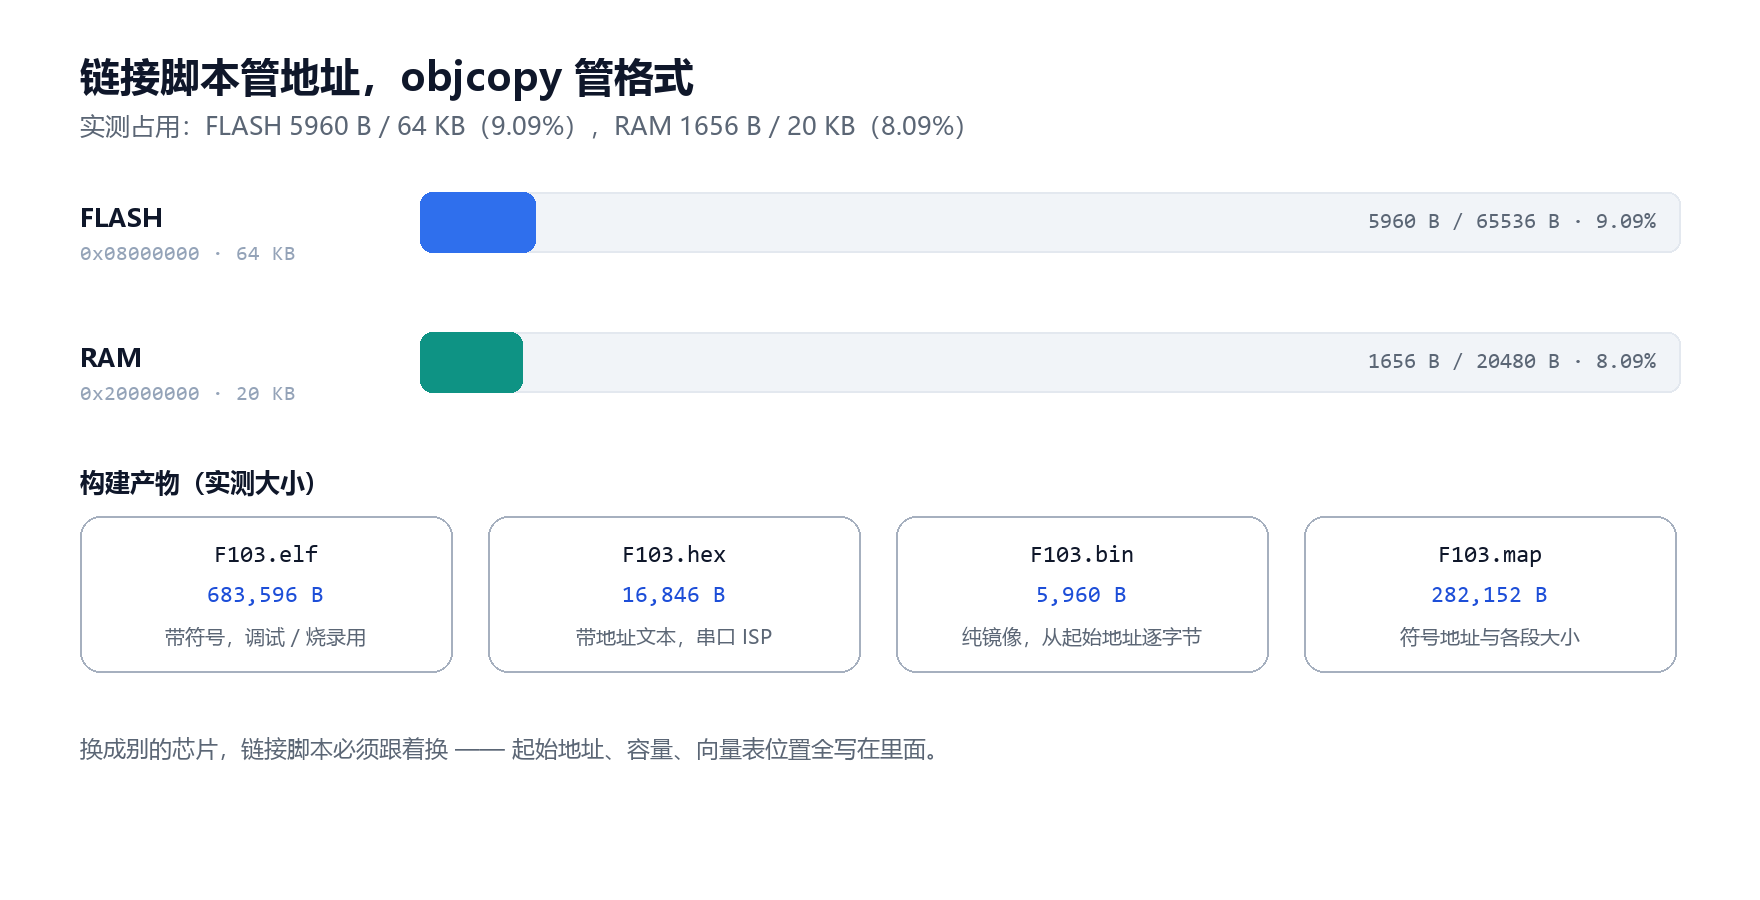
链接脚本是固件的地基图纸。 STM32F103XX_FLASH.ld 告诉链接器:Flash 从 0x08000000 开始、RAM 从 0x20000000 开始、中断向量表放哪、各段怎么排。没有它,链接器不知道该把代码安排到什么地址。换芯片时链接脚本必须跟着换。
链接选项里两个参数:
target_link_options(${PROJECT_NAME} PRIVATE
    -T${CMAKE_SOURCE_DIR}/STM32F103XX_FLASH.ld
    -Wl,-Map=${PROJECT_NAME}.map
)
-Wl, 前缀表示「把后面的参数透传给底层链接器 ld」:
-
-T...:指定链接脚本; -
-Wl,-Map=F103.map:生成 map 文件,记录每个符号最终落在哪个地址、每个段多大——分析内存占用、排查「固件怎么突然大了 20 KB」时的第一手资料。
objcopy 负责格式转换,在链接完成后自动触发:
add_custom_command(TARGET ${PROJECT_NAME} POST_BUILD
    COMMAND ${CMAKE_OBJCOPY} -Oihex   ${PROJECT_NAME}.elf ${PROJECT_NAME}.hex
    COMMAND ${CMAKE_OBJCOPY} -Obinary ${PROJECT_NAME}.elf ${PROJECT_NAME}.bin
)
add_custom_command(TARGET ... POST_BUILD) 的意思是「这个目标每次链接完成后,自动追加执行以下命令」。构建成功后,build/ 目录里的产物:
F103.elf   带符号和调试信息的完整镜像(调试、烧录都用它)
F103.hex   带地址信息的文本格式(串口 ISP / IAP 场景常用)
F103.bin   纯二进制镜像(从 0x08000000 开始逐字节就是它)
F103.map   内存占用地图(符号地址与各段大小)
3. 把上面的流程真跑一遍
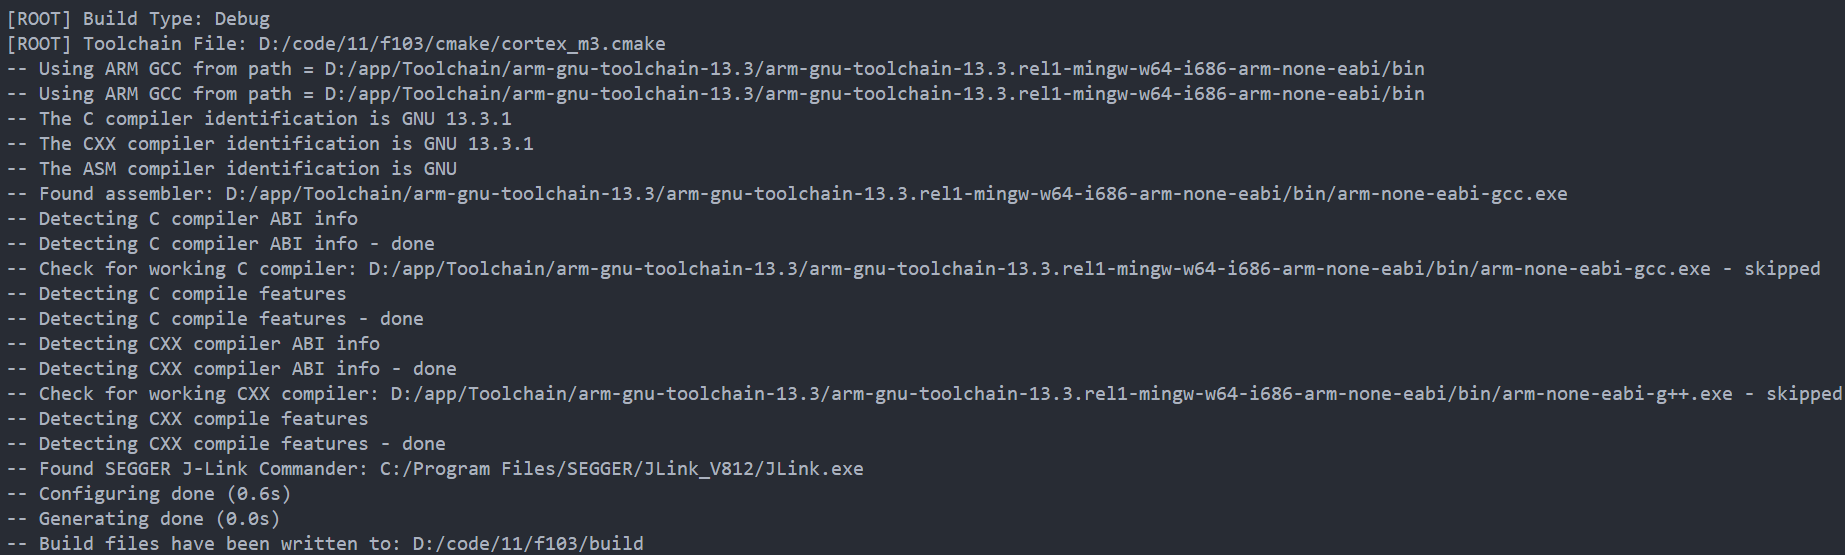
前面两张终端图,是把工程从零配置、编译的真实输出。
配置阶段——注意 Using ARM GCC from path 这一行,它正是工具链文件里那个 message(STATUS ...) 打出来的;最后 CMake 还会顺手探测一下 J-Link:
构建阶段——20 个编译任务排队执行,最后一行是链接。链接完成后,工具链文件里设的 --print-memory-usage 自动把 Flash/RAM 占用打了出来:
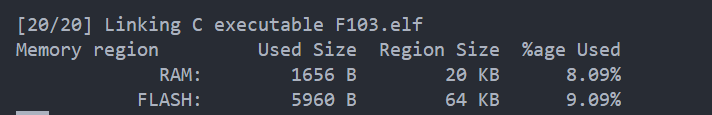
实测数据:FLASH 5960 B / 64 KB(9.09%),RAM 1656 B / 20 KB(8.09%)。一个带 UART、GPIO、printf 重定向的裸机工程,不到 6 KB——这就是 --gc-sections 加 newlib-nano 的功劳。
arm-none-eabi-size 的视角再看一眼(text + data + bss):
   text    data     bss     dec     hex   filename
   5948      12    1644    7604    1db4   F103.elf
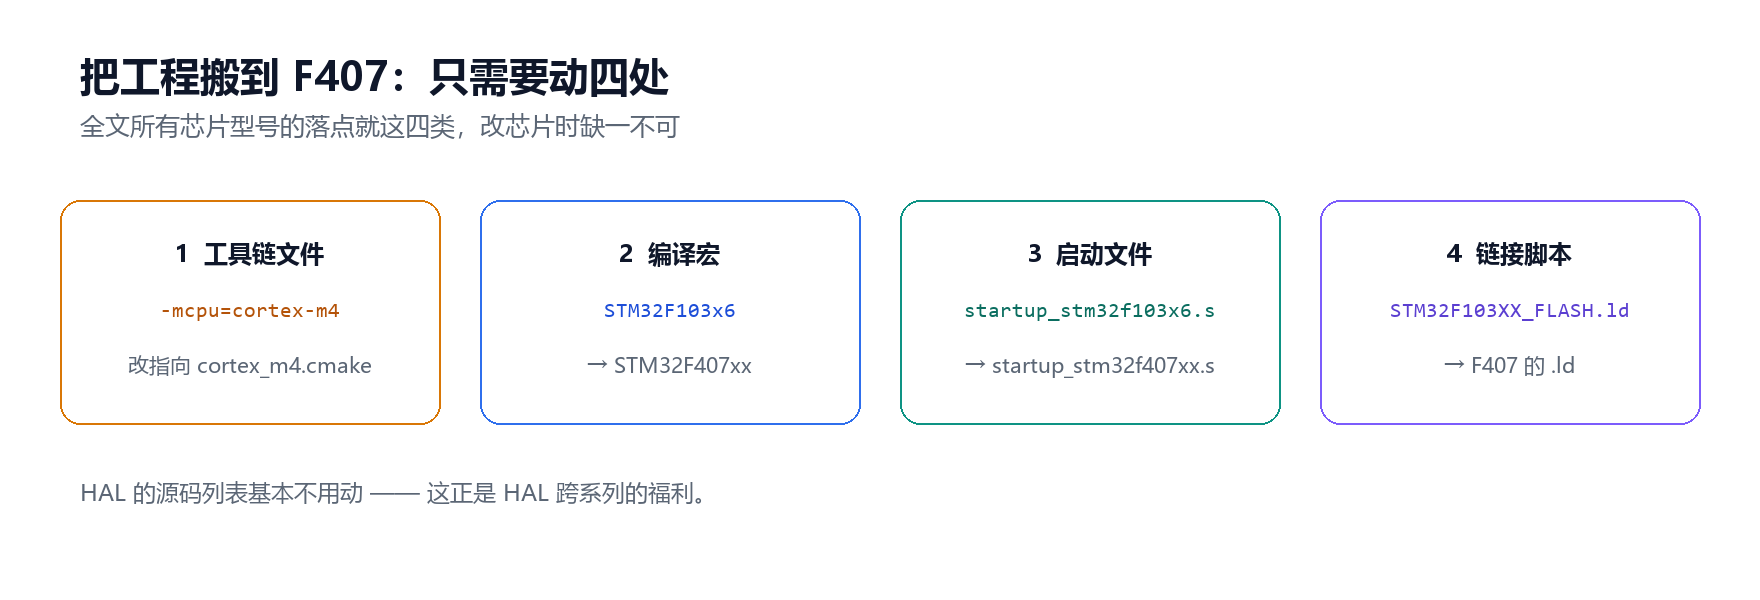
4. 换芯片要动哪几处
最后一个问题:如果这块板子换成 STM32F407,要改什么?
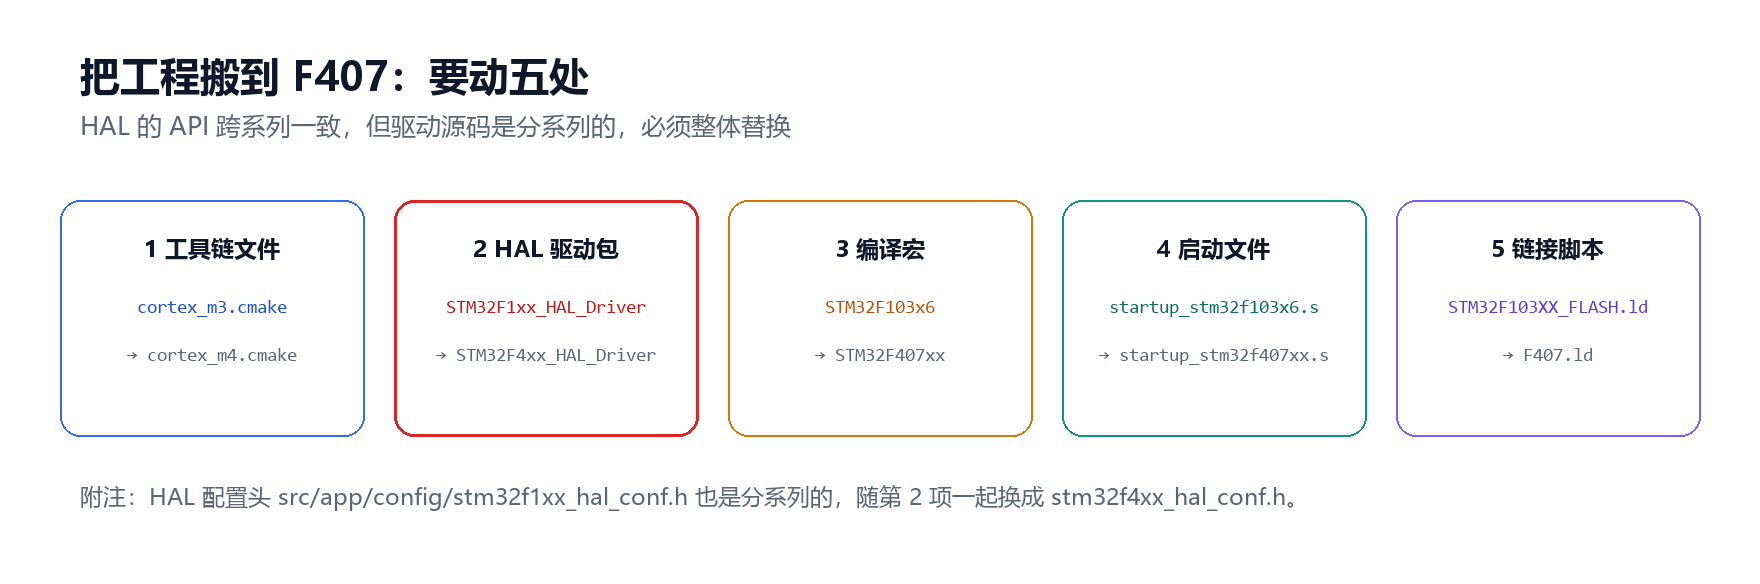
五处,缺一不可:
| 换点 | 位置 | 现值 → 目标值 |
|---|---|---|
| 工具链文件 | cmake/ + 顶层 CMAKE_TOOLCHAIN_FILE | cortex_m3.cmake → cortex_m4.cmake |
| HAL 驱动包 | third_party/st/ + 顶层 add_subdirectory + HAL 配置头 src/app/config/ | STM32F1xx_HAL_Driver → STM32F4xx_HAL_Driver(源码列表换 stm32f4xx_hal_*.c);stm32f1xx_hal_conf.h → stm32f4xx_hal_conf.h |
| 编译宏 | driver 层 target_compile_definitions | STM32F103x6 → STM32F407xx |
| 启动文件 / system | driver 层 target_sources | startup_stm32f103x6.s → startup_stm32f407xx.s;system_stm32f1xx.c → system_stm32f4xx.c |
| 链接脚本 | 顶层 target_link_options | STM32F103XX_FLASH.ld → F407 的 .ld |
5. 两个常见问题
Q1:为什么所有命令都写 PRIVATE?
PRIVATE 的意思是「只对本目标生效,不传递给其他目标」。本工程所有东西都挂在同一个目标上,压根没有「传递」这回事,所以全 PRIVATE 没毛病。它的反义是 PUBLIC(传递给「链接我的目标」)和 INTERFACE(自己不用、只传递)——要到下面这种写法里才会登场。
Q2:每层建静态库和现在这种写法,怎么选?
本工程「全层共建一个目标」并不是唯一流派。另一种常见写法是每层建静态库,最后链接到一起:
# src/driver/CMakeLists.txt(另一种流派,本工程未采用)
add_library(driver STATIC sdk_init.c startup_stm32f103x6.s ...)
target_include_directories(driver PUBLIC public)
target_compile_definitions(driver PUBLIC STM32F103x6)

# 顶层
target_link_libraries(F103 PRIVATE driver hal app)
两种流派对比:
| 对比项 | 单目标共建(本工程) | 静态库分层 |
|---|---|---|
| 需要的命令 | 只需 target_sources / target_include_directories 等几个命令 | 多了 add_library、target_link_libraries、依赖传递 |
| 适用场景 | 单固件工程、结构简单,对初学者友好 | 代码要在多个工程间复用、模块边界清晰的中大型项目 |
PRIVATE / PUBLIC | 全写 PRIVATE 即可 | PUBLIC / INTERFACE 真正发挥作用:库的公开头文件路径会自动传递给链接它的目标 |
收尾
把整条链路压成一句话:
CMake 在配置阶段把散落在各子目录的源文件汇总进一个 target,翻译成
build.ninja;Ninja 在构建阶段按依赖图逐个调 gcc 编译出.o,最后链接成.elf和.map,objcopy 再转出.bin/.hex,全部落在build文件夹里。
换个角度看,整个过程就是往同一张清单上不断追加内容:
整个工程 = 1 个目标 F103 + 1 张属性清单(INCLUDES、源文件列表、FLAGS...)

顶层 CMakeLists      → 往清单上写:CMSIS路径、retarget、链接脚本...(写几条后喊 add_subdirectory)
src/app  CMakeLists  → 收到"继续写"指令,往清单上写:main.c、gpio.c...
src/driver CMakeLists→ 再写:startup.s、system_stm32f1xx.c...
HAL  CMakeLists      → 再写:hal_xxx.c、HAL/Inc...

最后 ninja 拿着这张【合并后的完整清单】,编译 F103 的每一个 .c
三个文件的角色再对照一遍:
| 文件 | 一句话角色 |
|---|---|
工具链文件 cmake/cortex_m3.cmake | 用什么锤子——编译器、目标 CPU、编译链接参数(第 1.2 节) |
顶层 CMakeLists.txt | 造什么产品——目标、链接脚本、产物导出(第 1.1 / 1.3 / 2.3 节) |
各子目录 CMakeLists.txt | 每个车间交什么货——各自的源文件、头文件路径、宏定义(第 1.4 / 1.5 节) |
想继续深入,可以看 CMake 官方的 CMake Tutorial;工程里备好的 cortex_m4.cmake / cortex_m7.cmake,可以直接拿来练手换芯片。
智能硬件社区聚焦AI智能硬件技术生态,汇聚嵌入式AI、物联网硬件开发者,打造交流分享平台,同步全国赛事资讯、开展 OPC 核心人才招募,助力技术落地与开发者成长。
更多推荐
 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)