LlamaIndex 系列【33】响应合成器(Response Synthesizer)
文章目录
1. 概述
响应合成器(Response Synthesizer) 接收用户查询和一组文本块,调用大语言模型(LLM)生成回答。
在 RAG 链路里,检索器拿到相关文档片段 (Node) 之后,把【用户问题 + 检索出来的多段文本】交给大模型,组织、合并、生成最终回答的这一整套逻辑,就叫响应合成。
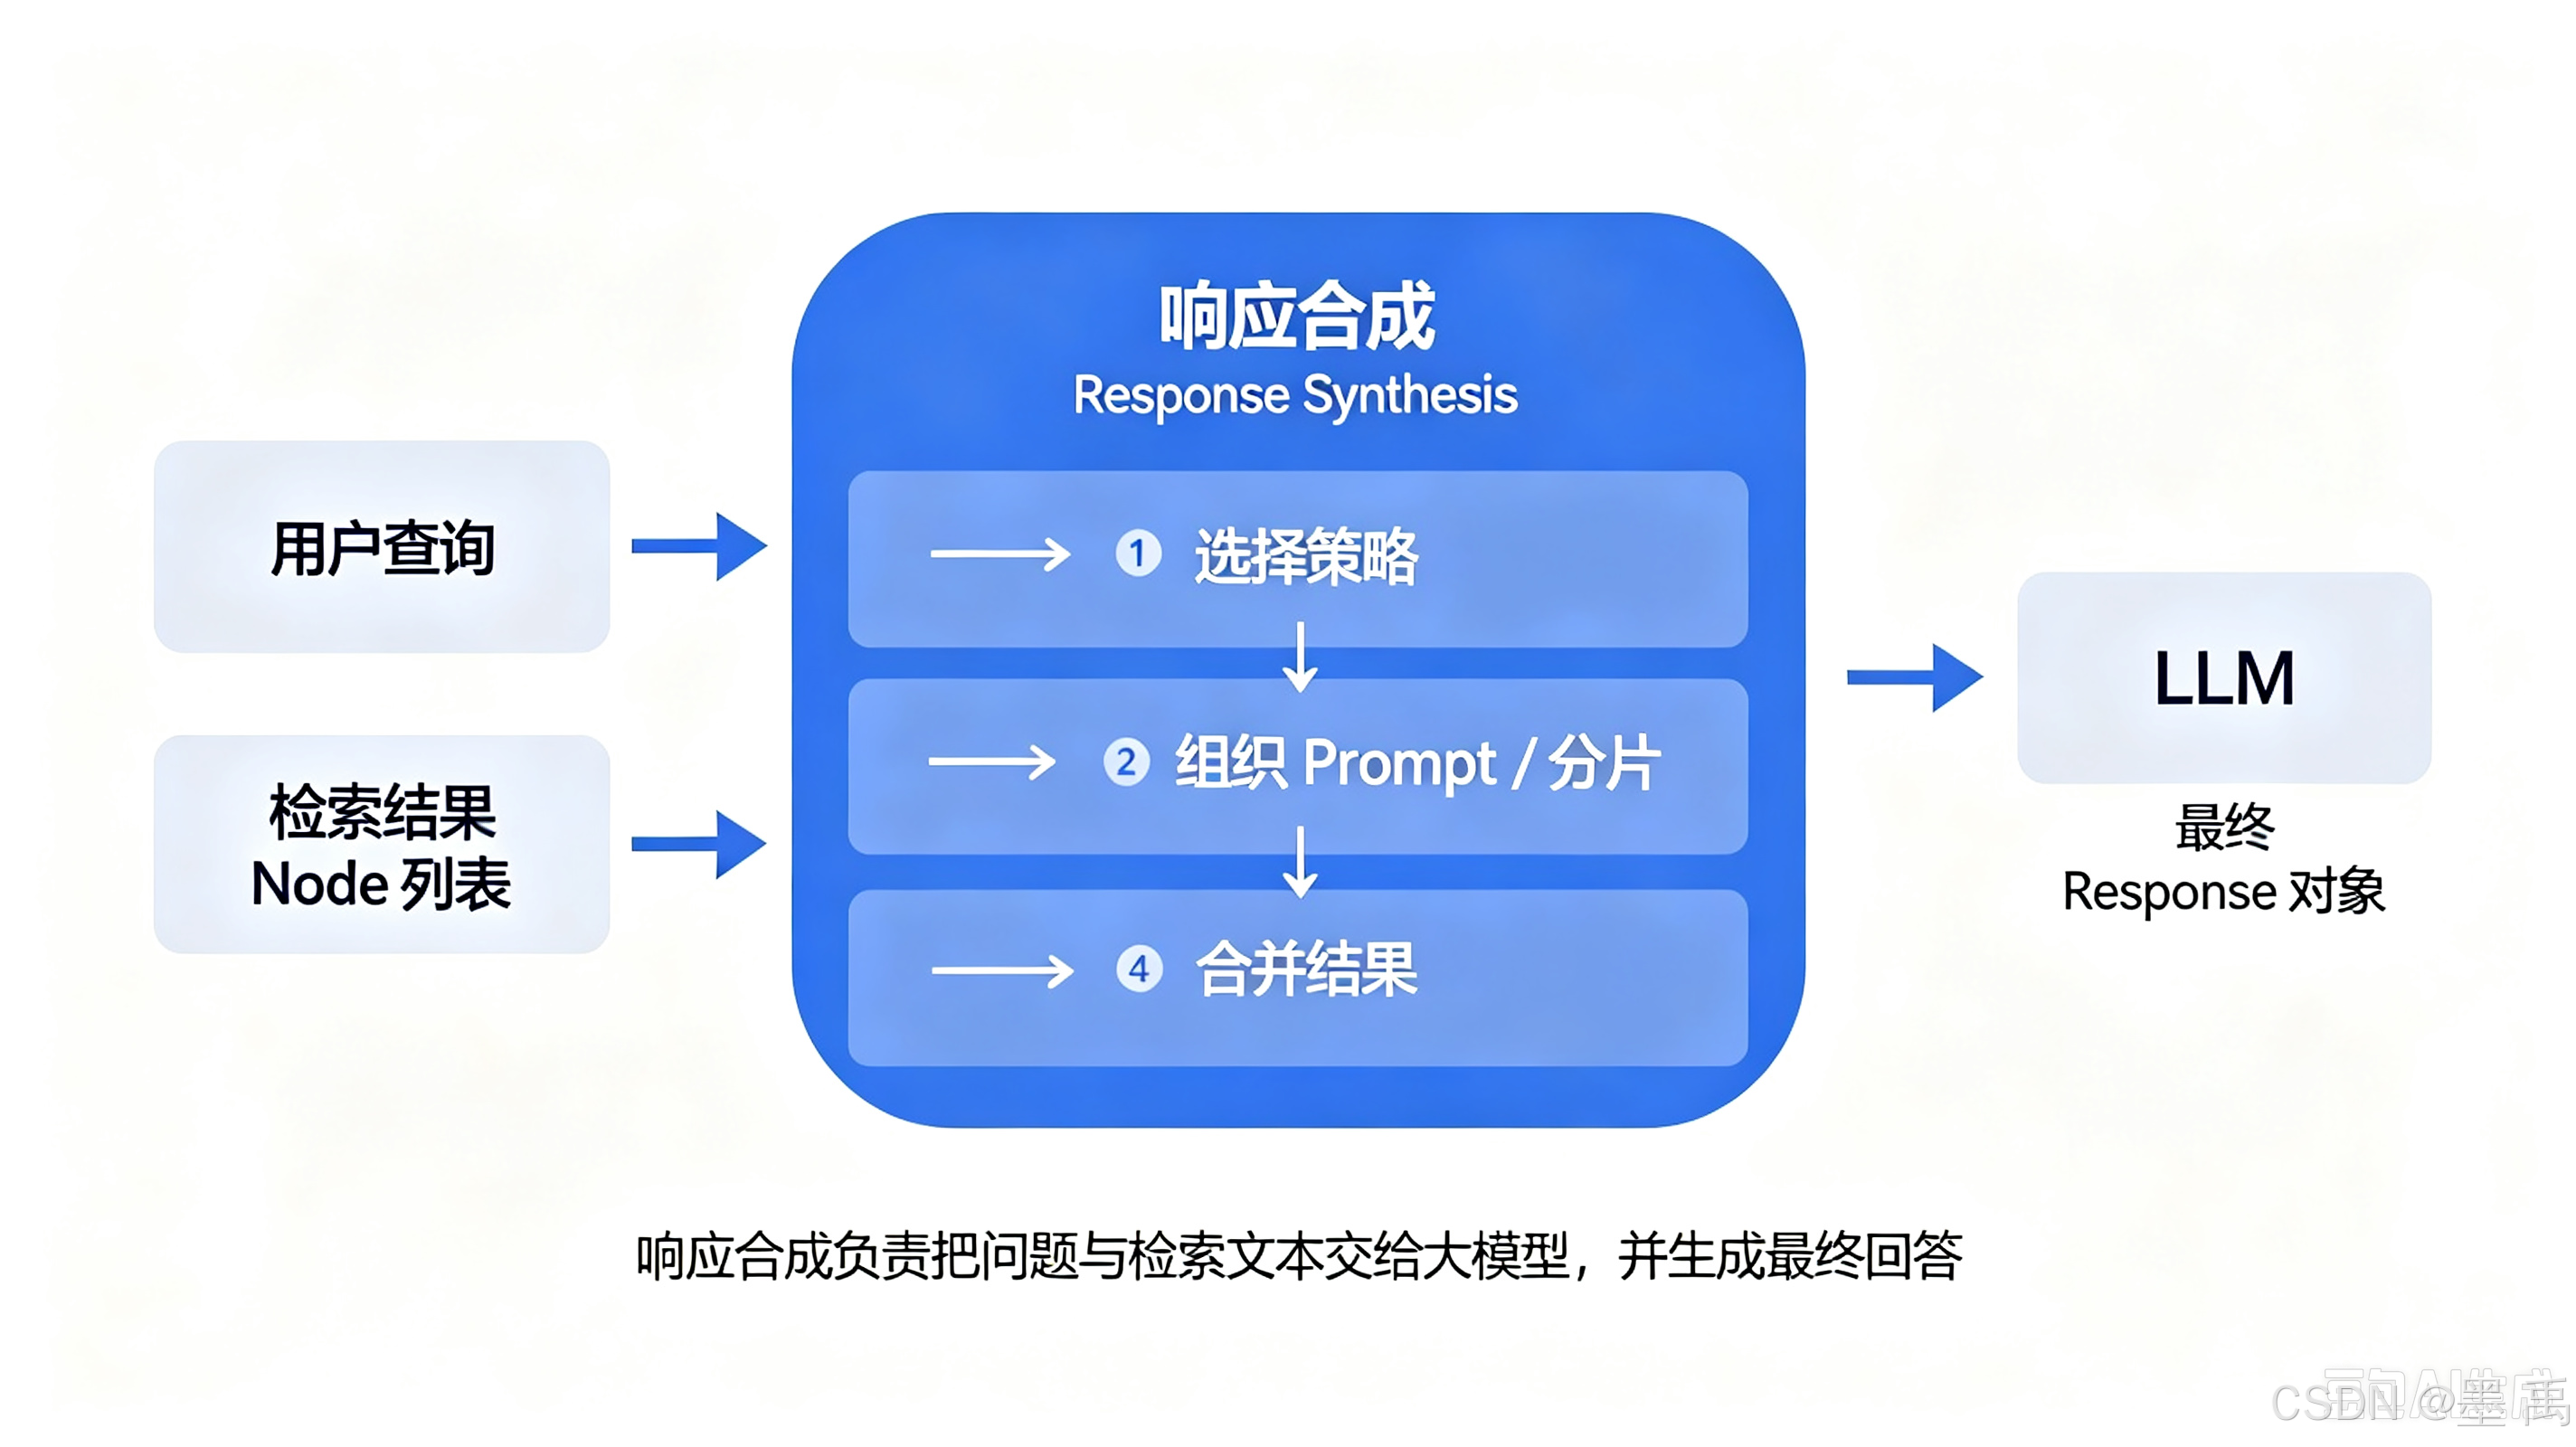
在 RAG 完整链路中的位置:
用户提问
    ↓
检索器 Retriever(从向量库取出相关文本块)
    ↓
节点后处理器(重排 / 过滤)
    ↓
响应合成
    ↓
最终答案
检索只负责找资料,响应合成负责把找到的资料 + 问题,交给
LLM写成通顺答案。
2. 内置合成器
生成回答的实现方式有很多种:简单的可以是遍历文本块,复杂的可以构建树形结构。
LlamaIndex 内置多种合成器:
| 合成器 | 是否调用LLM | 执行模式 | 信息融合 | 核心优势 | 局限 |
|---|---|---|---|---|---|
| ContextOnly | ❌ | 直接拼接原文 | 无 | 速度最快,零LLM开销 | 无法生成回答,仅返回原文 |
| Refine | ✅ | 串行迭代精炼 | ✅全局融合 | 长文档综合问答效果好 | 串行慢,易超出上下文限制 |
| CompactAndRefine(Compact) | ✅ | 先压缩 + 串行精炼 | ✅全局融合 | 自动控token,多文档融合强 | 串行推理耗时较长 |
| Accumulate | ✅ | 并行独立问答 | ❌不融合 | 并发速度快,分块独立答案 | 无统一结论,不支持流式 |
| CompactAndAccumulate | ✅ | 先压缩 + 并行问答 | ❌不融合 | 并发+自动token压缩 | 无全局综合答案,不支持流式 |
| SimpleSummarize | ✅ | 一次性单轮调用 | ✅一次性融合 | 仅1次LLM调用,速度快 | 超长文本会截断丢失信息 |
| TreeSummarize | ✅ | 自底向上树形递归 | ✅逐层融合 | 适合超大文档汇总,调用次数logN | 多轮调用,延迟高 |
| NoText | ❌ | 仅检索 | 无 | 跳过LLM,用于评估检索 | 不生成答案 |
| Generation | ✅ | 直接LLM生成 | ❌不使用上下文 | 原生大模型问答 | 不使用知识库,容易幻觉 |
2.1 ContextOnly
说明:最简单的合成器,不调用LLM,直接拼接检索返回的文本块原文,不做任何总结、提炼。
- 核心逻辑:将召回的文本块用换行符拼接直接返回;多模态场景下从
ChatMessage提取文本内容再拼接。 - 优点:无
LLM调用开销,响应速度极快;适合调试检索链路,快速验证召回节点是否符合预期。 - 缺点:不会基于用户问题生成摘要/回答,原样输出原始上下文。
- 适用场景:
RAG检索调试、需要直接返回文档原文引用的业务。
2.2 Refine
说明:串行迭代式答案精炼合成器。逐份读取文本块,不断更新、优化答案。
- 核心逻辑:
- 使用第一个文本块 + 用户问题,
LLM生成初始答案; - 后续每一个文本块,传入【原始问题 + 上一轮答案 + 当前文本块】,让
LLM对答案进行精炼更新; - 遍历全部
chunk后输出最终融合答案。
- 使用第一个文本块 + 用户问题,
- 优点:可以融合多段文档信息,长文档综合问答效果好。
- 缺点:串行执行,
chunk数量多时调用LLM次数多、耗时较长;未做token自动压缩,容易触发上下文超限。 - 适用场景:需要综合多个文档片段信息、输出统一结论的问答。
2.3 CompactAndRefine(别名Compact)
说明:Refine的增强版,增加前置repack压缩能力,解决 Refine 容易上下文溢出的问题。
- 核心逻辑:检索得到原始
chunk后,先根据 LLM 上下文窗口自动重组打包文本块,控制prompt总token不超限,再进入Refine串行精炼流程。 - 压缩规则:取
QA模板、refine模板中token占用更大的模板作为基准,prompt_helper.repack合并相邻文本块。同时支持普通文本块与多模态ChatMessage块。 - 优点:继承
Refine多文档融合能力;自动控制token,规避上下文超限报错。 - 缺点:依旧串行执行,多
chunk场景推理速度慢。 - 适用场景:长文档综合问答、
LLM上下文窗口有限,是LlamaIndex最常用的默认合成器。
2.4 Accumulate
说明:并行独立问答合成器,每个文本块单独针对用户问题调用LLM,互不干扰。
- 核心逻辑:对每一个检索
chunk,独立执行一次问答;可开启异步并发批量调用LLM;最后将所有chunk的回答带序号拼接输出。
输出示例:
Response 1: 第一段文档的回答
---------------------
Response 2: 第二段文档的回答
- 优点:支持并发请求,推理速度优于
Refine;各文档答案独立,便于单独查看每一段文档对应的结论。 - 缺点:不会跨chunk融合信息,无法产出统一综合结论;不支持流式输出。
- 适用场景:批量信息抽取,每段文档信息独立,不需要合并总结。
Accumulate 构造参数:
llm:用于问答的大模型实例callback_manager:回调管理器,用于埋点、日志记录prompt_helper:文本Prompt工具,负责token计算、repack打包chat_prompt_helper:ChatMessage专用Prompt工具,多模态场景使用text_qa_template:文本问答Prompt模板chat_content_qa_template:对话消息问答Prompt模板output_cls:Pydantic模型,开启结构化输出streaming:是否启用流式输出;Accumulate不支持流式,开启会直接抛异常use_async:是否启用异步并发执行LLM调用multimodal:是否开启多模态模式
2.5 CompactAndAccumulate(别名CompactAccumulate)
说明:Accumulate增强版,在并行问答前增加repack前置压缩。
- 核心逻辑:原始检索
chunk→repack重组压缩(保证不超过LLM窗口)→ 交给Accumulate并行问答。 - 优点:保留
Accumulate并发能力,同时自动控制prompt长度,避免token溢出。 - 缺点:依旧不会全局融合多文档信息,无统一总结;不支持流式输出。
- 适用场景:大量文档并行信息抽取,
LLM上下文窗口受限场景。
2.6 SimpleSummarize
说明:单轮摘要合成器,一次性把全部文本块塞进同一个Prompt,调用一次LLM完成总结。
- 核心逻辑:将所有召回chunk合并,截断超长内容,一次性送入
LLM,只执行1次LLM调用,直接返回摘要。 - 优点:
LLM仅调用一次,推理速度快。 - 缺点:超长文档会被截断,丢失细节;上下文窗口不足时损失严重。
- 适用场景:短文档快速摘要、文档概览。
2.7 TreeSummarize
说明:树形递归摘要合成器,自底向上逐层合并总结,类似归并。
- 核心逻辑:
- 将chunk分组,每组单独调用
LLM生成小组摘要; - 将上一轮生成的摘要当作新
chunk,继续分组、总结; - 不断递归合并直到只剩
1条最终答案。
- 将chunk分组,每组单独调用
- 优点:长文档摘要能力强,
LLM调用次数是对数级别;适合海量文档汇总。 - 缺点:逻辑复杂,多轮
LLM调用,延迟较高;对摘要质量敏感。 - 适用场景:海量长文档的全局总结、文献综述。
2.8 NoText
说明:只执行检索,完全跳过 LLM 合成阶段。
- 核心逻辑:检索器召回节点,直接返回
source_nodes,不调用任何LLM,不生成文本答案。 - 优点:无
LLM开销,用来单独评估检索质量。 - 缺点:没有回答文本。
- 适用场景:检索效果评估、只需要获取引用节点列表。
2.9 Generation
说明:忽略检索上下文,直接使用 LLM根据用户提问生成回答。
- 核心逻辑:完全不传入检索
chunk,直接把用户query丢给LLM生成答案。 - 优点:简单,直接大模型原生问答。
- 缺点:完全不使用知识库,会产生幻觉,不属于标准
RAG。 - 适用场景:纯
LLM兜底,对比有无知识库的效果。
3. 创建方式
3.1 统一工厂函数
统一工厂函数 get_response_synthesizer()(最常用),一个入口按 response_mode 分发到所有内置实现。
代码示例:
from llama_index.core import get_response_synthesizer

response_synthesizer = get_response_synthesizer(
    response_mode="refine",          # 也可传 ResponseMode 枚举
    text_qa_template=...,            # 各阶段提示词
    refine_template=...,
    use_async=False,                 # 仅 tree_summarize 生效
    streaming=False,
    structured_answer_filtering=False,
)
3.2 直接实例化具体类
需要某个类特有参数时用这条,工厂函数虽然也能透传,但直接实例化更直观。
代码示例:
from llama_index.core.response_synthesizers import TreeSummarize
summarizer = TreeSummarize(verbose=True, summary_template=qa_prompt)
可实例化的类:Refine、CompactAndRefine(默认)、TreeSummarize、SimpleSummarize、Accumulate、Generation(纯生成,不引用上下文)等。
3.3 完全自定义
所有内置合成器都继承 BaseSynthesizer ,自定义只需实现 get_response() 和 aget_response() 两个抽象方法:接收查询和文本块,返回字符串(或流式生成器)。
代码示例:
from llama_index.core import Settings
from abc import ABC
from typing import Optional, Sequence, Any


class BaseSynthesizer(ABC):
    """回答构建基类"""

    def __init__(
        self,
        llm: Optional[LLM] = None,
        streaming: bool = False,
    ) -> None:
        """初始化参数"""
        self._llm = llm or Settings.llm
        self._callback_manager = Settings.callback_manager
        self._streaming = streaming

    @abstractmethod
    def get_response(
        self,
        query_str: str,
        text_chunks: Sequence[str],
        **response_kwargs: Any,
    ) -> RESPONSE_TEXT_TYPE:
        """获取回答(同步)"""
        ...

    @abstractmethod
    async def aget_response(
        self,
        query_str: str,
        text_chunks: Sequence[str],
        **response_kwargs: Any,
    ) -> RESPONSE_TEXT_TYPE:
        """获取回答(异步)"""
        ...
智能硬件社区聚焦AI智能硬件技术生态,汇聚嵌入式AI、物联网硬件开发者,打造交流分享平台,同步全国赛事资讯、开展 OPC 核心人才招募,助力技术落地与开发者成长。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)